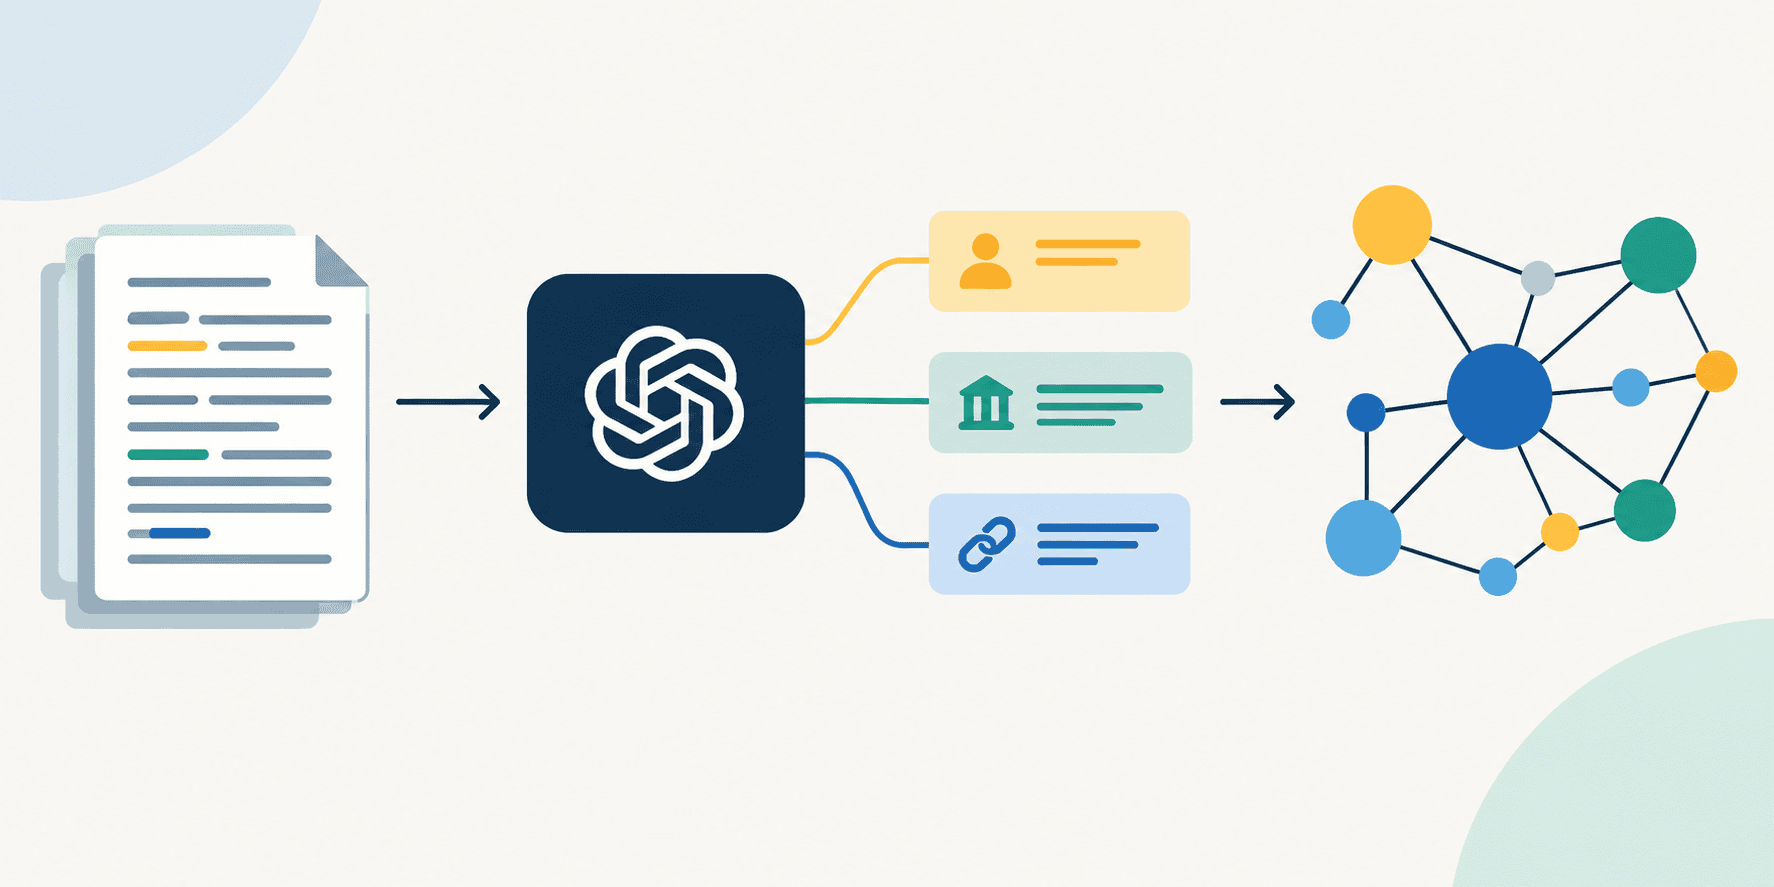

自动化知识图谱填充:使用LLM从非结构化文本中抽取实体与三元组
内容提要
本文介绍用本地LLM从非结构化文本自动抽取知识图谱:通过Ollama运行Llama 3.2,采用少样本提示和JSON输出模式,将维基百科文本转为SPOC四元组(主语、谓语、宾语、上下文),并载入QuadStore图数据库,供Graph-RAG检索,以减少幻觉。
延伸解读
SPOC四元组:为事实添加上下文
文章采用SPOC(主语-谓语-宾语-上下文)四元组,在传统RDF三元组基础上增加上下文维度。例如,三元组("LeBron James", "plays_for", "Lakers")扩展为("LeBron James", "plays_for", "Lakers", "NBA_2023_Roster")。上下文用于追踪事实来源和真实性,在Graph-RAG中可帮助解决检索冲突,提升事实准确性。
本地LLM抽取流程的关键设计
使用Ollama运行Llama 3.2,通过少样本提示和JSON输出模式确保结构化输出。提示中要求模型返回包含"facts"键的JSON对象,并设置temperature=0.0以降低随机性。后处理时统一键名大小写,并添加回退逻辑:若未找到"facts"键,则取第一个列表值。这些设计提高了抽取的鲁棒性。
从抽取到图数据库:轻量级QuadStore
文章实现了一个简单的QuadStore类,用列表存储四元组,并提供add和query方法。抽取出的四元组可直接加载到QuadStore中,供Graph-RAG检索。这种轻量级实现便于演示,但未涉及持久化、索引或并发处理,适用于小规模知识图谱构建。
实际效果与局限性
以艾伦·图灵的维基百科摘要为例,从两段文本中抽取了约11条事实,但数量可能因LLM的非确定性而略有波动。抽取质量受提示设计和模型能力影响,且未涉及实体消歧、关系规范化等复杂问题。该方法适合快速构建原型,但在生产环境中需进一步优化。
Q&A
如何用本地LLM从非结构化文本中自动抽取知识图谱?
使用Ollama运行Llama 3.2模型,通过少样本提示和JSON输出模式,从文本中抽取SPOC四元组(主语、谓语、宾语、上下文),然后载入QuadStore图数据库。
SPOC四元组和传统的RDF三元组有什么区别?
SPOC四元组在传统RDF三元组(主语、谓语、宾语)基础上增加了第四个维度:上下文,用于追踪事实来源和真实性。例如,("LeBron James", "plays_for", "Lakers") 变为 ("LeBron James", "plays_for", "Lakers", "NBA_2023_Roster")。
如何设置Ollama和Llama 3.2来运行本地LLM?
在Google Colab中,可以通过命令安装Ollama并拉取Llama 3.2模型;在本地Python IDE中,需要手动安装Ollama并拉取模型。然后使用subprocess启动Ollama服务器并拉取模型。
如何设计提示词让LLM输出结构化的JSON数据?
提示词要求LLM输出一个包含"facts"键的JSON对象,其值为对象数组,每个对象包含subject、predicate、object。使用少样本示例展示格式,并设置format参数为"json",temperature为0.0以确保确定性输出。
抽取出的四元组如何加载到QuadStore图数据库中?
首先创建一个QuadStore实例,然后遍历抽取出的四元组列表,调用add方法将每个四元组的主语、谓语、宾语和上下文添加到数据库中。
这个自动化知识图谱填充方法如何帮助减少LLM幻觉?
通过从非结构化文本中抽取事实并构建知识图谱,可以为Graph-RAG检索提供确定性的、基于事实的知识,从而减少LLM生成中的幻觉问题。
