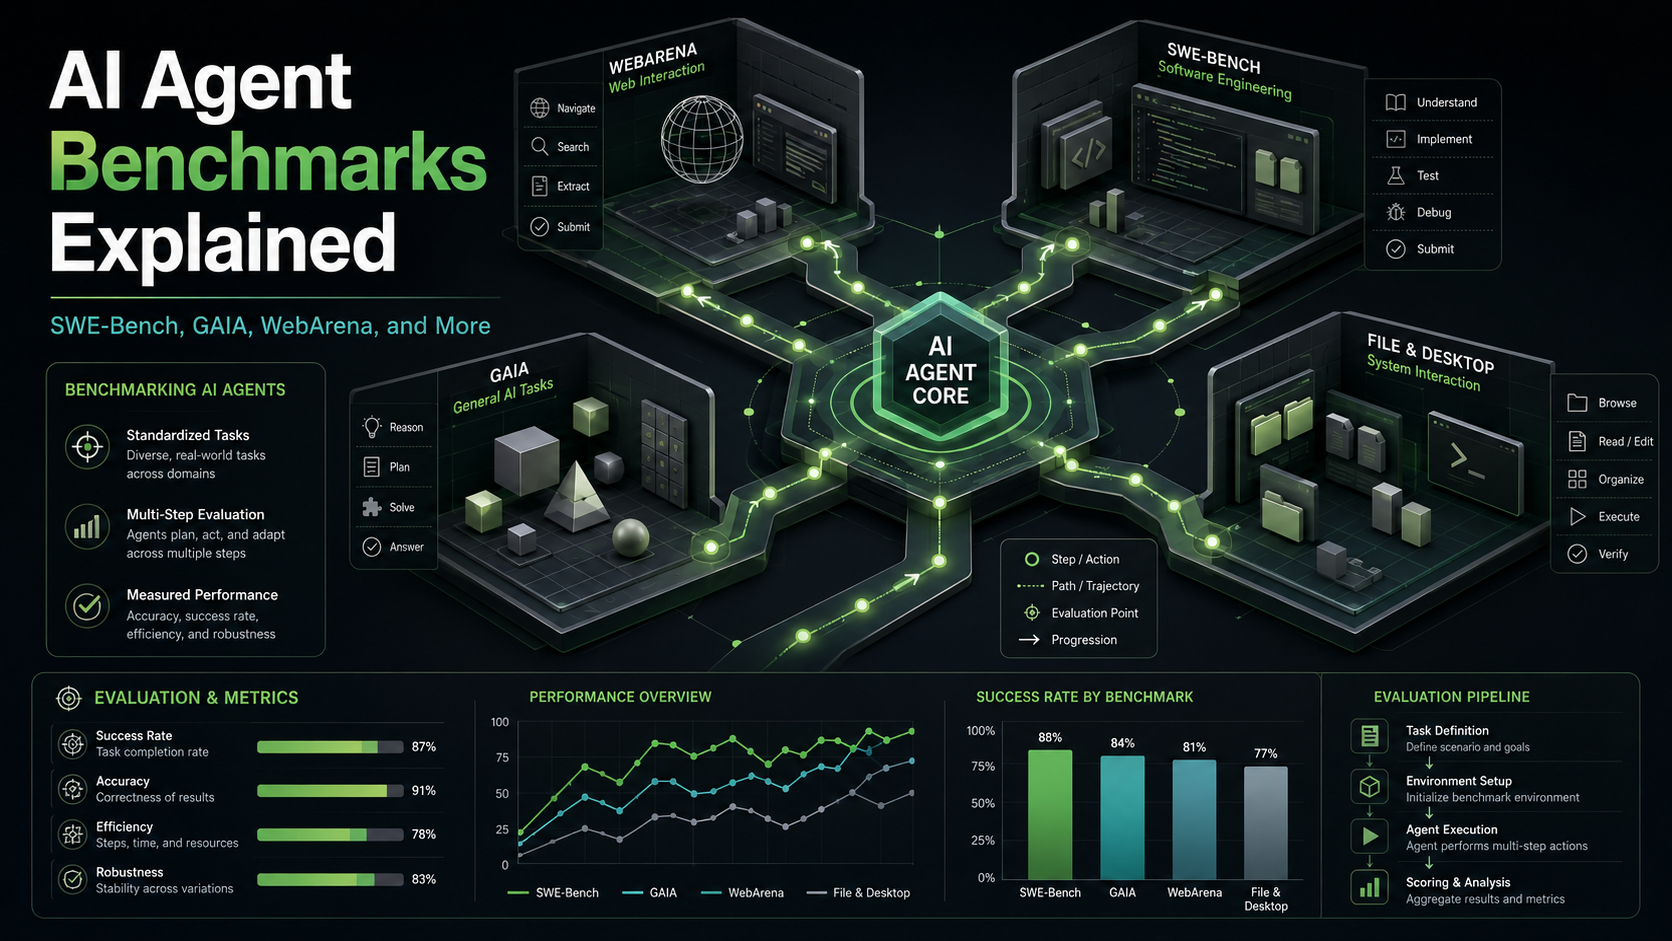

AI智能体基准测试详解:SWE-Bench、GAIA、WebArena等
内容提要
AI智能体基准测试各有侧重:SWE-Bench测代码修复,GAIA测多工具推理,WebArena测网页操作,OSWorld测桌面任务。但榜单忽略成本、延迟、安全与错误恢复,且存在数据污染和自动评分偏差。应将其作为初筛信号,再结合自身业务构建私有评测,才能可靠判断智能体能否真正胜任生产任务。
延伸解读
智能体基准测试与模型基准测试的本质区别
传统基准如MMLU或HumanEval只测试单轮问答,而智能体基准要求模型在多步环境中采取行动、使用工具并适应变化。失败可能表现为循环卡住、流程中断或任务半途而废。这种区别意味着,模型在传统基准上的高分并不能保证其能胜任真实工作流程。
各基准测试的独特价值与固有局限
SWE-Bench通过单元测试验证代码修复,但无法评估代码质量或安全性;GAIA测试多工具推理,但任务通常有单一正确答案;WebArena评估网页操作,但存在数据污染风险;OSWorld模拟桌面任务,但高度依赖基础设施稳定性。每个基准只捕捉能力的一个侧面。
榜单之外的关键生产指标
排行榜通常忽略成本、延迟、安全边界和错误恢复。一个高分智能体可能消耗大量token,而另一个稍低分的智能体可能更高效。此外,自动评分可能被自信但错误的答案欺骗,导致分数虚高。这些缺失的维度恰恰是生产部署中最关键的。
将公开基准作为初筛,构建私有评测
公开基准可用于排除明显不合适的方案,但不能预测生产表现。最可靠的方法是基于自身工作流构建私有评测,例如用实际合同测试合同摘要任务。只有在你关心的任务上、在近似真实环境的条件下测试,才能可靠判断智能体是否胜任。
Q&A
AI智能体基准测试和传统模型基准测试(如MMLU)有什么区别?
传统基准测试(如MMLU、HumanEval)只评估模型单轮生成正确回答的能力,类似于书面考试。而智能体基准测试将模型置于环境中,要求其执行多步动作、使用外部工具、适应错误,并最终达成无法通过单次回答实现的目标,更像真实的工作模拟。失败可能表现为陷入循环、工作流中断或任务半途而废,而不仅仅是答案错误。
SWE-Bench和SWE-Bench Verified主要测试什么?有什么局限性?
SWE-Bench测试智能体解决真实GitHub问题的能力,要求生成代码补丁并通过仓库的单元测试。SWE-Bench Verified是经过人工验证的子集,确保任务可解且测试准确。局限性在于:通过单元测试不等于代码质量好,可能引入内存泄漏、安全漏洞或只解决边缘情况而破坏其他功能。它只衡量是否满足特定自动化标准,不评估代码质量、可维护性或安全性。
GAIA基准测试评估智能体的哪些能力?它的设计特点是什么?
GAIA(通用AI助手)评估智能体跨多种工具和模态进行推理、回答复杂问题的能力。任务可能要求查找文档、与网络信息交叉引用、执行计算并综合答案。其特点是问题对人类(有互联网)来说很简单,但对当前AI系统却很难,测试智能体能否协调网页浏览、文件处理和多步推理而不丢失目标。局限是任务通常有单一正确答案,而真实助手工作流更混乱、目标会变化、指令模糊。
WebArena和BrowserGym如何测试网页操作智能体?存在什么潜在问题?
WebArena通过沙盒化的电商、CMS、论坛等网站,测试智能体像人类一样点击按钮、填写表单、导航菜单并解读页面内容来完成多步任务。BrowserGym将其扩展为模块化框架,允许接入不同环境和评估标准。潜在问题是数据污染:许多原始任务可能已出现在新模型的训练数据中,高分可能反映模式匹配而非真实能力,且研究者很少披露污染检查情况。
OSWorld基准测试有什么特点?为什么说它最脆弱?
OSWorld将智能体置于沙盒桌面操作系统中,完成文件操作、GUI应用导航、系统设置调整等多程序协调任务,最接近人类操作电脑的方式,范围最广。但它也最脆弱:如果模拟操作系统崩溃、显示渲染错误或应用行为异常,即使智能体推理正确也会失败。因此其分数高度依赖评估基础设施的稳定性,而不仅仅是模型能力。
AI智能体排行榜通常忽略哪些关键指标?
排行榜通常忽略:1) 成本和效率:高分可能靠大量token和API调用堆砌,不反映计算成本;2) 延迟:任务耗时长短影响用户体验和基础设施成本,但无排名;3) 安全与边界遵循:是否尊重权限、拒绝破坏性操作、在高风险决策时请求澄清;4) 错误恢复:遇到断链、意外界面或子进程失败时的应对能力;5) 自动评分噪声:用语言模型评分可能被自信但错误的答案欺骗,虚高分数。
如何正确使用公开基准测试来评估AI智能体?
应将公开基准测试作为初步筛选工具,用于排除明显不适合的架构(如SWE-Bench近零分的不适合软件工程),并发现值得进一步调查的候选。但不要将其分数视为生产性能的预测。最可靠的方法是:先用公开基准做初筛,然后围绕自身具体工作流构建私有评估,在与生产环境近似的条件下测试你关心的任务,这才是唯一能告诉你实际所需信息的基准。
