


Anthropic如何重新设计源码控制系统
内容提要
Anthropic因AI生成代码激增导致Git基础设施不堪重负,遂自研源码控制系统Scion。Scion采用客户端-服务器架构,由服务器集中处理历史查询、差异计算与提交,客户端仅缓存所需对象。变更以changeset记录,元数据存于Spanner,文件内容存于云存储。系统利用内容寻址实现不可变对象与多级共享缓存,大幅减少重复传输与计算,支撑每日数万次合并与数千万次检出。
延伸解读
Git 的本地独立性为何成为负担
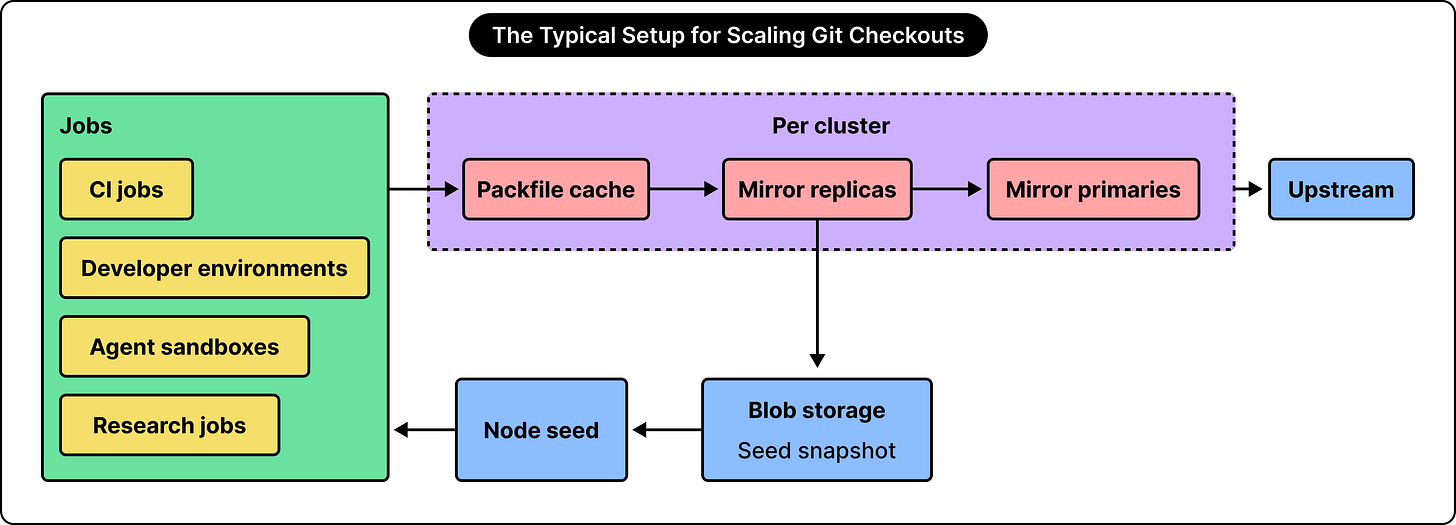
Git 设计上让每个克隆都是自包含仓库,本地即可查历史、算差异、建提交。但 Anthropic 的客户端大多是自动化任务和智能体,本就依赖网络服务,本地独立性价值不大,反而导致重复传输、存储和维护成本。团队曾用浅克隆、稀疏检出、数百个内部镜像等缓解,但镜像同步和种子过期问题随合并频率激增而恶化。
客户端-服务器不对称的实际取舍
Scion 把历史查询、差异计算、提交创建、合并与变基都交给服务器,客户端只维护有限缓存并准备磁盘文件。好处是客户端无需组装完整历史即可回答 blame 等问题,提交也无需单独 push。代价是强依赖服务可用性与网络连接,一旦服务不可达,客户端能做的操作非常有限。
内容寻址如何简化缓存
Scion 用内容哈希标识对象,相同内容永远对应同一 ID,因此缓存对象不可变,无需因仓库其他位置有开发活动而做新鲜度检查。这使多级缓存(节点守护进程、区域缓存、权威服务器)能安全共享对象。但可变引用如分支名 main 仍需单独处理,不能与不可变对象混为一谈。
分层缓存与故障边界
Scion 的缓存分三层:计算节点上的 scion-daemon 跨任务共享对象,区域级 scion-cache 跨节点共享,未命中才回源到权威服务器。三层使用统一的对象请求接口,目的是在区域缓存故障时,消费者不会直接压垮权威服务器。这种严格边界是规模化支撑每日数千万次检出的关键设计。
Q&A
Anthropic 为什么要自己开发源码控制系统 Scion?
因为 AI 生成代码激增,Git 基础设施不堪重负:每日合并变更从 2026 年 5 月的约 2500 次增长到 9 月的超过 30000 次,主分支历史接近 100 GB,CI 系统每天约 2500 万次检出,导致下载仓库、准备工作区等成为瓶颈。
Scion 的客户端-服务器架构是如何分工的?
服务器集中处理历史查询、差异计算、提交创建、合并与变基;客户端(scn)只维护有限缓存、准备磁盘文件、监视本地文件系统变化,并向开发者或任务提供接口。这种非对称设计让客户端无需保存完整仓库历史。
Scion 中的 changeset 是什么?它如何存储?
changeset 是变更的持久化记录,记录相对于第一个父提交的文件变化及内容引用,并包含父信息和作者详情。其元数据存储在分布式数据库 Spanner 中,压缩文件内容存放在云对象存储,根树由服务器派生而非直接存储。
Scion 如何利用内容寻址实现高效缓存?
Scion 通过哈希函数从对象内容计算标识符,使对象不可变,相同 ID 始终指向相同数据。因此缓存命中时无需检查新鲜度,可跨任务共享缓存,减少重复传输和计算。
Scion 如何扩展以支撑每日数千万次检出?
Scion 将仓库操作移至共享服务并通过 API 暴露;客户端只请求缺失的对象;采用多级缓存:节点上的 scion-daemon 在任务间共享缓存,区域级 scion-cache 跨节点共享,未命中时再访问权威服务器。各层使用统一对象请求接口,严格缓存边界防止故障扩散。
Anthropic 从构建 Scion 中总结了哪些经验?
1)小团队(7 人)也能快速开发;2)开发者仍重要,但工作转向高层系统理解和设计权衡,常需阻止 Claude 走错误路径;3)Claude 能快速编写大量代码,使 Scion 成为测试最充分、防护最完善的代码库之一;4)通过 Claude Tag 监控各组件,达到新的运维水平。
