


Google 将语音识别与语音合成全面搬上端侧:AI Edge Gallery 实现完全离线的语音交互
内容提要
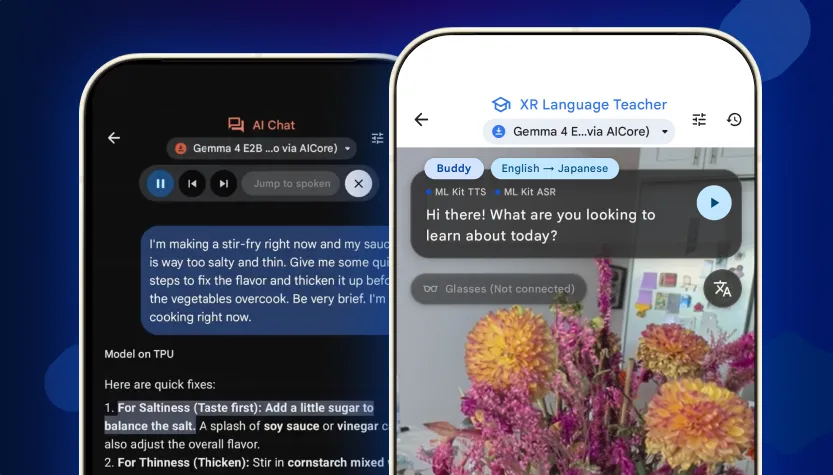
Google AI Edge Gallery 新增完全离线的端侧语音识别与合成能力,提供 Android 原生和跨平台两种集成路径。语音识别支持百余种语言,转录速度达实时10倍;语音合成首字延迟约100毫秒,速度最高达实时50倍。Gallery 还推出 XR Language Teacher 演示并开源参考代码。高性能依赖 NPU/TPU 加速,多语言清单需查官方文档。
延伸解读
两条集成路径的取舍
Android 原生路径通过 ML Kit 和 AICore 集成,应用无需打包模型,APK 体积不增加,模型可后台更新并自动获得 NPU/TPU 加速,适合追求轻量和系统级优化的 Android 应用。跨平台路径基于 MediaPipe Tasks 与 LiteRT,覆盖 iOS、macOS、Windows、Linux、Web 及智能眼镜,采用 .litertlm 单文件打包,开发者可按需下载开放权重模型,适合多端部署但需自行管理模型分发。
性能数据的适用条件
Google 公布的 ASR 转录速度达实时 10 倍、TTS 首字延迟约 100 毫秒且合成速度最高达实时 50 倍,这些指标使端侧语音延迟接近良好网络下的云端 API,且完全不依赖网络。但文章明确指出,10 倍与 50 倍的实时性能均以 NPU/TPU 加速为前提,在缺少加速器的入门级设备上,实际延迟可能明显高于公布数据,评估时需结合目标硬件。
多语言支持需先核对清单
文章提到 TTS 支持 21 个语言区域、ASR 支持 100 多种语言,但 Google 未逐一列出具体清单。对于规划多语言支持的团队,这意味着不能仅凭数量做决策,应先核对官方文档确认目标语言是否在列。此外,XR Language Teacher 演示中实现中英混说依赖结构化输出对非母语片段单独打标签,TTS 据此切换音色与口音,该机制对多语言应用有参考价值。
参考代码的实用起点
Gallery 的参考代码已在 GitHub 开源,演示了流式转录、语种切换与句子同步播放流水线。其中 AI Chat 的语音功能展示了如何在合成前剥离 Markdown 格式、跳过代码块与表格,并按句调度朗读,以避免语音合成与端侧语言模型的 token 生成争抢内存。这些细节对希望将类似流水线迁移到自有应用的开发者而言,是比性能数字更直接的工程参考。
Q&A
Google AI Edge Gallery 新增的离线语音功能具体包括哪些?
包括端侧自动语音识别(ASR)和文本转语音(TTS),可完全离线运行,无需上传音频到服务器,实现本地“听”与“说”的闭环。
开发者如何将离线语音能力集成到自己的应用中?
提供两条路径:Android 原生方案基于 ML Kit 的 GenAI Speech Recognition 和 GenAI Text-to-Speech API,通过 AICore 集成,无需打包模型;跨平台方案基于 MediaPipe Tasks 和 LiteRT,覆盖 iOS、macOS、Windows、Linux 和 Web,使用 .litertlm 格式打包模型。
端侧语音识别的性能指标如何?
支持 100 多种语言,FLEURS 数据集上词错误率(WER)为 8.0% 至 9.0%;转录速度达实时的 10 倍,处理 3 秒语音约需 300 毫秒;端到端语音翻译延迟降低 35% 至 44%。
端侧语音合成的延迟和速度怎么样?
语音起始延迟约 100 毫秒,输出 24 kHz 音频,合成速度最高可达实时的 50 倍,一段 27 秒的段落约 500 毫秒即可生成;能耗较传统自回归 TTS 模型降低 50% 以上。
XR Language Teacher 演示是如何工作的?
用户将摄像头对准物体并提问,应用流式转录问题,将语音和画面送入端侧模型(Android 上为 Gemini Nano,其他平台为 Gemma 4),以用户语言返回语音解释,并在句中穿插当地语言发音。通过结构化输出模式对非母语片段打标签,TTS 流水线在句中途切换音色和口音。
使用这些离线语音功能有哪些限制或注意事项?
TTS 支持 21 个语言区域,ASR 支持 100 多种语言,但未列出具体清单,需查官方文档;10 倍和 50 倍的实时性能均以 NPU/TPU 加速为前提,在缺少加速器的入门级设备上实际延迟可能明显更高。
