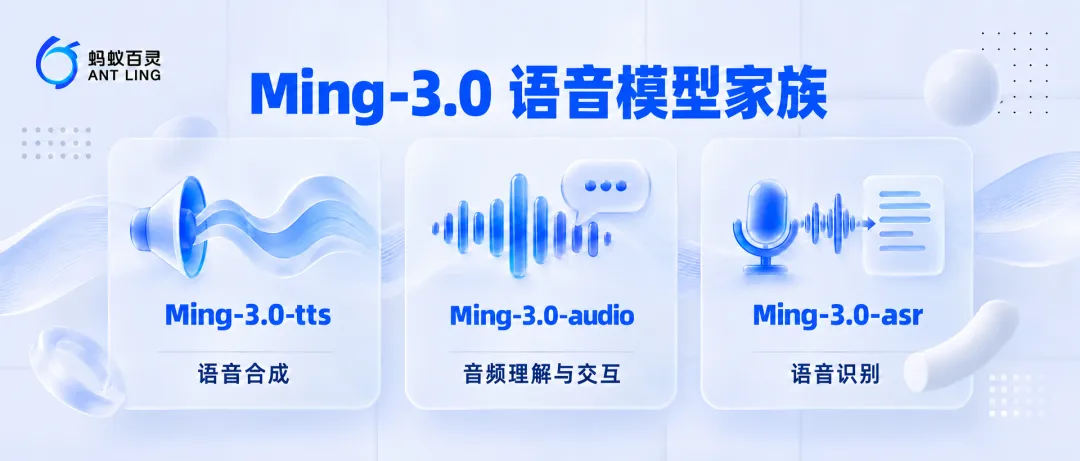
蚂蚁百灵开源Ming-3.0语音系列,共五款模型,覆盖语音合成、音频理解与对话、语音识别。TTS支持文字设定音色、导演模式调控情绪节奏及行内副语言标签,0.5B小模型表现突出;audio-flash/tiny可直接理解长音频并结构化输出,保留情绪与说话人信息;asr-tiny支持热词与上下文注入,提升口音、术语识别准确率。未来将探索Voice Agent长程复杂任务。
日本语音AI公司Kotoba的语音技术已在生成式媒体平台fal上线,开发者可直接调用三项能力:针对日语及东亚语言调优的语音识别、支持流式输出的日语语音合成,以及流式输出音频与文本的实时语音翻译。开发者无需自建模型与推理链路即可产品化落地,流式能力可缩短首字响应时间,改善实时交互体验。
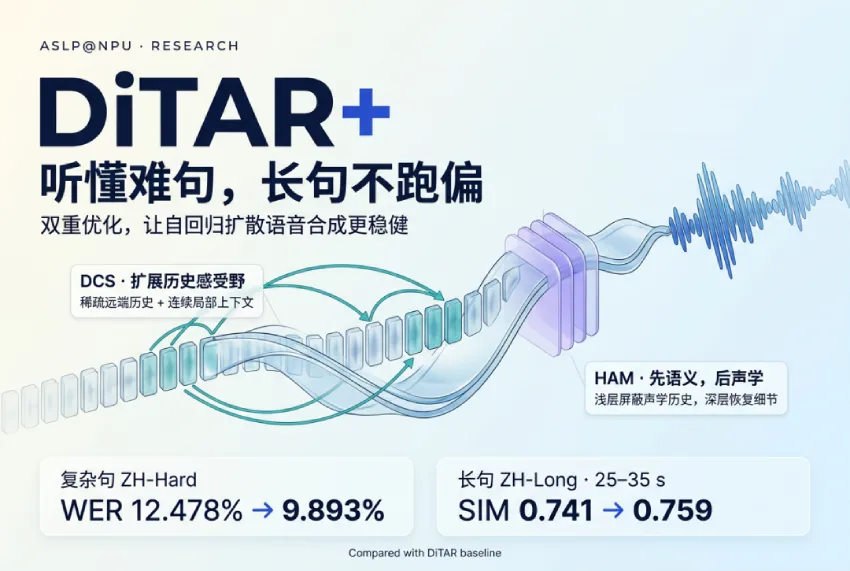
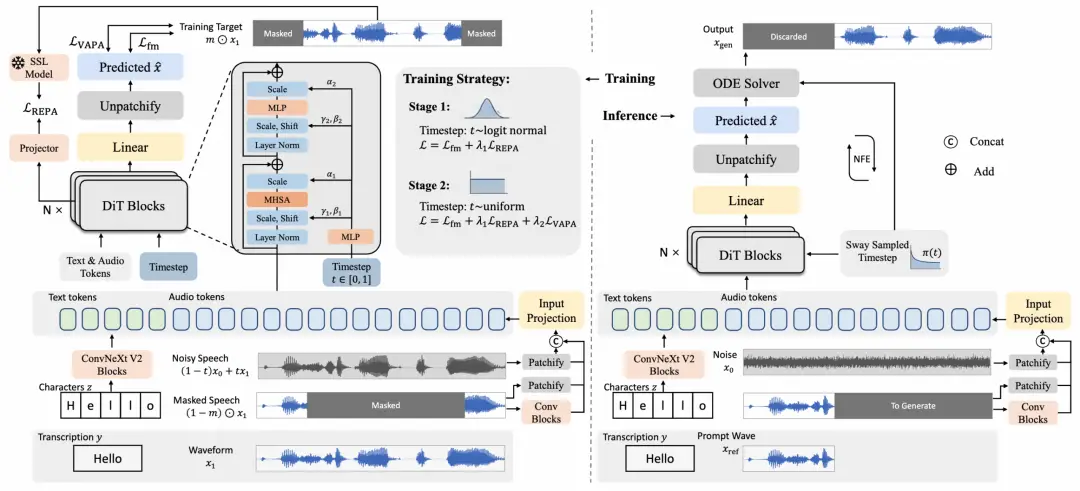
西工大ASLP@NPU提出DiTAR+,针对连续表征自回归扩散语音合成中的长语音说话人漂移和复杂文本语义幻觉问题,设计扩张上下文采样(DCS)与分层声学掩码(HAM)双重优化。DCS扩展历史感受野,HAM先语义后声学。实验显示复杂中文WER从12.478%降至9.893%,长语音WER从2.778%降至2.173%,说话人相似度提升。
介绍用 Python 调用语音合成 REST API 的实用方案:将长文本按标点切分为 800 字符以内片段,逐段生成 MP3;先写临时文件再改名落盘,避免中断产生半成品;重跑时跳过已有非空文件以实现断点续传。同时需校验音频完整性、管理文本哈希与清单、人工抽听数字和日期,并注意密钥安全与限流处理。
ZEGO实时互动AI Agent发布2.14.10版本,新增ElevenLabs TTS供应商,支持语音合成,推荐模型eleven_flash_v2_5,需配置api_key、voice_id等参数,并可设置相似度、语速、稳定性等声音参数。数字人实例新增AlphaMode参数,支持推流携带Alpha透明通道。
edgeTTS 是轻量级自托管语音合成服务,调用微软 Edge 在线朗读接口,提供 HTTP API 与 Web 工作台,支持流式传输、音色检索和 MP3 导出。长文本按段落、换行、句子智能切片,单次上限 2 万码点,并设有并发与限流保护。项目以单个 Fastify 进程托管前后端,用 Bearer Token 鉴权,官方提供 Docker 镜像,推荐配合反向代理部署。
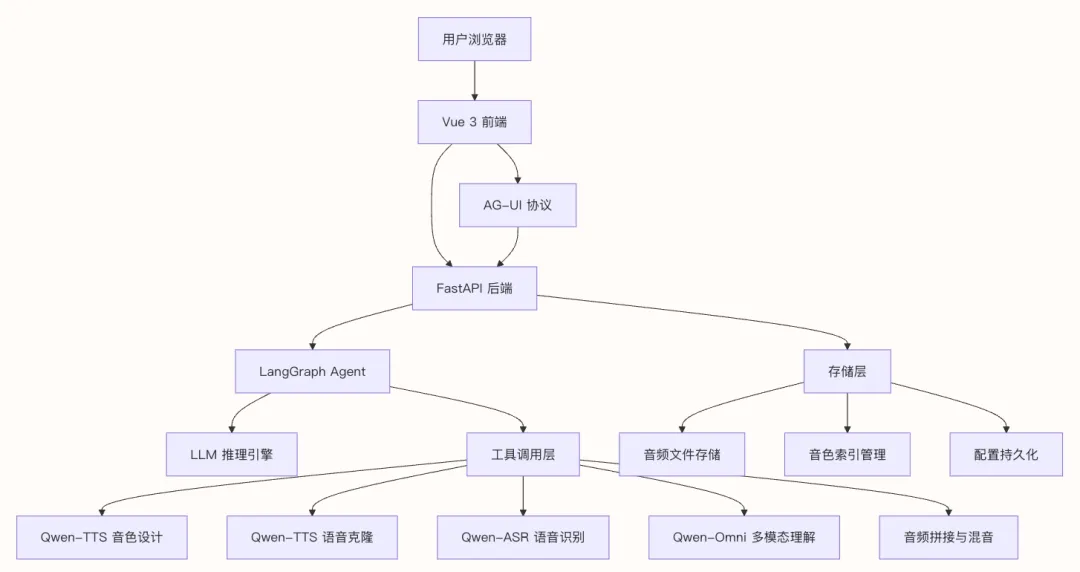
这是一个端到端智能播客制作平台,用户上传音视频后,AI自动完成内容理解、音色设计、语音合成和混音。项目采用Vue 3、FastAPI、LangGraph等技术,通过SSE和AG-UI协议实现流式通信,并集成多模态识别、音频处理工具及临时文件清理机制,实现全流程自动化。
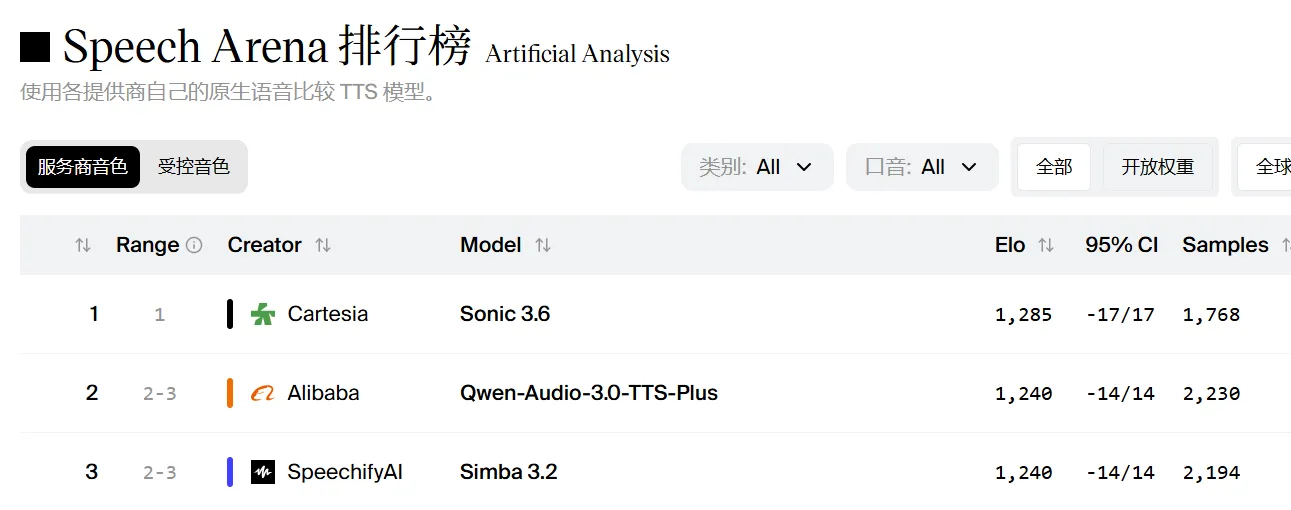
Cartesia发布Sonic-3.6文本转语音模型,在Artificial Analysis两个语音排行榜均居首,自然度提升显著。该模型基于状态空间模型,时延低于90毫秒,支持即时声音克隆、自定义发音等,以Beta版托管API提供,定价每百万字符49美元,不开放自托管权重。
该文章介绍了一个全栈AI智能播客平台项目,用户上传音视频后,AI自动完成内容理解、音色设计、语音合成和混音,实现端到端自动化。技术栈包括Vue 3前端、FastAPI后端、LangGraph Agent编排、Qwen-TTS语音合成及多模态模型,并采用AG-UI协议实现流式交互。项目还涵盖音频后期处理、配置管理和资源索引系统,旨在降低使用门槛,提供专业级播客制作体验。
B站发布IndexTTS 2.5语音合成模型,支持中英日西阿五语种零样本配音,推理速度提升2.28倍,并增强跨语言情绪还原与语速控制。团队通过降低语义帧率、换用Zipformer架构及GRPO强化学习优化性能,在情感迁移和说话人相似度上表现优异,旨在让创作者用任意声音、语言和情绪进行配音。
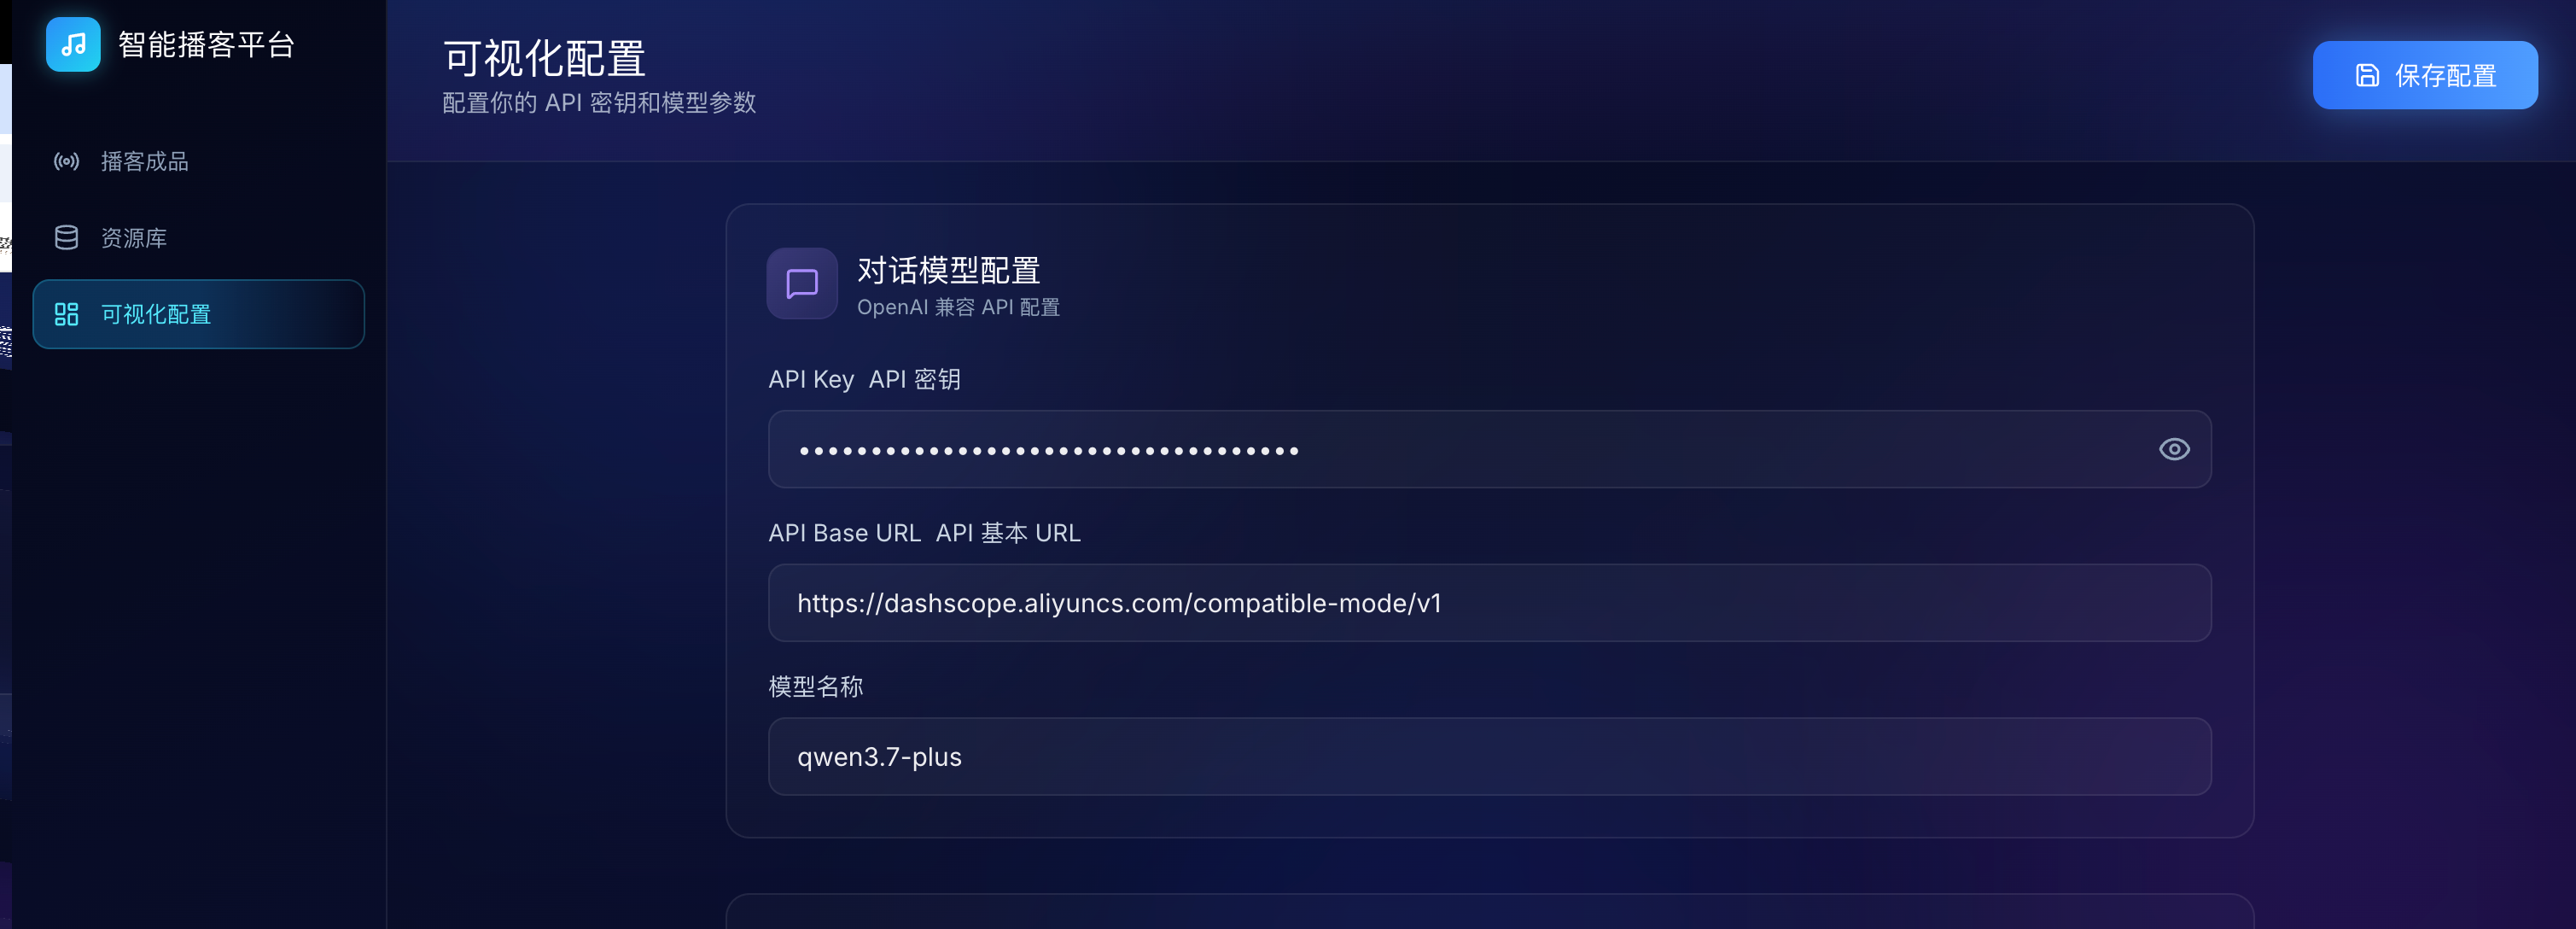
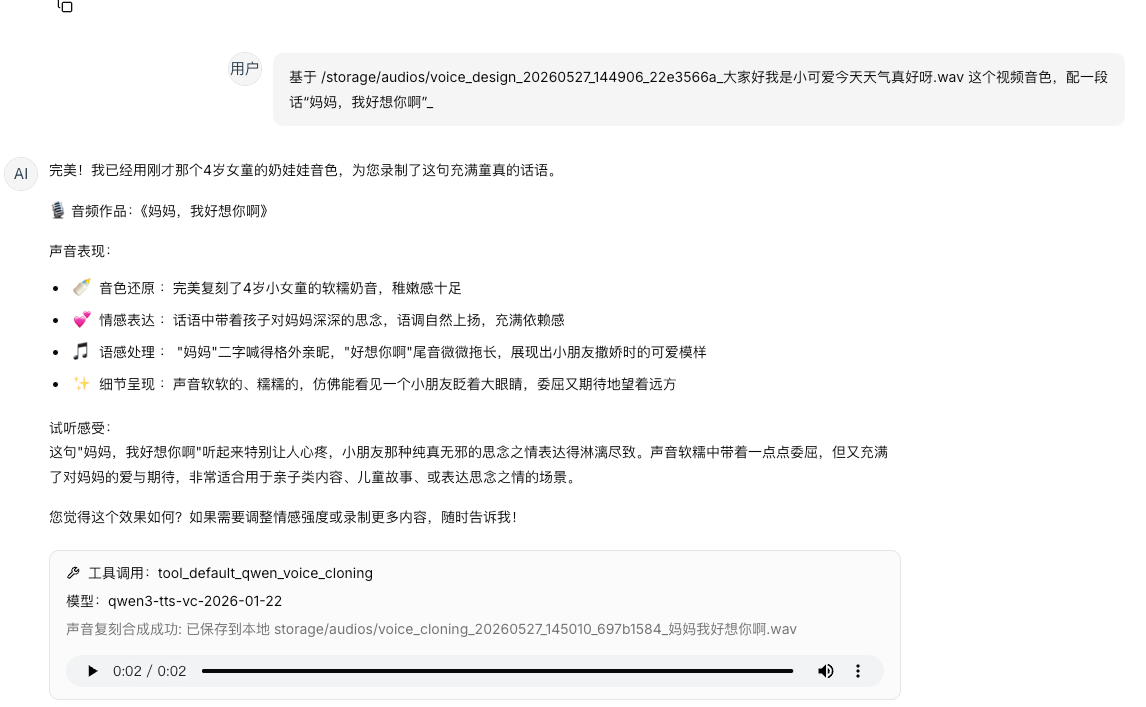
该项目是一个AI驱动的音频内容创作助手,支持通过自然语言生成定制语音、复刻音色及管理本地音频文件。前端使用Vue 3、TypeScript、Tailwind CSS和ai-elements-vue组件库,后端基于FastAPI、LangChain 1.0和LangGraph,通过SSE和AG-UI协议实现流式交互。系统具备多轮对话记忆,并调用阿里云TTS生成音频。文章还分享了开发中遇到的版本兼容和缓冲问题及解决心得。
阿里巴巴推出国内首个一站式AI语音生产力平台CosyVoice Studio,基于自研语音模型Qwen-Audio,在语音识别、实时交互和语音合成上获全球第一。平台提供语音键盘、音频内容创作和语音智能体三大功能,支持口语整理、多语言翻译、声音复刻等,满足企业、开发者和个人用户的AI语音需求。
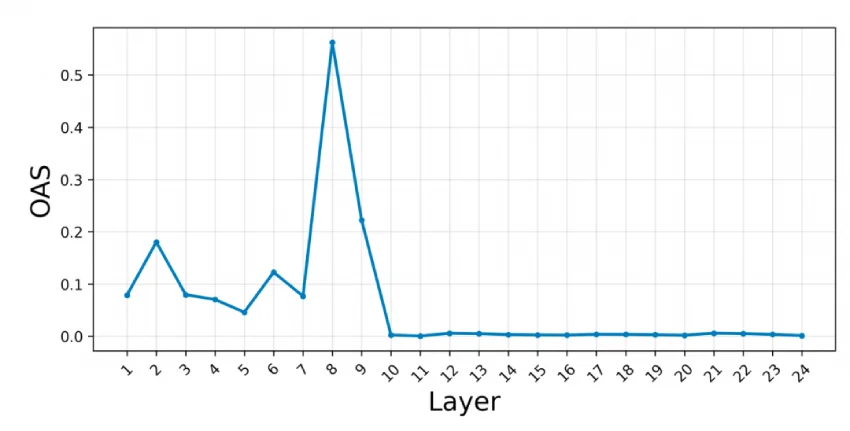
论文针对基于大语言模型的语音合成在复杂文本上出现的重复、漏读等稳定性幻觉问题,提出通过注意力引导进行优化。作者从CosyVoice 2的自注意力中发现对齐注意力头,提出最优对齐分数(OAS)评估对齐质量,并据此强化前向注意力约束;同时利用伪对齐路径构建位置思维链,通过稀疏文本Token和进度条预测显式告知模型合成位置。实验表明,该方法在困难文本上词错误率相对下降约35%,且不损害自然度和说话人相似度。
阿里巴巴发布语音合成大模型Qwen-Audio-3.0-TTS,支持细粒度标签控制、20种方言和16种语言,覆盖多语种场景。模型分Flash和Plus版本,在权威榜单夺冠,具备高鲁棒性和48kHz高质量输出,适用于实时交互和严肃创作,已开放调用。
Irodori-TTS是由开发者Aratako于2026年发布的日语语音合成项目,具有高保真音质和零样本声音克隆能力。核心模型Irodori-TTS-500M-v3支持48 kHz专业音频输出,用户只需提供3-10秒的参考音频即可精准复刻目标音色,并通过Emoji注释调节情绪和语调。
BareWave是一种全波形原生的零样本语音合成技术,能够直接从文本和参考音频生成目标说话人的波形,无需中间声学表示或独立声码器。实验结果表明,其在内容清晰度和说话人相似度上表现优异,开辟了新的语音合成方向。
AI语音开发是构建实时语音交互系统的过程,涉及语音识别、语言模型和语音合成等技术。核心链路包括用户语音输入、ASR识别、LLM理解与生成、TTS合成和实时传输。开发的难点在于降低端到端延迟,确保对话流畅。可选择全自研或使用一体化平台,以适应不同场景需求。评估方案时需关注延迟、准确率、灵活性和成本等维度。
AI实时语音技术通过语音识别、语义理解、语音合成和实时传输实现自然对话,核心在于毫秒级响应。与传统技术相比,AI实时语音不仅理解字面意思,还能捕捉情绪,提升交流质量。未来,随着技术进步,AI语音系统将更加人性化,但仍需长期投入和精细化开发。
AI对话开发结合语音识别、大语言模型和语音合成,能够与用户自然交流,广泛应用于智能客服、AI陪伴和在线教育等领域。与传统聊天机器人不同,AI对话能够理解上下文和处理开放式问题。核心技术包括ASR、LLM、TTS和RTC,语音对话对延迟要求更高。建议从智能客服入手,采用一体化方案以降低工程复杂度。
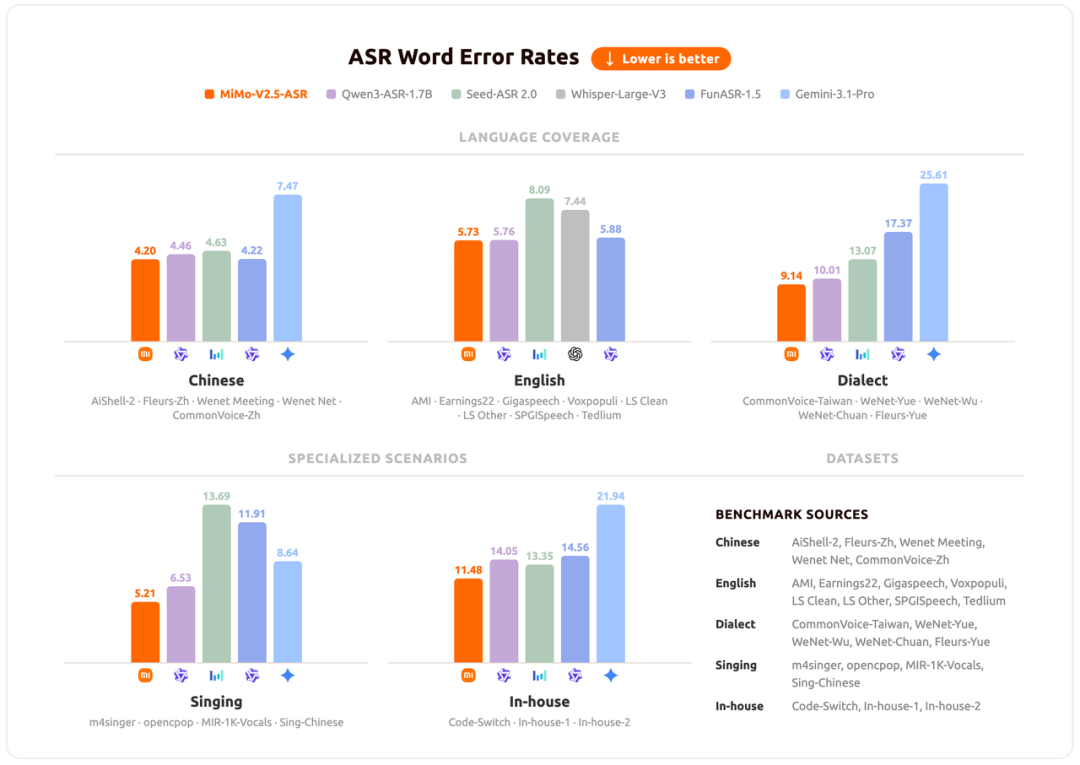
MiMo-V2.5系列语音模型实现了从简单听读到精准理解与灵活表达的转变,支持语音识别与合成,能够在复杂场景中高效交互。该模型根据自然语言指令生成多样音色,提升语音表达的情感与细腻度,尤其在多种语言和噪音环境中表现优异,确保准确转写,推动语音技术的发展。
完成下面两步后,将自动完成登录并继续当前操作。