
NCMMSC 2026 | DiTAR+:针对自回归扩散TTS模型的双重优化
内容提要
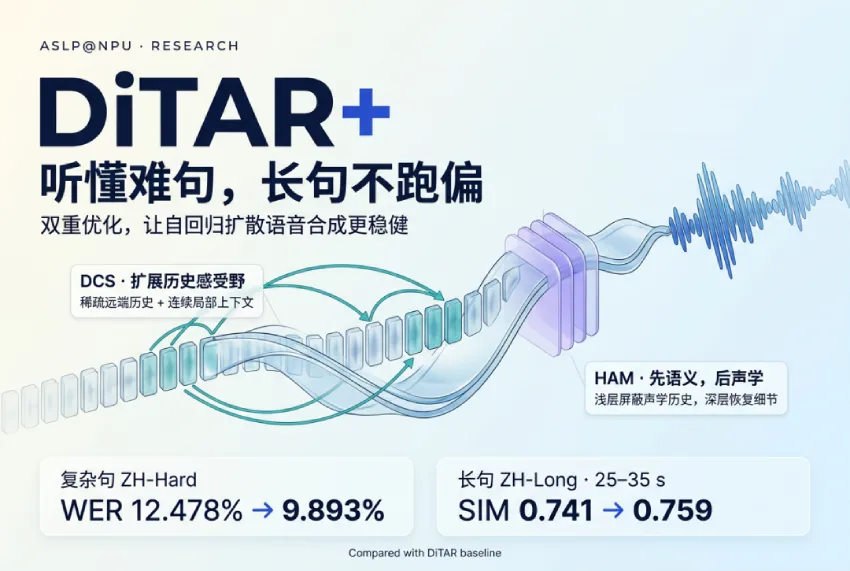
西工大ASLP@NPU提出DiTAR+,针对连续表征自回归扩散语音合成中的长语音说话人漂移和复杂文本语义幻觉问题,设计扩张上下文采样(DCS)与分层声学掩码(HAM)双重优化。DCS扩展历史感受野,HAM先语义后声学。实验显示复杂中文WER从12.478%降至9.893%,长语音WER从2.778%降至2.173%,说话人相似度提升。
延伸解读
连续表征TTS的稳定性挑战
连续表征语音合成能保留更丰富的韵律和音色细节,但自回归扩散模型在长文本或复杂语句中容易出现说话人漂移、重复、漏读和语义幻觉。DiTAR+针对这些解码稳定性问题,提出双重优化方案,旨在提升连续表征零样本语音合成的鲁棒性。
DCS与HAM的互补机制
扩张上下文采样(DCS)通过稀疏采样远距离历史patch,在保持时间连续性的同时扩大感受野,缓解长语音中的误差累积和说话人漂移。分层声学掩码(HAM)则在浅层屏蔽历史声学信息,迫使模型先依赖语义条件,深层再恢复声学细节,从而抑制声学捷径导致的语义幻觉。两者分别从长程建模和语义-声学解耦角度互补。
实验效果与数据支撑
在复杂中文测试集ZH-Hard上,DiTAR+将WER从12.478%降至9.893%;在长语音ZH-Long上,WER从2.778%降至2.173%,说话人相似度从0.741提升至0.759。主观评价中,DiTAR+取得最高的自然度MOS(3.71)和相似度MOS(3.58)。消融实验显示,DCS主要改善长程稳定性,HAM主要提升复杂文本鲁棒性,而简单重排会破坏时间先验,导致性能恶化。
实际应用中的注意点
DiTAR+的参数无关设计使其易于集成到现有自回归扩散TTS框架中,但需注意:DCS要求严格保持物理时间顺序,简单重排会显著降低性能;HAM的分层掩码策略需根据网络深度调整。此外,实验基于Emilia数据集和特定测试集,实际部署时可能需针对领域数据微调。
Q&A
DiTAR+ 是什么?它主要解决什么问题?
DiTAR+ 是西工大 ASLP@NPU 提出的双重优化框架,针对连续表征自回归扩散语音合成中的解码稳定性问题,解决长语音说话人漂移和复杂文本语义幻觉等不稳定因素。
DiTAR+ 中的 DCS 和 HAM 分别是什么?它们的作用是什么?
DCS 是扩张上下文采样,通过保留连续局部窗口并以固定步长从更远历史位置稀疏采样 patch,扩展宏观历史感受野,减少长语音中的误差累积和说话人漂移。HAM 是分层声学掩码,根据 LocDiT 网络深度动态控制历史声学上下文的可见性,在浅层强制模型依赖语义条件建立内容对齐,深层再恢复声学细节,从而抑制声学捷径,缓解复杂语句中的重复、漏读、错读等问题。
DiTAR+ 在复杂中文和长语音合成上的效果如何?
在复杂中文测试集 ZH-Hard 上,WER 从 12.478% 降至 9.893%;在 25–35 秒长语音测试集 ZH-Long 上,WER 从 2.778% 降至 2.173%,说话人相似度 SIM 从 0.741 提升至 0.759。主观评价中,DiTAR+ 取得最高的自然度 MOS(3.71)和说话人相似度 MOS(3.58)。
DiTAR+ 的消融实验验证了 DCS 和 HAM 各自有什么贡献?
单独加入 DCS 后,ZH-Long 的 WER 降至 2.165%,SIM 提升至 0.757,主要改善长程稳定性,减缓长语音后半段的说话人相似度衰减。单独加入 HAM 后,ZH-Hard 的 WER 降至 9.889%,SIM 提升至 0.700,主要改善复杂文本鲁棒性,促使模型更充分地遵循语义条件。两者互补。
为什么不能简单重排连续语音 latent 来扩大上下文?
因为简单重排(如 naive Skip)会破坏连续 latent 的时间先验。消融实验显示,采用 naive Skip 重排后,ZH-Hard 与 ZH-Long 的 WER 分别恶化至 16.231% 和 5.105%,说明扩大上下文的同时必须严格保护连续语音表示的物理时间顺序。
DiTAR+ 在抑制失控循环和语义幻觉方面有什么具体案例?
在一条复杂测试语句上,标准 DiTAR 陷入持续复制历史声学模式的失控循环,生成时长异常拉长至 25.5 秒,WER 高达 52%。引入 HAM 后,DiTAR+ 能够遵循语义条件,在 14.0 秒处正常结束生成,并将该样例的 WER 降至 6%。
