Inception 的 Mercury 3 已上线 AI Gateway,发布期五折。该模型采用扩散方式并行生成文本,速度超过每秒 1000 token,推理能力增强,适合浏览器代理、实时搜索、互动教育、客服等低延迟场景,支持 100 万 token 上下文。可通过 AI SDK 或 Chat Completions 调用,模型名为 inception/mercury-3,也可在 Claude Code、Codex、Cursor 等编码代理中使用。AI Gateway 提供统一 API、用量与成本追踪、重试与故障转移,无加价和平台费。
研究团队首次从头预训练三模态掩码扩散模型,统一处理文本、图文和音频文本数据,系统分析多模态缩放规律、模态混合比例、噪声调度和批大小影响,提出基于随机微分方程的重参数化方法解耦物理与逻辑批大小,在30亿参数、6.4万亿token规模上于文本生成、文生图和文生语音任务中表现优异。
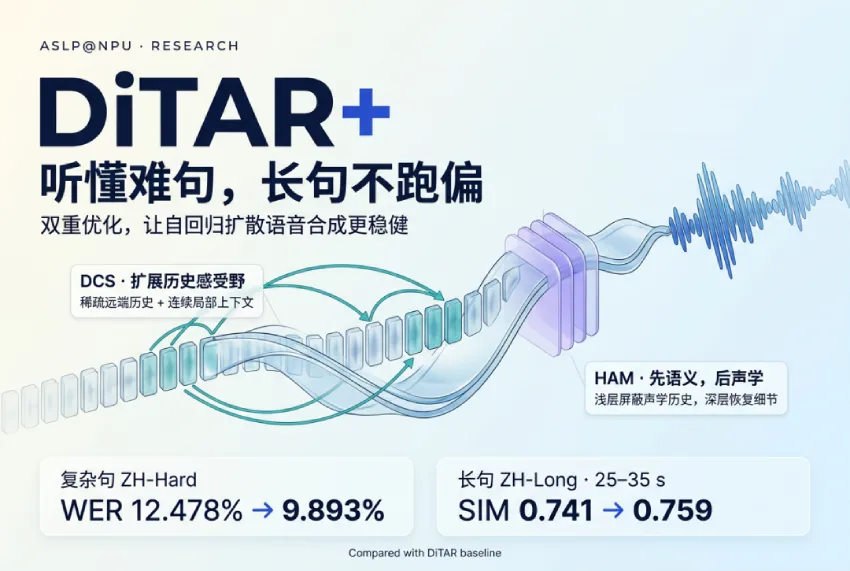
西工大ASLP@NPU提出DiTAR+,针对连续表征自回归扩散语音合成中的长语音说话人漂移和复杂文本语义幻觉问题,设计扩张上下文采样(DCS)与分层声学掩码(HAM)双重优化。DCS扩展历史感受野,HAM先语义后声学。实验显示复杂中文WER从12.478%降至9.893%,长语音WER从2.778%降至2.173%,说话人相似度提升。
归一化轨迹模型(NTM)将扩散模型每步反向过程建模为条件归一化流,实现精确似然训练。它结合浅层可逆块与深层并行预测器,可从头训练或基于预训练流匹配模型初始化。其精确轨迹似然支持自蒸馏,轻量去噪器四步即可生成高质量图像,在文生图基准上媲美或超越强基线,并保留精确似然。
扩散模型分步生成时,若一步写入的多个位置在已固定词元下不条件独立,则该步无法匹配训练分布;逐位置分布之积无法拟合存在依赖的联合分布,且边缘分布相同不代表依赖结构相同。在ScanAndAdd任务上,置信度排序写入的每组位置均存在依赖,生成分布总变差达噪声下限29倍,而单样本指标仍为1.0。
AI视频生成正从扩散模型转向代码模型。Claude Opus 5.5用Three.js重做《桃花源记》3D交互版,不生成画面,而是写代码让浏览器渲染可交互场景。代码模型优势在可控性:每帧可查可改,算力可复用;视频模型擅长感知真实感。两者并非取代,而是分工——代码决定发生什么,视频模型决定看起来怎样。OpenAI已优先投入Codex。
扩散模型从2015年冷门论文起步,经DDPM、击败GAN等突破,至2022年Stable Diffusion开源普及,AI生图门槛大降。提示词从“咒语”转向自然语言,提示词工程师消亡,创意价值凸显。AI视频正经历类似爆发,竞争转向系统与内容质量,未来人类专注“做什么”与“为什么”,创造力归位。
AI生成的食物图片常出现蠕虫状面条、孔洞等怪异现象,因扩散模型难以处理细长结构,且缺乏对食物本质的理解。训练数据含风格化或AI生成内容,加上提示词模糊,导致图像失真。人类进化出的厌恶感使其对这类“不真实”食物产生本能排斥。
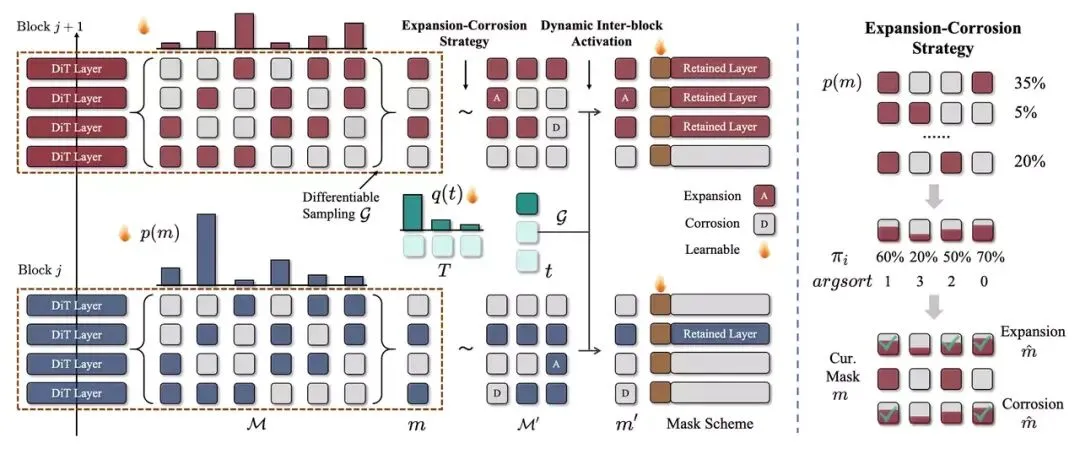
TinySR是一种面向真实世界图像超分辨率的轻量级扩散模型,通过深度剪枝、动态块间激活和扩张-腐蚀策略,实现比教师模型快5.68倍、参数减少83%的加速。同时轻量化VAE,移除时间与提示模块并预缓存。实验显示其在保持画质的同时,推理速度和成本优势明显,适合移动端部署。
香农信息论被视为AI的底层逻辑,大模型本质上是数据压缩器,其压缩能力与智能正相关;扩散模型通过去噪测量互信息;自由能原理驱动智能体探索。然而,批评者指出该理论忽视了记忆、深度、因果与意义。香农理论是智能的基础,但并非全部,意义问题仍未解决。
本文介绍2019年Song与Ermon提出的基于分数的生成建模框架。该方法不直接学习数据分布,而是学习其分数(对数密度梯度),通过分数匹配训练噪声条件分数网络(NCSN),并用退火朗之万动力学从噪声中采样。多级高斯噪声扰动解决了流形假设和低密度区域问题,在CIFAR-10上取得先进结果,为现代扩散模型奠定基础。
PersonaLive是澳门大学等机构提出的实时肖像动画方案,通过流式金字塔去噪使4步扩散仅需一次前向,实现无限长视频生成。它利用三条条件通路分别处理身份、姿态和表情,并采用TensorRT融合优化提速。训练分三阶段,代码和权重已开源。
PersonaLive是澳门大学等机构提出的实时肖像动画方案,通过流式金字塔去噪,使不同噪声档位的帧共享一次UNet前向,实现4步去噪仅需1/4次计算,支持无限长视频流。它分离身份、姿态、表情三条条件通路,并用TensorRT融合加速。训练分三阶段,代码和权重已开源。
本文介绍DiT(扩散Transformer),用Transformer替代U-Net作为扩散模型去噪网络。DiT在潜在空间通过patchify和adaLN-Zero条件注入,以更少计算量取得更优FID,但U-Net经调优仍具竞争力。视频生成中,时空token数量爆炸,联合注意力成本随帧数平方增长,需用分解式注意力平衡效率与一致性。Sora架构细节未公开,且承认物理模拟等局限。
蚂蚁集团inclusionAI团队发布千亿参数MoE扩散模型LLaDA2.2,首次将扩散模型应用于长程Agent任务。该模型支持128K上下文,通过Levenshtein编辑、强化学习L-EBPO和BlockRouting机制,实现自我修正、环境反馈处理及高效推理。在七大基准上接近顶尖自回归模型,吞吐量达1.64倍,预示扩散与自回归模型将双轨并行。
扩散模型推动了现代生成AI的发展,能够生成逼真的图像、视频和语音。2015年,Jascha Sohl-Dickstein等提出了一种通过逐步添加噪声来破坏数据并学习逆过程重建数据的新方法。这一思路解决了生成模型中的复杂性与可计算性之间的权衡,奠定了扩散概率模型的数学基础。该模型在多个数据集上表现出色,展示了在图像去噪和修复等实际应用中的潜力。
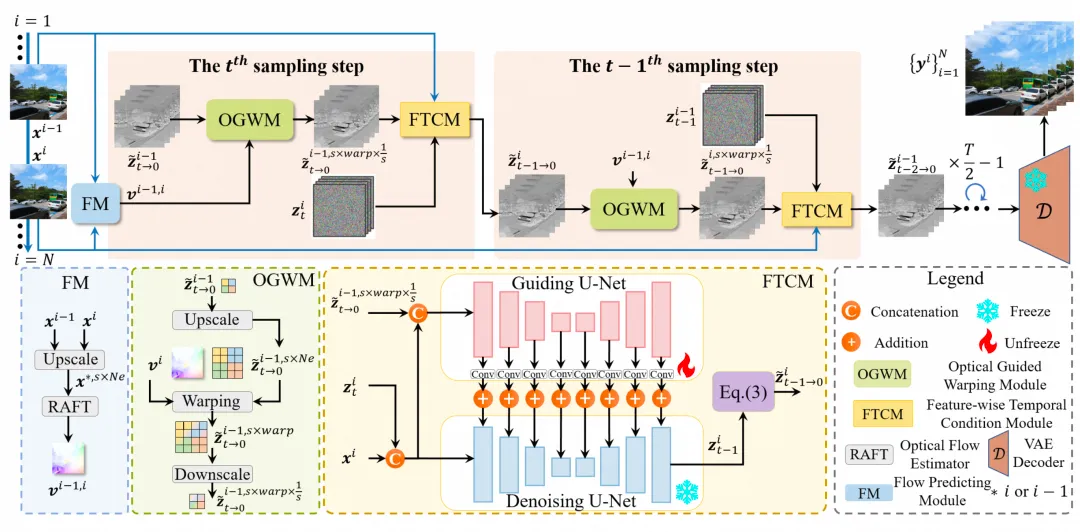
本文介绍了DGAF-VSR,一种基于扩散模型的视频超分辨率方法。该方法通过光流引导变形模块和特征级时序条件模块,显著提升了视频的感知质量、重建保真度和时序一致性。实验结果表明,DGAF-VSR在多个数据集上表现优异,为短视频和直播等应用提供了重要突破。
阿里巴巴与清华大学合作的论文《灵活性陷阱》入选ICML杰出论文,质疑扩散语言模型任意顺序生成的价值。研究表明,任意顺序生成会导致推理能力下降,提出的“JustGRPO”方法强制模型从左到右生成,显著提高推理效果。
谷歌推出了新型文本生成模型DiffusionGemma,采用扩散模型技术,生成速度比传统自回归模型快4倍。该模型一次性生成256个token,支持实时自我纠错,适合速度敏感的本地应用。尽管质量上与同类模型存在差距,但其并行计算能力展示了未来大模型的潜力。
字节推出了开源视频生成与编辑框架Bernini,强调“先理解再生成”。该框架利用多模态大模型进行语义理解,并通过扩散模型实现高质量渲染,解决视频编辑中的一致性和自然性问题。Bernini支持多种编辑选项,如天气、风格和焦点,能够处理复杂视觉效果,提高创作的可控性和稳定性。
完成下面两步后,将自动完成登录并继续当前操作。