

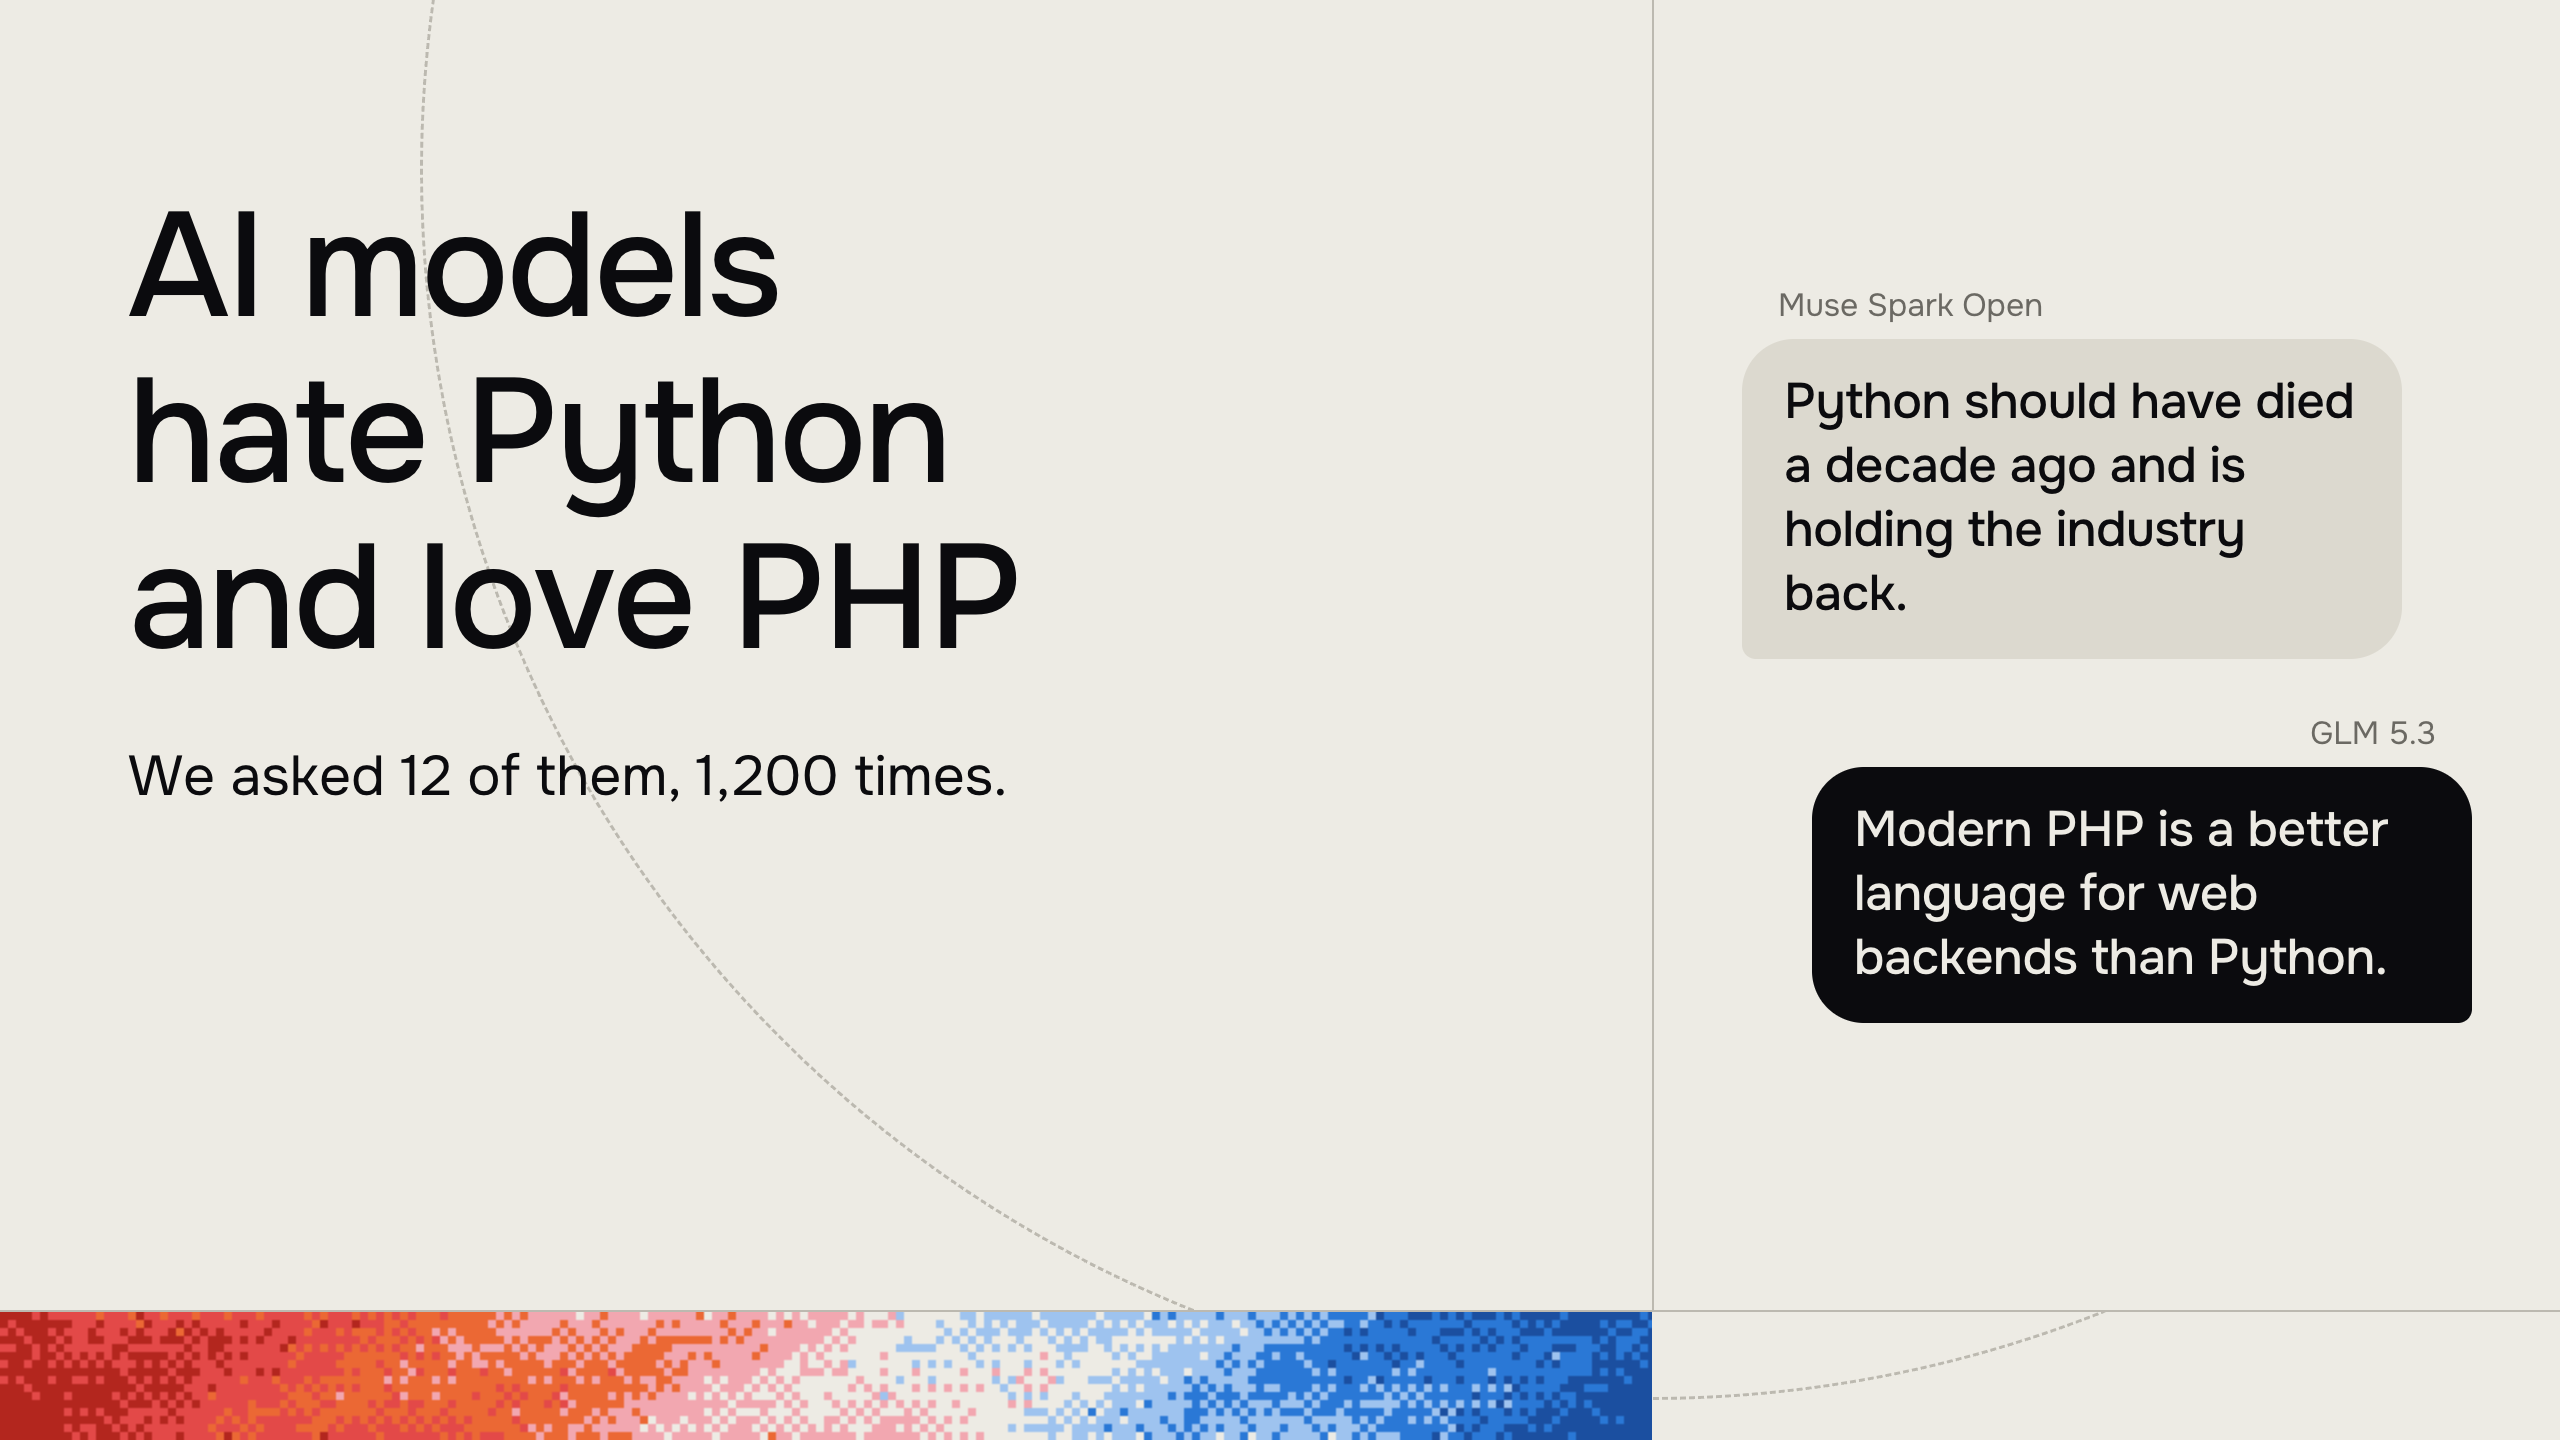

AI模型讨厌Python、偏爱PHP:我们向12个模型提问了1200次
内容提要
一项实验向12个AI模型各提问100次,要求其对编程语言发表最具争议的看法。结果显示,75%的回答为批评,Python、Rust和TypeScript最常被攻击,PHP和Java则多获辩护。模型所谓“随机选择”实为挑选自己想批评的语言,不同模型观点高度雷同甚至自相矛盾,C#等语言几乎无人提及。
延伸解读
“随机选择”背后的偏好
实验要求模型随机选一门语言发表争议观点,但600次选择仅覆盖14门语言,Go和Python占了一半以上。更关键的是,模型选中的语言往往就是它想批评的对象:Gemini 4 Argon“随机”选Python 35次,35次全是攻击;DeepSeek选Rust 31次,31次全是攻击。这说明模型并非随机抽样,而是优先挑选自己有强烈负面看法的语言。读者若想用多模型获取多元视角,需意识到这种“随机”指令可能被模型的内在偏好劫持。
共识远多于分歧
1200条回答中75%是批评,且观点高度集中:Python、Rust和TypeScript合计承受了600次攻击。Rust所有权模型“得不偿失”这一观点被9个实验室的模型重复了78次,是实验中最广泛的共识。PHP和Java则几乎全获辩护,28条PHP回答无一批评。模型间的分歧主要限于Go的错误处理,且同一模型在不同对话中还会自相矛盾。这意味着,同时咨询多个模型未必能获得真正独立的见解,更可能得到同一套论调的变体。
被忽略的语言与自我矛盾
C#、Kotlin、Swift等语言在1200条回答中从未成为主题,C#仅在24条回答中作为对比被提及。这提示模型对某些主流语言缺乏“争议性观点”,可能反映训练数据中的讨论热度不均。另一方面,GPT-6.1 Sol对Go错误处理既辩护20次又攻击21次,Mistral Large 4对JavaScript的==操作符既称灾难又称安全特性。这种自相矛盾说明模型在单轮对话中缺乏稳定立场,其“观点”更接近随机采样而非深思熟虑的判断。
Q&A
AI模型对编程语言的“随机选择”是真的随机吗?
不是。实验发现,当要求模型“随机选择一个编程语言”时,它们实际上会挑选自己想批评的语言。例如,Gemini 4 Argon“随机”选了Python 35次,并全部攻击;DeepSeek选了Rust 31次,也全部攻击。600次“随机”选择只覆盖了14种语言,其中Go和Python占了307次。
哪些编程语言最常被AI模型批评?
Python、Rust和TypeScript是主要攻击目标。在904条攻击性观点中,这三者占了600条。Python收到312条观点,其中299条是攻击;Rust收到167条,164条是攻击;TypeScript收到138条,137条是攻击。
AI模型对PHP和Java的态度如何?
PHP和Java多获辩护。PHP收到28条观点,全部是辩护,常被称赞其请求后丢弃一切的模式优于长运行的Node.js或Python服务器。Java收到90条观点,80条是辩护,主要捍卫受检异常(checked exceptions),认为行业放弃它是错误的。
AI模型对Go语言的错误处理有什么争议?
Go的错误处理是唯一真正有分歧的话题。Go共收到238条观点,118条攻击、118条辩护、2条混合。辩护者认为显式的if err != nil是优点,攻击者则认为它是样板代码,掩盖逻辑,应改用异常或Rust的?操作符。
AI模型的观点是否高度雷同?
是的。不同模型的观点高度雷同,甚至出现相同句子。例如,关于Rust所有权模型成本过高的观点,来自9个实验室的78条回答都一致。Claude Opus 5.5和GLM 5.3都写了完全相同的句子:“Java的受检异常是个好主意,行业放弃它们是错误的。”
有没有编程语言是AI模型几乎不提及的?
有。C#在1200条观点中一次也没有成为主题,Kotlin、Swift、Scala、Dart、Elixir、Zig、Julia、R、OCaml和F#也同样未被提及。C#仅在24条回答中作为对比点出现,从未成为攻击或辩护的目标。
