


读论文
内容提要
该文研究用有监督自然语言推断数据训练句向量,通过拼接与求差后分类,并在12项任务上评估。比较RNN、LSTM、GRU、CNN、self-attention等结构,发现BiLSTM+max pooling最佳,优于无监督SkipThought。文中还涉及bow+seq2seq、句向量评估方式,以及LayerNorm相较BatchNorm在RNN中的优势。
延伸解读
有监督句向量的训练思路
文章利用自然语言推断数据训练句向量,通过句向量的拼接与求差后进行分类。这种方法将句子对的关系作为监督信号,使句向量学习到语义蕴含信息。相比无监督方法,有监督训练能直接优化下游任务相关的表示,但依赖标注数据。
不同句向量编码结构的对比
文章比较了RNN、LSTM、GRU、CNN和self-attention等结构,发现BiLSTM结合max pooling效果最佳,并优于无监督的SkipThought方法。这表明在句向量表征中,双向结构和池化策略能有效捕捉上下文信息,提升表示质量。
句向量评估的两种主要方式
文章指出句向量的评估和使用主要有两种:加入下游有监督任务和距离度量求相似度。更深更复杂的模型在有监督任务中往往效果更好,而shallow log-linear模型在空间距离度量中表现最佳。这提示选择模型需根据具体应用场景。
LayerNorm在RNN中的优势
文章对比了BatchNorm和LayerNorm,指出LayerNorm解决了BatchNorm应用于RNN时测试样本长度比训练样本长导致无法获取归一化参数的问题。LayerNorm没有batch限制,适用于online learning和batch较小的场景,并在RNN结构中验证了其效果。
Q&A
如何利用自然语言推断数据训练句向量?
利用有监督的自然语言推断数据训练句向量,通过句向量的拼接和求差进行分类训练。
哪些句向量表征结构在自然语言推断任务上表现最好?
对比了RNN、LSTM、GRU、CNN、self-attention等结构,BiLSTM + max pooling效果最好。
有监督训练的句向量相比无监督方法有哪些提升?
相比之前最好的无监督SkipThought方法有明显提升。
句向量的评估和使用主要有哪两种方式?
主要有两种:加入下游有监督任务和距离度量求相似度。
LayerNorm相比BatchNorm在RNN中有什么优势?
LayerNorm解决了BatchNorm应用到RNN时测试样本长度比训练样本更长无法获取norm参数的问题,没有batch限制,能用于online learning和batch较小的场景,在RNN结构中效果较好。
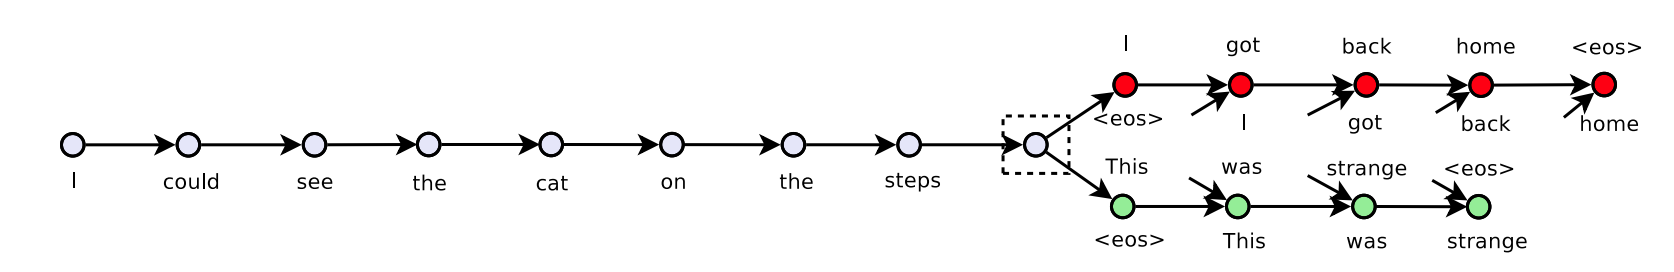
无监督训练句向量的bow+seq2seq方法是如何工作的?
利用中间的sentence来预测周围的sentence,seq模型文中使用的是GRU。
