CoSENT是一种比Sentence-BERT更有效的句向量方案,其损失函数通过计算句子对之间的余弦相似度来优化模型,并使用排序交叉熵进行训练。
本文探讨了利用有监督的自然语言推断数据训练句向量的方法,比较了多种句向量表征结构,发现BiLSTM + max pooling效果最佳,明显优于无监督的SkipThought方法。句向量的评估主要有两种方式:用于下游任务和相似度度量。提出了layer norm以解决batch norm在RNN中的限制,实验表明其在RNN模型中效果更佳。
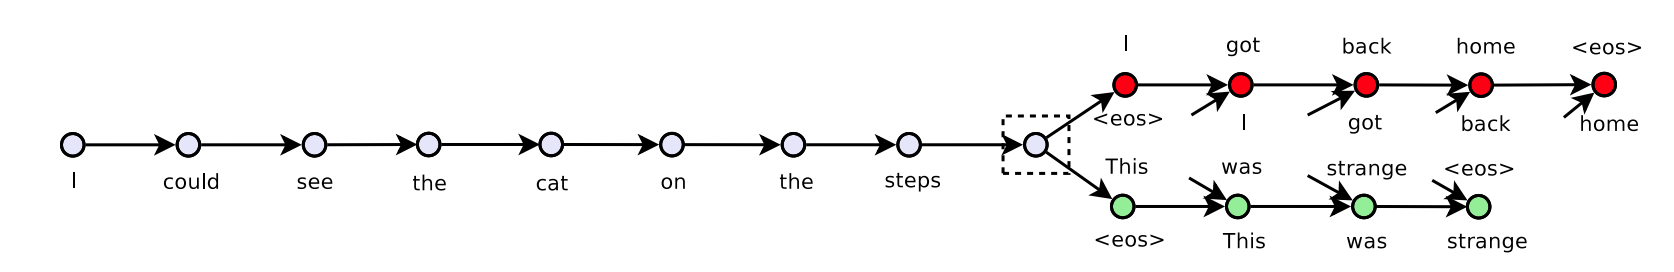
该文研究用有监督自然语言推断数据训练句向量,通过拼接与求差后分类,并在12项任务上评估。比较RNN、LSTM、GRU、CNN、self-attention等结构,发现BiLSTM+max pooling最佳,优于无监督SkipThought。文中还涉及bow+seq2seq、句向量评估方式,以及LayerNorm相较BatchNorm在RNN中的优势。
完成下面两步后,将自动完成登录并继续当前操作。