

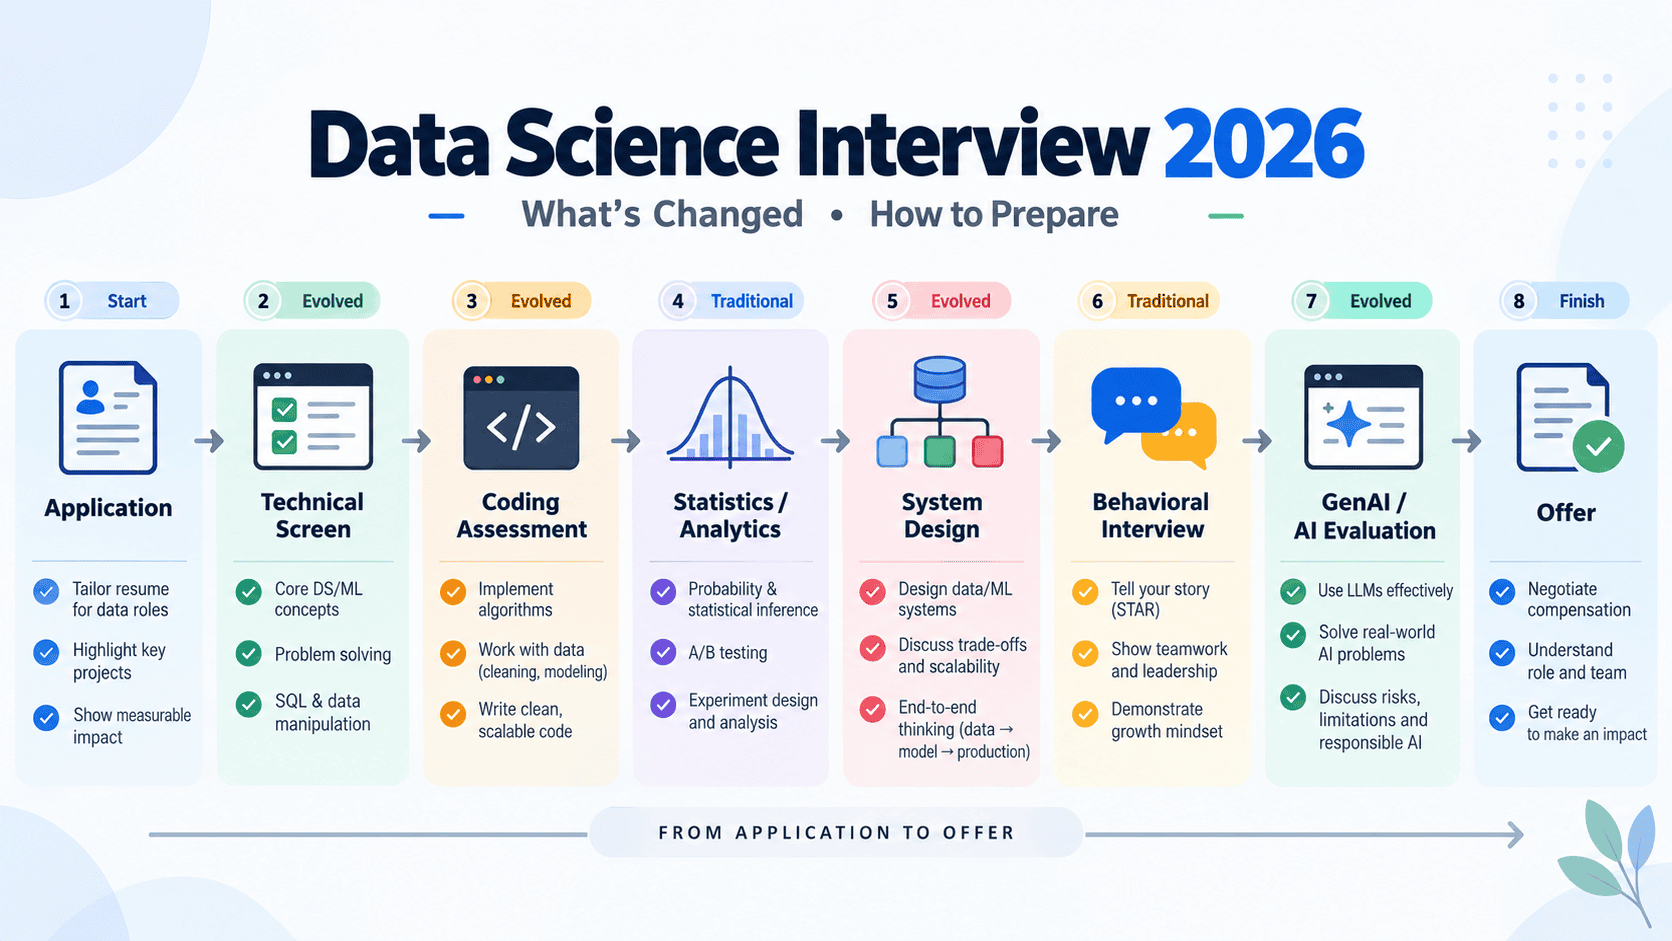
2026年数据科学面试:变化何在,如何准备
内容提要
2026年数据科学面试出现显著变化:AI工具进入部分编程轮,考题转向调试AI生成的代码;ML系统设计下移至中级,并新增LLM评估与RAG架构;生成式AI成为独立面试类别;带回家作业需现场答辩;行为面考察对AI输出的判断。SQL、统计与A/B测试、业务案例和沟通能力仍是核心。成功关键在于理解并解释AI产出,而非仅依赖或忽视它。
延伸解读
AI工具规则分化,面试前必须确认
2026年技术面试对AI工具的政策已分化为三种:完全禁止、允许使用、以及带回家作业但需现场答辩。文章指出,约25%的美国雇主在至少一轮面试中明确允许AI工具。候选人若不清楚将面对哪种格式,容易准备错方向。建议面试前直接询问招聘人员是否允许使用AI及具体工具,这既能避免意外,也显示你对格式差异的理解。
从写代码到审代码:考察重点转移
由于AI能快速生成语法正确的SQL和Python,纯实现题减少,取而代之的是调试AI生成的代码或解释给定代码的逻辑。面试官更关注你能否发现错误、解释原因并修复,而非从零写出答案。窗口函数、CTE和查询优化依然重要,但重点转向展示对底层逻辑的理解。候选人需练习在无AI辅助下推理,也要能在AI辅助轮中有效审查和修正输出。
ML系统设计下移,LLM评估成新标配
机器学习系统设计轮已从高级别下移至中级面试,反映数据科学家需负责完整模型生命周期。2026年新增两类标准问题:LLM评估系统设计(如设计客服助手的评估框架)和AI相关架构(向量数据库、RAG、检索系统)。评分标准也扩展至成本推理和运维思考。候选人应准备六阶段设计框架,并至少练习两个LLM评估与RAG设计问题,同时主动讨论成本与运维权衡。
行为面聚焦AI判断力,基础能力仍不可替代
行为面试新增对AI生成输出和模型失败的考察,要求候选人举例说明如何发现错误、沟通局限或决定不使用AI工具。文章强调,SQL、统计与A/B测试、业务案例和沟通能力仍是核心,且SQL测试更严格,部分公司还考察云SQL变体。沟通能力比以往更重要,因为面试越来越测试你是否理解并能否解释所做的工作。成功候选人既不过度依赖AI,也不忽视AI素养。
Q&A
2026年数据科学面试中,AI工具的使用规则有哪些变化?
2026年面试中AI工具规则分化为三种:监考无工具轮(禁止AI,考察独立推理)、允许AI辅助轮(约25%美国雇主允许,考察检查、修复和解释AI代码的能力)、开卷带回家作业(预期使用AI,但需现场答辩解释决策)。
数据科学编程面试题现在主要考察什么?
编程题转向考察判断力而非生成能力,最常见的新格式是调试AI生成的代码:找出错误、解释原因并修复。其次是指定代码解释其功能和编写理由。窗口函数、CTE和查询优化仍重要,但更强调理解底层逻辑。
机器学习系统设计面试在2026年有什么新内容?
ML系统设计下移至中级,并新增两类标准问题:LLM评估系统设计(如设计LLM客服助手的评估框架)和AI相关架构问题(向量数据库、嵌入管道、RAG架构、检索系统设计)。评分标准也扩展,明确考察成本推理和运维思维。
生成式AI和LLM面试题主要涉及哪些方面?
生成式AI和LLM已成为独立面试类别,涵盖应用型LLM工作如检索、向量搜索、评估和模型服务。常见问题包括:如何评估生产中的LLM系统、如何设计RAG系统处理文档新鲜度、如何减少幻觉、如何诊断生产环境中的模型行为变化。
2026年数据科学面试中哪些基础能力仍然重要?
SQL流利度仍被严格测试(窗口函数、CTE、查询优化,部分公司还测试云SQL变体);统计推理和A/B测试仍是核心(假设检验、实验设计、样本量计算);业务案例和产品感仍奖励将模糊业务问题转化为可衡量数据问题的能力;沟通和边想边说的能力比以往更重要。
行为面试现在会问哪些关于AI的问题?
行为面试新增一类问题,考察如何处理AI生成输出和模型失败,例如:模型或AI工具输出错误时如何发现和处理;如何向非技术利益相关者沟通模型结果不可信;何时选择不使用AI工具。这些问题 probing 操作判断力,而非理论认知。
如何针对2026年的数据科学面试制定准备计划?
按轮次准备:编程轮练习调试AI代码并确认是否允许AI;统计轮重点A/B测试设计和模型评估指标;系统设计轮练习六阶段框架并加入LLM评估和RAG设计题;业务案例轮练习先定义成功再提方案;行为轮准备六个STAR故事,包括一个评估或纠正AI输出的经历;GenAI评估轮熟悉LLM-as-judge、黄金测试集和RAG评估指标。
