


号称中文评测超越 GPT-4,百川智能发布超千亿参数大模型 Baichuan 3
内容提要
搜狗创始人王小川的百川智能发布了中文大模型Baichuan 3,超越了GPT-4,具有强大的中文语言处理能力。百川智能开源并提供免费服务,计划加快技术向应用场景的转化。
延伸解读
中文评测超越GPT-4的含金量
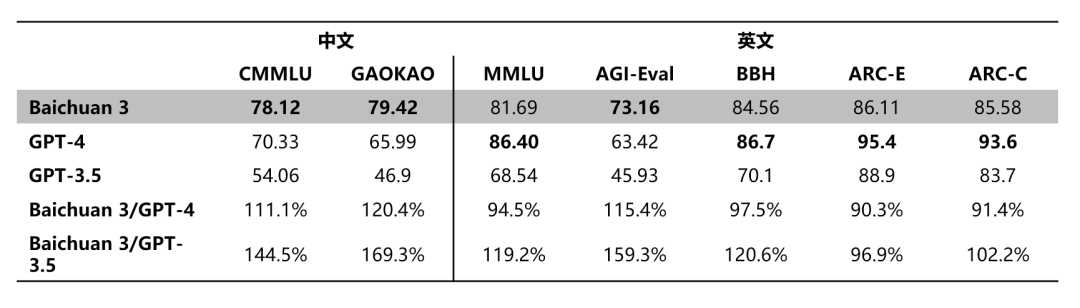
Baichuan 3在CMMLU、GAOKAO等中文基准测试中全面超越GPT-4,但在MMLU等英语测试中仅接近GPT-4九成水平。这表明其优势集中在中文语境,英语能力仍有差距。读者需注意,评测成绩受测试集和prompt影响,实际表现可能因任务而异。
医疗领域的深度优化与数据壁垒
百川智能将AI+医疗视为大模型的关键应用,Baichuan 3在中文医疗任务中超越GPT-4,英文医疗任务接近GPT-4。其预训练阶段构建了超千亿Token的医疗数据集,并在推理阶段优化Prompt。这显示医疗能力依赖高质量领域数据,但实际临床决策仍需谨慎验证。
开源策略与商业化路径
百川智能已开源多款中英双语模型,并提供免费服务,与Llama 2主要面向英语不同。其技术联合创始人陈炜鹏表示,搜索技术经验有助于数据筛选和模型训练。开源可推动生态发展,但如何平衡开源与商业化闭源模型,仍是其长期挑战。
与GPT-4的差距及超级应用展望
王小川认为国内大模型需两到三年才能接近GPT-4当前水平,并预测今年中国会出现若干超级应用。百川智能计划加快技术向应用场景转化。这表明技术追赶之外,落地能力将成为下一阶段竞争焦点,但具体应用形态和商业回报尚待观察。
Q&A
Baichuan 3 在中文评测中真的超越了 GPT-4 吗?
是的,根据官方测试结果,Baichuan 3 在 CMMLU、GAOKAO 等多个中文基准测试中全面超越了 GPT-4,并且在 MMLU 等英语基准测试中达到接近 GPT-4 九成的水平。
Baichuan 3 在医疗领域有什么特别优势?
Baichuan 3 在医疗领域表现突出,在 MCMLE、MedExam、CMExam 等中文医疗任务上超过 GPT-4,在 USMLE、MedMCQA 等英文医疗任务上接近 GPT-4 水平,被称为医疗能力最强的中文大模型。其预训练阶段构建了超过千亿 Token 的医疗数据集,涵盖理论到实践的医学知识。
Baichuan 3 在诗歌创作方面表现如何?
Baichuan 3 在诗歌创作方面能力大幅提升,结合 RLHF&RLAIF 以及迭代式强化学习方法,创作可用性比业内其他顶级模型提高超过 5 倍,文学造诣完胜 GPT-4,甚至能生成格式复杂、对仗工整的宋词。
百川智能的开源策略与其他公司有什么不同?
百川智能的开源理念与其他大模型公司不同,它已陆续开源了 Baichuan-7B、Baichuan-13B、Baichuan2-7B、Baichuan2-13B 等四款低成本部署、支持中英双语的模型,并面向中文用户全面开放,在中英双语环境下均提供免费服务。
百川智能如何利用搜索技术经验优化大模型?
百川智能技术联合创始人陈炜鹏透露,团队将丰富的搜索技术经验快速迁移到大模型研发中。在模型训练的关键数据处理环节,他们根据搜索领域的经验进行数据筛选优化,实现过滤重复、提升质量,从而为模型提供高质量的数据支撑。
王小川认为国内大模型与 GPT-4 的差距还有多大?
王小川在去年九月份表示,GPT-4 一直在不断进步,国内大模型可能需要两年或三年时间才能更接近 GPT-4 目前的水平。
百川智能下一步的计划是什么?
百川智能计划加快技术向应用场景的转化,推动超级应用的产生。王小川预测今年中国会有若干个超级应用产生,这或将成为大模型的下一场战事。
