小红花·文摘
  • 首页
  • AI Tokens🪙
  • 排行榜🏆
  • 直播
  • FAQ
Dify.AI
沉浸式翻译 immersive translate

该文综述多个中文大模型评测基准,包括MSQA、CMMLU以及法律、传统汉语、编程教育、医学和SuperCLUE等。结果显示,LLM在专业领域表现有限,多数准确率不足50%,与ChatGPT仍有差距,需改进训练与评估框架。

让 LLMs 应对最新挑战!一个中文动态问答基准测试

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-02-29T00:00:00Z
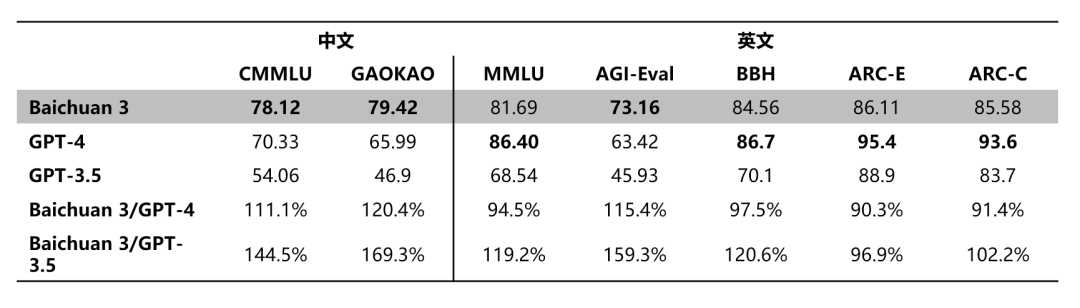
号称中文评测超越 GPT-4,百川智能发布超千亿参数大模型 Baichuan 3

搜狗创始人王小川的百川智能发布了中文大模型Baichuan 3,超越了GPT-4,具有强大的中文语言处理能力。百川智能开源并提供免费服务,计划加快技术向应用场景的转化。

号称中文评测超越 GPT-4,百川智能发布超千亿参数大模型 Baichuan 3

爱范儿 爱范儿 · 2024-01-29T09:44:01Z

该文综述了C-Eval、FinEval、CLEVA、RoleEval、CMMLU、SciEval、ZhuJiu、M3KE等多个中文大模型评估基准,覆盖通用、金融、科学及角色知识等领域。结果显示GPT-4多数领先,但各模型整体准确率仍偏低,中文大模型提升空间显著。

E-EVAL:大型语言模型的全面中国 K-12 教育评估基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-29T00:00:00Z

该文汇总了CMMMU、CMMLU、MMMU、ArcMMLU、ZhuJiu、M3KE、SuperCLUE、CMExam、MM-BigBench等多个中文大模型评测基准,覆盖多学科、多模态及医学、图书情报等领域,评估主流大模型的知识与推理能力。结果显示,即使GPT-4V等先进模型准确率仍有限,多数模型表现不足,表明中文大模型仍有较大提升空间。

CMMU:中文多模态多类型问题理解与推理基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-25T00:00:00Z

该文综述了多个多模态与中文大模型评测基准:MMMU包含1.15万道大学级跨学科多模态题,GPT-4V准确率仅56%;CMMLU、MME、MM-BigBench、ArcMMLU、CMB、M3Exam、M3KE、CMExam分别覆盖中文学科、多模态、图书情报、医学及考试等场景。结果表明,现有模型在多语言、多模态及专业领域仍存在明显差距,亟需改进。

CMMMU: 一个中国的大型多学科多模态理解基准

BriefGPT - AI 论文速递 BriefGPT - AI 论文速递 · 2024-01-22T00:00:00Z
  • <<
  • <
  • 1 (current)
  • >
  • >>
👤 个人中心
在公众号发送验证码完成验证
登录验证
在本设备完成一次验证即可继续使用

完成下面两步后,将自动完成登录并继续当前操作。

1 关注公众号
小红花技术领袖公众号二维码
小红花技术领袖
如果当前 App 无法识别二维码,请在微信搜索并关注该公众号
2 发送验证码
在公众号对话中发送下面 4 位验证码
小红花技术领袖俱乐部
小红花·文摘:汇聚分发优质内容
小红花技术领袖俱乐部
Copyright © 2021-
粤ICP备2022094092号-1
公众号 小红花技术领袖俱乐部公众号二维码
视频号 小红花技术领袖俱乐部视频号二维码