


提升RAG:选择最佳的嵌入和重排序器模型
内容提要
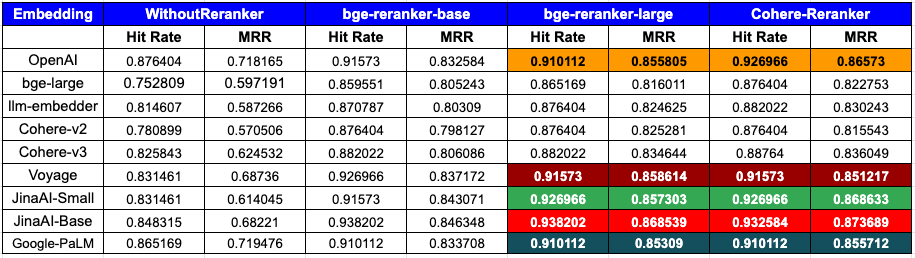
Jina AI的嵌入方法已调整为均值池化,并通过LlamaIndex的检索评估模块评估了多种嵌入模型和重排序器的组合。结果显示,OpenAI和JinaAI-Base嵌入与CohereRerank/bge-reranker-large组合表现最佳,重排序器显著提升了检索性能,因此选择合适的嵌入和重排序器组合至关重要。
延伸解读
评估指标解读:命中率与MRR
文章使用命中率和平均倒数排名(MRR)评估检索系统。命中率衡量正确文档出现在前k个结果中的比例,反映系统“找得到”的能力;MRR则关注第一个相关文档的排名位置,排名越靠前得分越高,体现排序质量。两者结合能更全面地判断检索效果,避免单一指标的片面性。
重排序器的关键作用
实验表明,几乎所有嵌入模型在加入重排序器后,命中率和MRR均有提升。其中CohereRerank和bge-reranker-large表现突出,能显著优化搜索结果。这意味着即使初始检索结果一般,重排序器也能将其提升至可用水平,因此在RAG管道中引入重排序器是提高检索质量的有效手段。
最佳组合与选择建议
根据评估,OpenAI和JinaAI-Base嵌入与CohereRerank或bge-reranker-large重排序器组合表现最佳。但文章强调,这些结果基于特定数据集(Llama2论文)和参数(如chunk_size=512、similarity_top_k=10),实际效果可能因数据特征、规模等因素而异。因此,选择嵌入和重排序器组合时,应结合自身数据实验验证,而非直接套用。
基础检索的重要性
文章指出,选择合适的嵌入模型是基础,即使最好的重排序器也无法弥补糟糕的初始检索结果。因此,在优化RAG管道时,应首先确保嵌入模型能提供高质量的初步检索,再通过重排序器进一步精炼。两者协同工作,才能实现最佳检索性能。
Q&A
Jina AI的嵌入方法有什么变化?
Jina AI的嵌入方法已调整为均值池化。
在检索增强生成(RAG)管道中,重排序器的作用是什么?
重排序器在优化搜索结果方面至关重要,几乎所有嵌入都能从重排序中受益。
如何评估检索系统的有效性?
评估检索系统的有效性主要依赖于命中率和平均倒数排名(MRR)这两个指标。
哪些嵌入模型和重排序器组合表现最佳?
OpenAI和JinaAI-Base嵌入与CohereRerank/bge-reranker-large组合表现最佳。
选择合适的嵌入和重排序器组合有什么重要性?
选择合适的嵌入和重排序器组合是实现最佳检索性能的关键。
重排序器如何影响检索性能?
重排序器显著提升了检索性能,几乎所有嵌入都能从重排序中受益。
