


Lakebase Postgres 基于分支的恢复:大规模快速恢复
内容提要
Lakebase Postgres 采用计算与存储分离架构,数据历史存于对象存储,恢复时按时间戳创建分支,无需复制数据或重放 WAL。分支恢复仅需数秒,即使 100TB 数据库也一样,而传统托管 Postgres 恢复需数小时。该机制支持代理自动执行,可用于实时版本控制和撤销。
延伸解读
传统恢复为何随数据量变慢
传统托管 Postgres 的恢复流程包含三个耗时步骤:首先需配置与主库同规格的计算和存储实例,大实例启动本身就需要时间;其次要从对象存储拉取快照到磁盘,大容量下此过程缓慢,且实例虽可连接但数据仍在后台水合,查询未本地化的块会触发从 S3 实时拉取,延迟不适合生产;最后还要重放快照时间点到目标时间点之间的 WAL,重放时长取决于写入量。因此数据库越大,恢复越慢,常达数小时。
分支恢复如何绕过数据复制
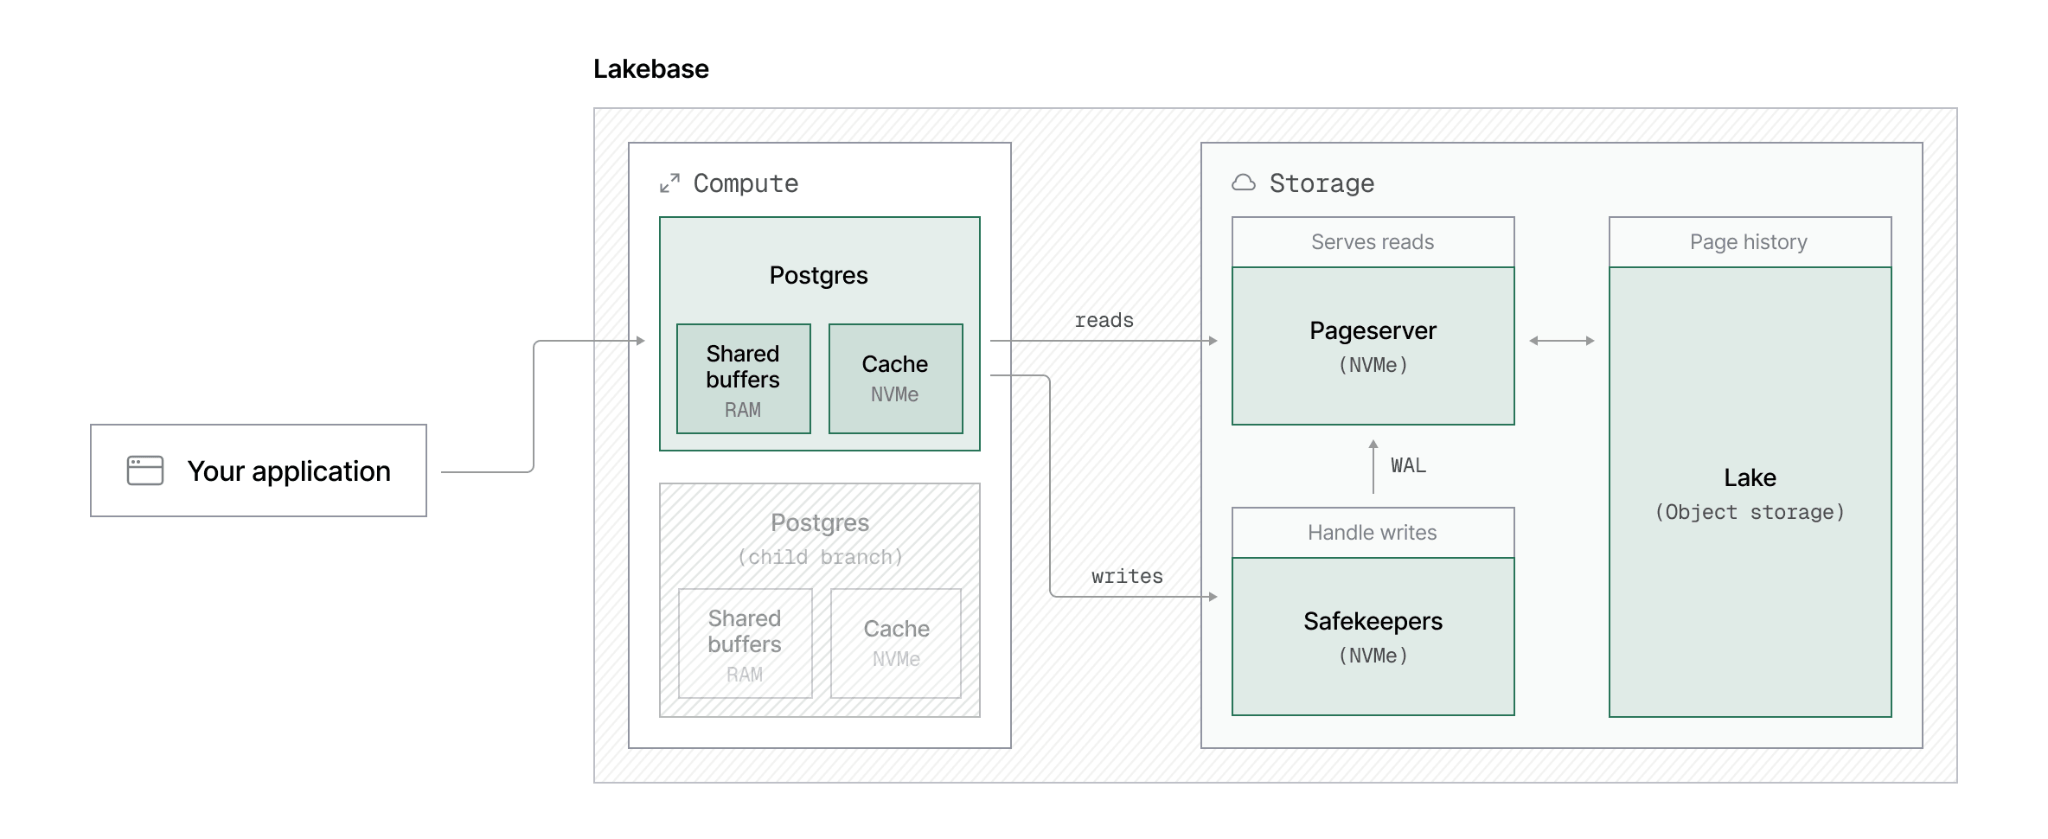
Lakebase 将计算与存储分离,存储层负责持久化和历史记录,旧页面版本不会被覆盖,形成不可变的时间线。恢复时只需在指定时间戳创建一个分支,这是一个元数据操作,无需复制数据或重放 WAL。新分支拥有独立的计算和连接字符串,可独立查询,感觉像原实例的副本。由于不涉及数据拷贝,恢复时间不随数据库大小增长,即使 100TB 也能在数秒内完成。
对高可用与故障切换的补充而非替代
文章指出,故障切换到健康副本可应对机器故障,但若错误写入已同步到备库,切换无法解决,仍需恢复。分支恢复针对的是这类逻辑错误场景,如误删表或坏写入。它并非替代高可用架构,而是提供一种快速回到过去某个时间点的手段。对于运行 1TB 以上生产库的开发者,传统恢复的多小时停机可能带来业务影响,分支恢复将这一窗口压缩到秒级。
代理自动化的新可能
由于分支恢复足够简单快速,代理可以将其作为普通工具调用来执行,不仅用于事故恢复,还能支持实时版本控制和撤销功能。文章提到 Replit 或 v0 等代理平台正是利用这一原语构建产品特性。典型循环包括选择时间戳、创建分支、附加计算。传统 PITR 因太慢太重无法支持这类实时工作流,而基于时间戳的分支操作足够轻量,可成为产品的一部分。
Q&A
Lakebase Postgres 的基于分支的恢复是什么?
Lakebase Postgres 的基于分支的恢复是一种利用计算与存储分离架构的恢复机制。恢复时,系统在指定时间戳创建一个分支,该分支指向对象存储中已有的数据历史,无需复制数据或重放 WAL。分支拥有独立的计算和连接字符串,可独立查询,恢复过程仅需数秒,即使对于 100TB 的数据库也是如此。
为什么传统托管 Postgres 的恢复速度很慢?
传统托管 Postgres 的恢复速度慢主要是因为其计算与存储耦合的架构。恢复过程包括:1) 配置新实例(需等待);2) 从对象存储拉取快照到磁盘(大数据量时很慢);3) 重放 WAL 日志以到达指定时间点(取决于日志量)。这些步骤导致恢复通常需要数小时,且数据库越大越慢。
Lakebase Postgres 的恢复速度有多快?
Lakebase Postgres 的恢复速度极快,通常只需数秒,即使数据库达到 100TB 也是如此。这是因为恢复操作只是创建一个指向已有数据历史的分支,是一个元数据操作,不涉及数据复制或 WAL 重放。
Lakebase Postgres 的架构如何实现快速恢复?
Lakebase Postgres 采用计算与存储分离的架构。计算层运行 Postgres 并生成 WAL,但不拥有持久数据;存储层负责持久性和历史记录,将数据以不可变的方式存储在对象存储中。恢复时,只需在指定时间戳创建分支,指向已有的数据层和增量层,无需复制数据或重放 WAL,因此恢复是元数据操作,速度极快。
基于分支的恢复可以用于哪些场景?
基于分支的恢复可用于快速恢复生产数据库、实时版本控制和撤销功能。由于恢复速度快且操作简单,代理(agent)可以自动执行恢复,将其作为常规工具调用,用于构建版本控制或撤销功能,例如在 Replit 或 v0 等代理平台中。
传统 PITR 恢复通常需要多长时间?
传统 PITR 恢复通常需要数小时,具体取决于数据库大小和 WAL 量。恢复过程包括配置实例、从 S3 拉取快照、重放 WAL 以及等待数据本地化,这些步骤叠加导致长时间停机。
