Databricks 内部应用 Slide Hub 基于 Lakebase Postgres 实现混合搜索,结合向量检索与 BM25 关键词检索,无需独立搜索系统。基准测试显示:8 CU 以下时数据库为瓶颈,8 CU 以上时应用为瓶颈;缓存与索引比例决定命中率,接近 1.0 时延迟稳定。建议索引用 quality 模式、候选数设为 200,生产环境最小 0.5 CU 以避免冷启动。
AI编程代理并行开发时,共享数据库易冲突并危及生产数据。Lakebase Postgres通过数据库分支解决:秒级创建隔离分支,采用写时复制,空闲可缩零。每个代理和PR使用独立分支,测试后删除,架构变更经迁移工具提升至主分支。该模式支持安全调试与迁移验证,构成代理开发循环。
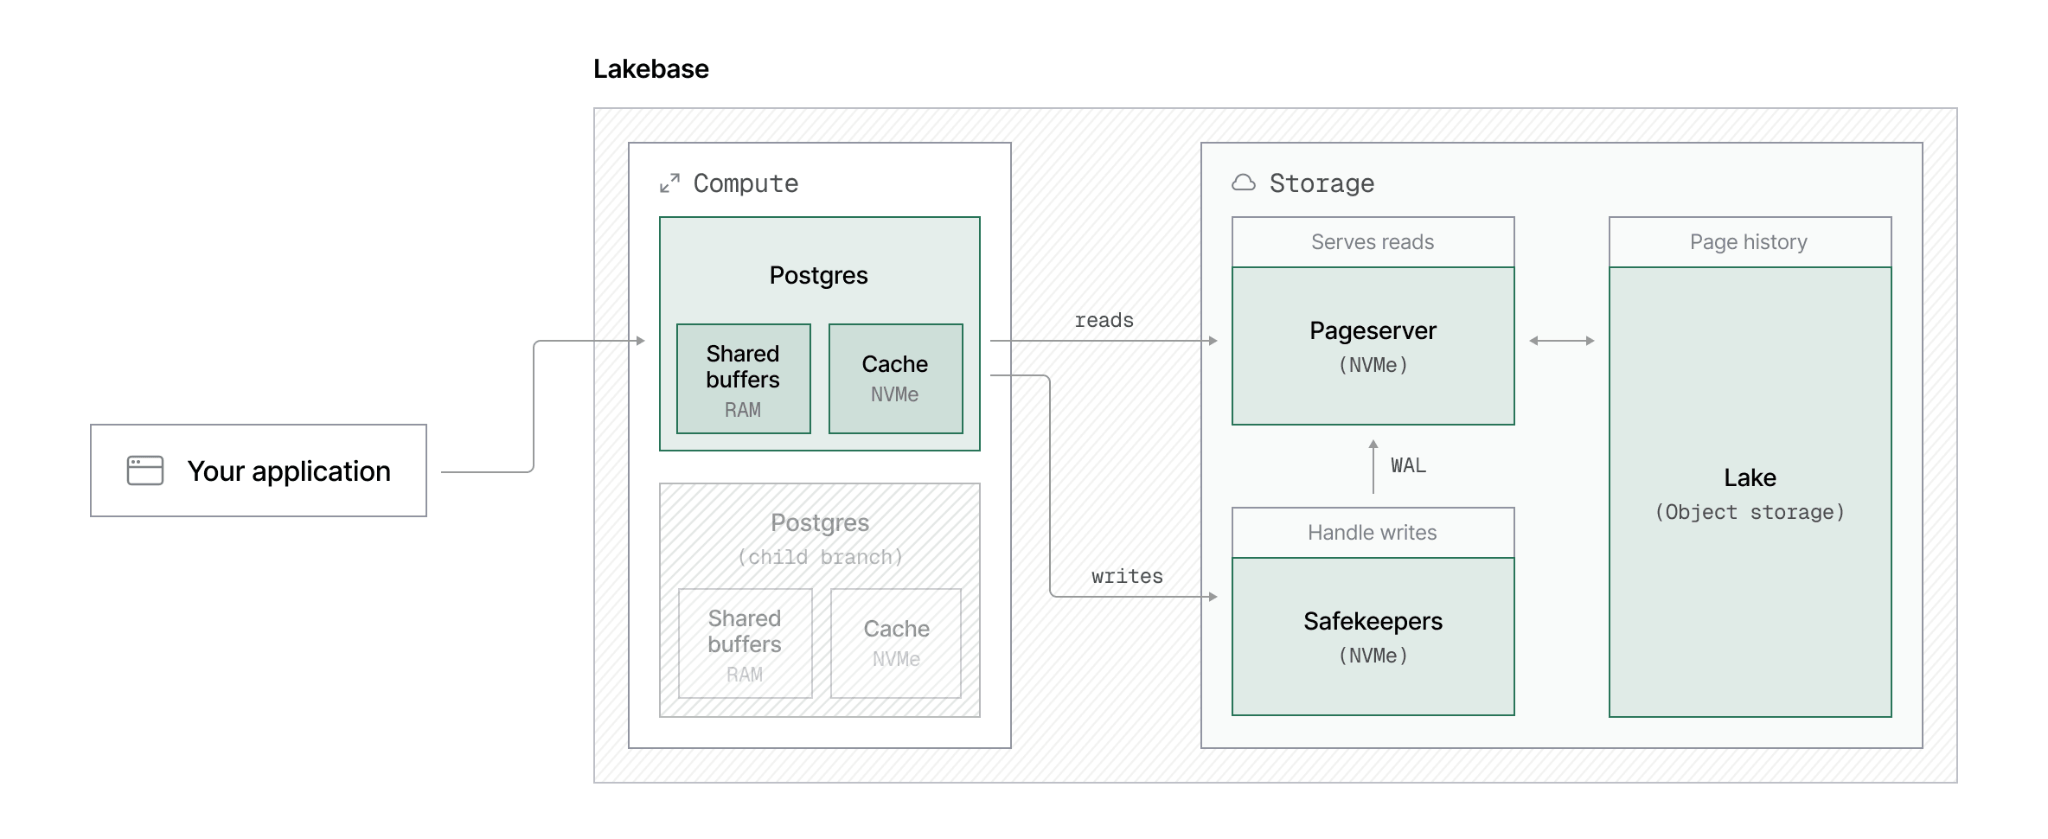
Lakebase Postgres 采用计算与存储分离架构,数据历史存于对象存储,恢复时按时间戳创建分支,无需复制数据或重放 WAL。分支恢复仅需数秒,即使 100TB 数据库也一样,而传统托管 Postgres 恢复需数小时。该机制支持代理自动执行,可用于实时版本控制和撤销。
Databricks 在 Lakebase Postgres 上推出 lakebase_vector 和 lakebase_text 扩展,提供可扩展的向量搜索与 BM25 全文检索,已在 AWS 和 Azure 正式可用。该方案突破 pgvector 内存瓶颈,支持存算分离、并行索引与混合搜索,可无服务器扩展至十亿级向量,兼顾高召回与低延迟。
Databricks 为 Lakebase Postgres 优化计算节点缓存:在固定规格计算上停用本地文件缓存,将共享缓冲区设为内存的75%,并启用2MB大页以减少页表和TLB开销。实测吞吐翻倍、延迟下降、CPU占用降低,存储读取请求大减。下一步将把大共享缓冲区扩展至自动伸缩计算。
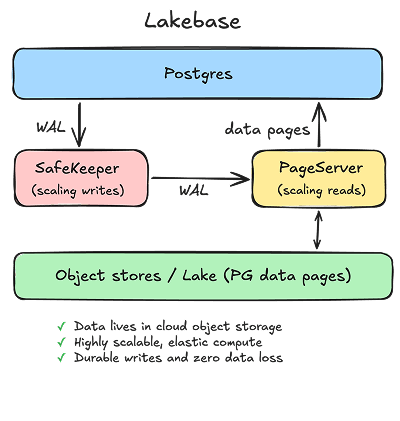
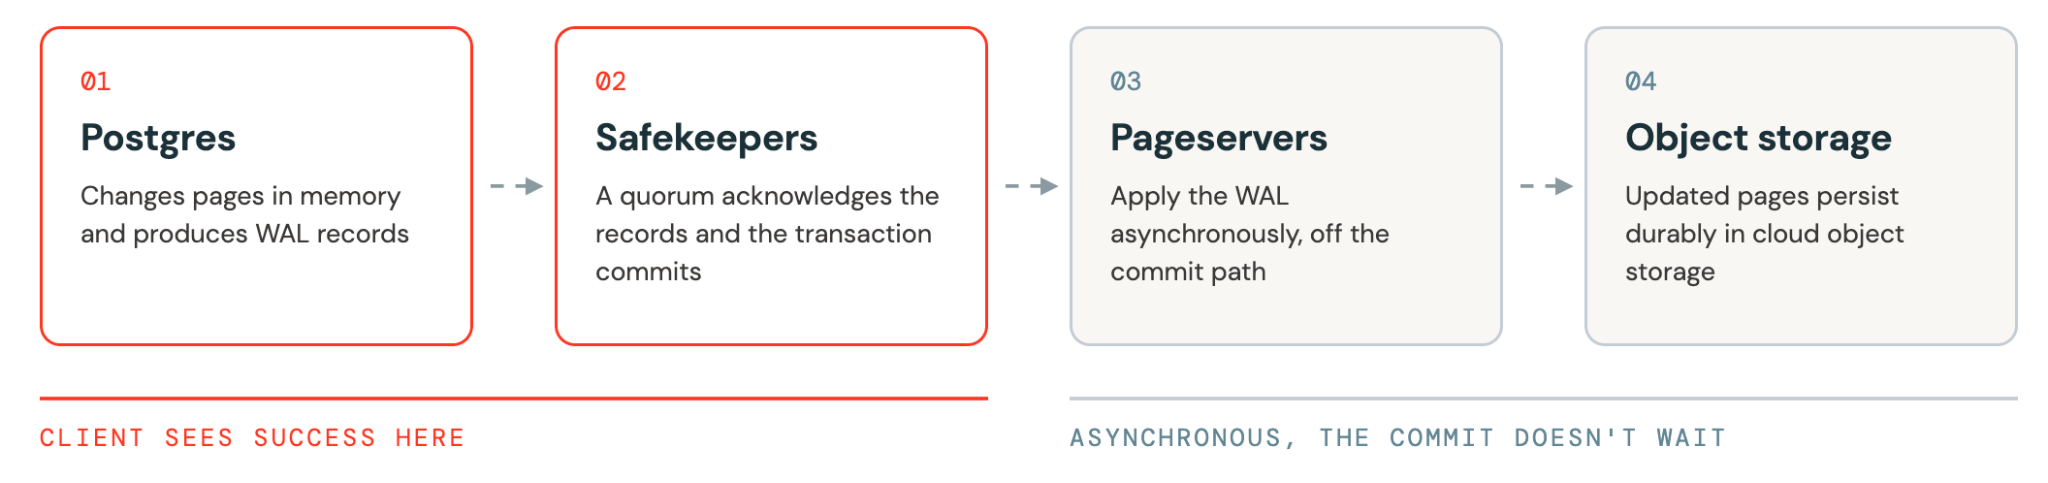
Lakebase Postgres将Postgres的WAL日志作为持久化数据源,使对象存储成为事务数据库的底层存储。通过将日志视为数据库,数据文件作为派生缓存,系统支持按LSN寻址历史数据,实现秒级分支、即时恢复和低成本副本。这使代理工作负载能安全操作数据库,并支持LTAP分析,无需复制数据。
完成下面两步后,将自动完成登录并继续当前操作。