
Lakebase Search:面向 Postgres 的最先进全文与向量搜索
内容提要
Databricks 在 Lakebase Postgres 上推出 lakebase_vector 和 lakebase_text 扩展,提供可扩展的向量搜索与 BM25 全文检索,已在 AWS 和 Azure 正式可用。该方案突破 pgvector 内存瓶颈,支持存算分离、并行索引与混合搜索,可无服务器扩展至十亿级向量,兼顾高召回与低延迟。
延伸解读
pgvector 的规模化瓶颈
文章指出,pgvector 的 HNSW 索引必须常驻内存才能保持毫秒级查询,一旦索引溢出到磁盘,性能会下降 10 到 50 倍。以 100 亿行 768 维向量为例,仅索引就需要约 330 GB 内存,且无法按工作集灵活配置。此外,索引构建和写入都受限于随机访问,在标准云实例上构建索引可能耗时近 50 小时,维护时还需全量重建并锁表。
存算分离如何突破内存墙
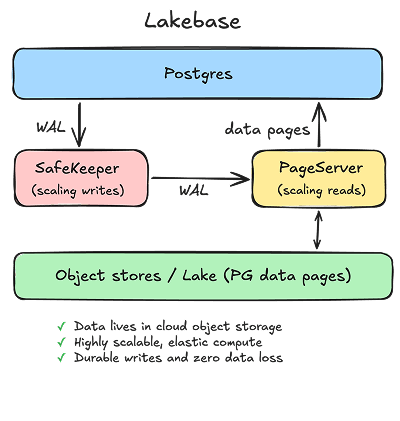
Lakebase Postgres 采用存算分离架构,持久数据存放在对象存储,内存和本地 NVMe 作为热数据缓存。lakebase_vector 利用量化向量在缓存时保持小内存占用,冷数据时只读取所需块,避免全索引扫描。索引构建先在小样本上训练聚类中心,之后每个向量独立分配、量化并写入对应块,可并行扩展,还能将构建任务卸载到 Spark 等分布式引擎,将时间缩短至分钟级。
混合搜索与无服务器弹性
lakebase_text 为 Postgres 带来原生 BM25 全文检索,通过全局逆文档频率(IDF)对稀有词加权,并利用分数上界跳过无关倒排块,速度优于传统 tsvector + GIN。与 lakebase_vector 结合后,可在单条 SQL 中融合语义向量与关键词相关性,并直接联表过滤。整个方案无服务器化,可从 1 行扩展到 10 亿向量,从 1 QPS 扩展到数千 QPS,无需手动重新配置。
Q&A
Lakebase Search 是什么?它包含哪些扩展?
Lakebase Search 是 Databricks 在 Lakebase Postgres 上推出的搜索解决方案,包含两个扩展:lakebase_vector(可扩展的近似最近邻搜索)和 lakebase_text(BM25 全文搜索)。两者均已在 AWS 和 Azure 上正式可用。
lakebase_vector 相比 pgvector 有哪些性能优势?
lakebase_vector 突破了 pgvector 的内存瓶颈,支持存算分离、并行索引和混合搜索。在 VectorDBBench 100M 基准测试中,其吞吐量是次优系统的两倍,成本比使用 pgvector 的云 Postgres 供应商低 4 倍,并在 97% 召回率下实现 71 毫秒的 P99 延迟。
pgvector 在大规模使用时存在哪些主要痛点?
pgvector 的主要痛点包括:1) 索引必须完全驻留内存,否则性能下降 10-50 倍;2) 写入和索引构建慢且昂贵,因为 HNSW 需要随机访问图遍历;3) 缺乏全局再平衡,维护需全量重建索引并锁表;4) 查询无法并行化,单进程执行,提高吞吐只能增加连接或只读副本。
lakebase_vector 如何实现可扩展的向量搜索?
lakebase_vector 利用存算分离架构,数据持久化在对象存储,RAM 和本地 NVMe 作为缓存。索引构建时先在小样本上训练质心,然后并行分配和量化向量,并可卸载到 Spark 等分布式引擎。查询时使用 1-bit 码快速筛选候选,再对短名单全精度重排,并支持并行扫描和过滤下推。
lakebase_text 提供了什么功能?它与标准 Postgres 文本搜索有何不同?
lakebase_text 为 Postgres 带来了原生 BM25 全文搜索,通过全局逆文档频率(IDF)对词项评分,重视稀有高意图词并惩罚常见填充词。它比传统的 tsvector + GIN 索引更快,因为它在遍历时评估分数上界,跳过无法进入 top-K 的整个 posting 块。
如何在 Postgres 中实现混合搜索?Lakebase Search 支持吗?
是的,通过结合 lakebase_text 和 lakebase_vector,可以在 Postgres 内实现原生混合搜索。在单个查询中,可以融合语义向量搜索与 BM25 关键词相关性,应用标准 SQL 过滤谓词,并直接与实时操作表连接。
Lakebase Search 的适用场景是什么?与 Databricks AI Search 有何区别?
Lakebase Search 适合希望将操作数据和搜索数据放在同一个数据库中的场景,尤其适合 AI 代理带来的极端突发性检索需求。Databricks AI Search 则是托管搜索引擎,适合无需手动调优即可获得高质量检索结果的场景。
