


重排序模型何时值得使用?
内容提要
本文讨论何时值得使用重排序模型:先用nDCG@10衡量候选列表与理想排序的差距以判断提升空间;测试分三步,建立基线、用交叉编码器重排10个候选、与调优后的融合结果对比;仅通过留出验证的增益才值得上线,若模型窗口或训练领域不匹配则放弃;确认胜出后再增加候选数并测量吞吐量。
延伸解读
先量化排序提升空间,再决定是否引入重排序
文章强调,在调优重排序模型前,应先计算候选列表的理想排序得分(nDCG@10)与当前管道得分的差距。这个差距代表了更好的排序阶段可能恢复的全部收益。如果差距大,说明值得尝试重排序;如果差距小,则可能不值得投入。文章在五个数据集上测得差距范围为0.247到0.487,但具体数值需在自己的数据上测量。
重排序模型必须与语料库匹配,否则可能无效
文章指出,重排序模型的上下文窗口和训练领域必须与你的文档匹配。例如,ArguAna查询平均168词,512令牌的模型会截断文档导致损失;而1024令牌的模型能扭转损失。CodeSearchNet上,只有训练过代码的jina-reranker-v2取得了确认的胜利。如果模型不匹配,即使重排序也可能失败,此时应保留调优后的融合结果。
候选数量应在重排序获胜后调整,而非之前
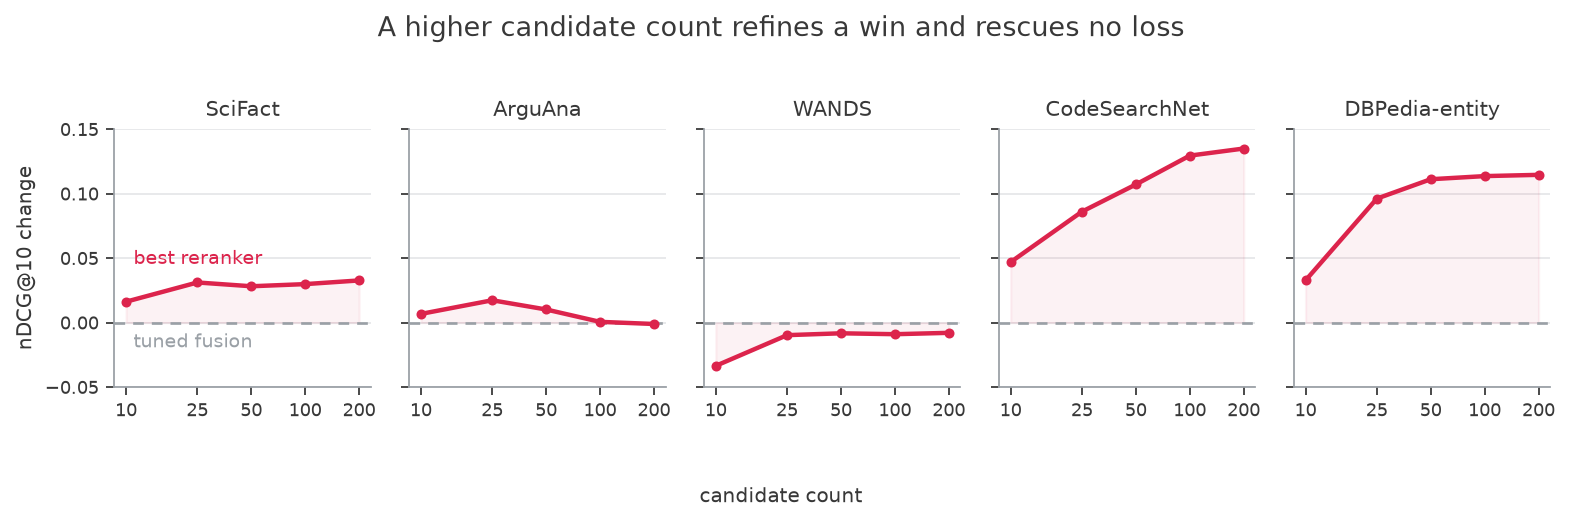
文章建议,先从10个候选开始测试重排序是否优于调优融合。只有在确认获胜后,才考虑增加候选数量。因为nDCG@10只评估前10个结果,增加候选数量只是给重排序更多选择。但增加数量可能带来收益,也可能因相关文档被挤出前10而受损。应测量相关文档在候选列表中的比例,选择比例仍在上升的最小数量。
生产部署需权衡吞吐量与收益
文章提醒,在将重排序模型投入生产前,必须测量其吞吐量和延迟。在CPU上,不同模型处理100个候选可能需要0.5到5秒,而融合阶段仅需0.6到1.5毫秒。因此,需根据硬件和文档长度评估是否值得。模型选择应基于匹配度而非大小,例如bge-reranker-base和jina-reranker-v2大小相近,但只有后者在特定数据集上胜出。
Q&A
如何判断我的检索系统是否需要引入重排序模型?
先用nDCG@10衡量候选列表与理想排序的差距。将候选文档按完美顺序打分,再与当前管线的得分对比,差距越大,说明重排序能恢复的空间越大。如果差距很小,可能不值得引入重排序。
测试重排序模型的具体步骤是什么?
分三步:1. 建立基线,即调优后的融合结果或当前排序,并确认相关文档在候选列表中;2. 用实际要服务的交叉编码器重排10个候选,与基线在留出查询上对比;3. 仅当重排序胜出时,才增加候选数量并测量吞吐量。
为什么重排序模型在有些数据集上有效,有些却无效?
主要因为模型与数据的匹配度。如果模型的上下文窗口太小,长查询或长文档会被截断,导致评分不完整;如果训练领域与语料不匹配(如代码数据),效果也会差。例如jina-reranker-v2在代码数据集上表现好,因为其训练数据包含代码且窗口更大。
重排序模型应该与什么基线进行比较?
应与你能构建的最强第一阶段比较,通常是调优后的融合结果(如调优的RRF),而不是默认的RRF。因为默认RRF可能通过调优就能达到类似效果,而重排序的计算成本更高。
如何决定重排序时使用多少候选文档?
从10个候选开始,确认重排序胜出后再增加。增加候选数时,需检查相关文档在候选列表中的比例是否还在上升。当比例趋于平缓时,增加候选数只会增加计算成本,甚至可能挤掉相关文档。选择能捕获大部分增益的最小候选数。
重排序模型在生产环境中的吞吐量如何?
在CPU上,小型交叉编码器(如MiniLM-L-6)处理100个候选约需0.5-2.1秒/查询,大型模型(如jina-reranker-v2)可能低于0.02查询/秒。GPU上jina-reranker-v2可达32-310文档/秒。需根据硬件和文档长度测量实际吞吐量。
如果重排序模型在10个候选上失败,应该怎么办?
先诊断失败原因:检查查询-文档对是否被模型窗口截断,以及模型训练领域是否匹配。如果存在不匹配,换用窗口和训练数据更合适的模型重试。如果模型匹配仍失败,则保留调优后的第一阶段,将调优精力投入其他地方。
