

提示词注入 VS 越狱:有什么区别? [译]
原文中文,约2500字,阅读约需6分钟。
📝
内容提要
本文讨论了提示词注入和破解问题,解释了两者之间的区别。作者还提到了相关研究和竞赛。
🔎
延伸解读
术语混淆的根源
文章指出,提示词注入和越狱常被混为一谈,部分原因是早期缺乏清晰定义。作者在撰写HackAPrompt论文时,发现学术论文中的定义不一致,甚至相互矛盾,这导致社区共识难以形成。这种混淆不仅影响学术交流,也可能让开发者在设计防御措施时抓错重点。
架构问题与训练问题的分野
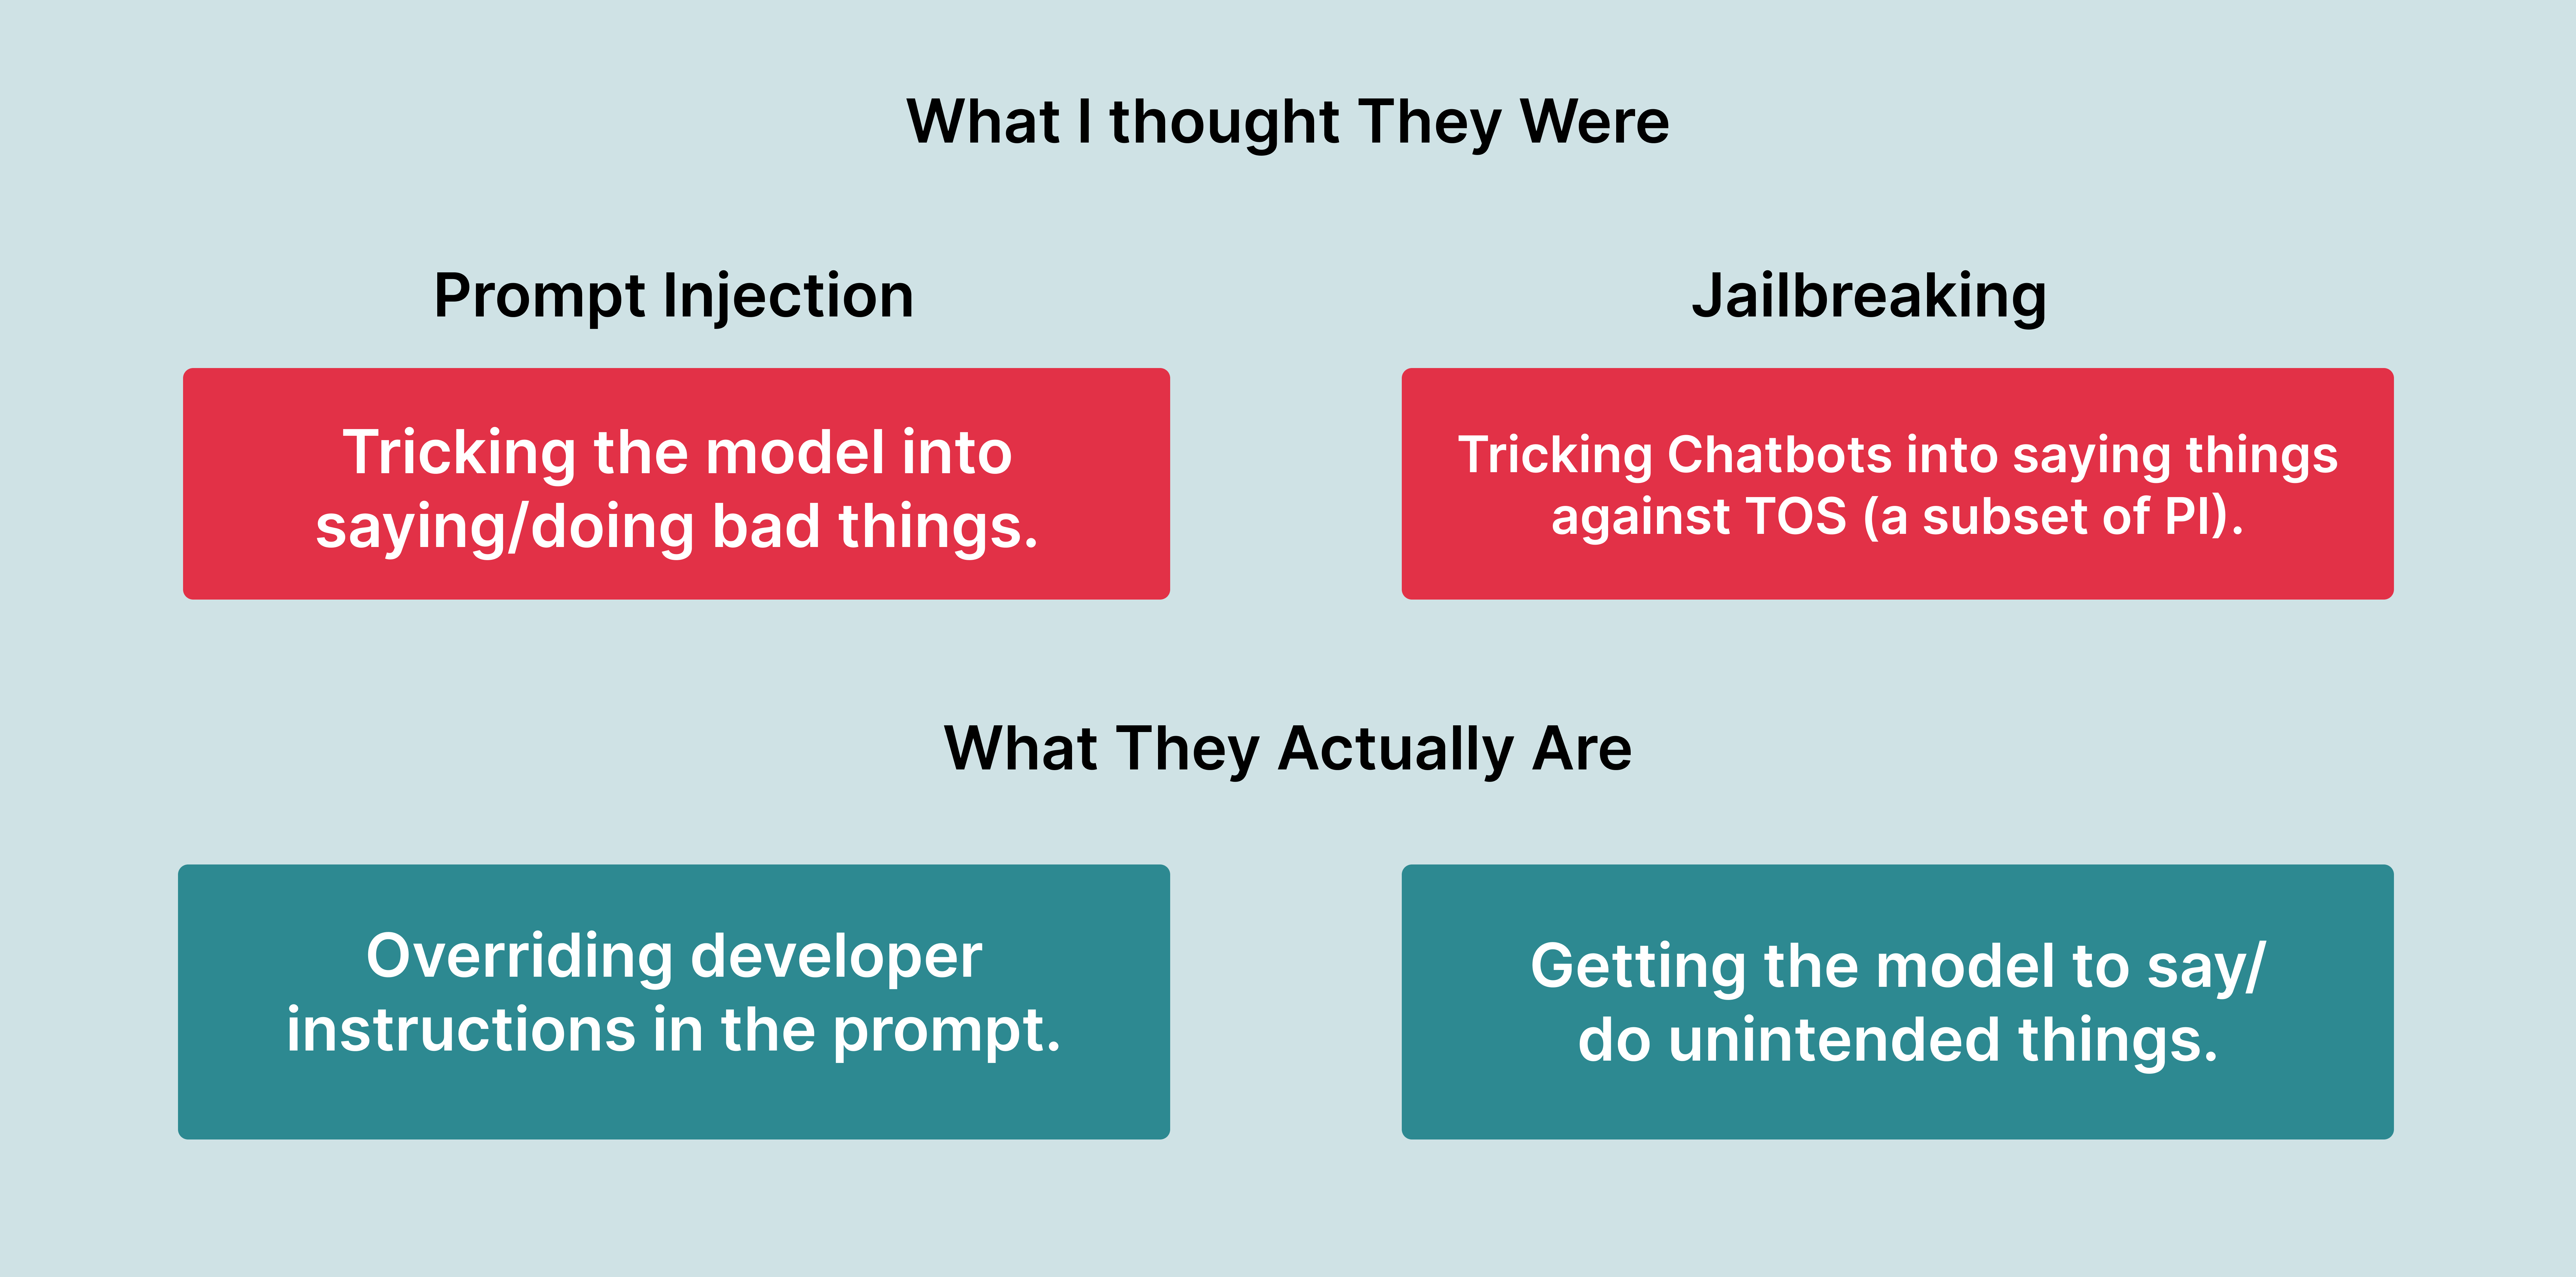
提示词注入源于模型无法区分开发者指令和用户输入,属于架构缺陷;而越狱则更多是训练问题,即安全对齐难以抵御对抗性提示。理解这一区别有助于针对性防御:前者需改进模型对指令来源的识别,后者需增强鲁棒性训练。
正当用途的启示
文章强调,提示词注入和越狱并非总是恶意。例如,研究人员可能利用越狱让模型回答敏感问题,以评估其在MMLU等基准上的表现。这提醒我们,在制定安全策略时需平衡风险与效用,避免一刀切地禁止所有对抗性提示。
❓
Q&A
提示词注入和越狱有什么主要区别?
提示词注入是诱导模型执行不当行为的过程,而越狱是特意诱导模型违反服务条款的行为。
提示词注入是如何影响模型行为的?
提示词注入通过不可信的用户输入覆盖开发者的原始指令,导致模型无法区分两者。
破解问题的主要挑战是什么?
破解问题的主要挑战在于难以防止对抗性提示词,导致模型可能输出不恰当的信息。
提示词注入和越狱可以用于哪些正当目的?
提示词注入和越狱可以用于评估模型在特定基准测试中的表现。
HackAPrompt是什么?
HackAPrompt是一个全球AI安全竞赛,旨在研究提示词攻击,吸引了数千人参与。
作者是如何改变对提示词注入和越狱的理解的?
作者通过社交媒体对话,特别是与Riley Goodside和Simon的讨论,改变了对这两个术语的理解。
🏷️
