


你从未发送的最便宜Token:基于MongoDB + Voyage AI的智能体AI搜索
内容提要
文章指出,生产级智能体AI搜索的最大成本往往不是模型调用,而是喂给模型的上下文;低相关上下文既费钱又稀释答案。文章介绍基于MongoDB向量搜索、Voyage AI嵌入与重排器的流水线:通过灵活维度和自动量化降低存储与查询成本;用$rankFusion在单次查询中融合向量与全文检索并加元数据过滤;再用重排器从宽召回候选中精选少量高相关片段送入LLM。示例显示输入token可减少约80%。核心观点:提升检索精度是同时降低token成本、延迟并改善答案质量的最廉价杠杆。
延伸解读
检索精度:同时解决成本、延迟与质量的杠杆
文章指出,生产级智能体AI搜索的三大痛点——高token成本、高延迟和答案质量下降——本质上是同一个问题:检索精度不足。低相关上下文不仅浪费输入token,还会稀释答案,甚至引发“迷失在中间”效应。因此,提升检索精度能同时改善这三个方面,是性价比最高的优化方向。
量化与灵活维度:降低向量存储与查询成本
Voyage AI嵌入支持256到2048维输出,允许在精度与索引占用间权衡。MongoDB向量搜索可自动量化:标量量化减少约3.75倍RAM,二值量化减少约24倍,且查询代码无需改动。这意味着每节点可存储更多向量,降低内存成本并加速搜索,适合大规模、成本敏感的部署。
重排器:大幅削减送入LLM的上下文token
文章示例中,先宽召回约20个候选块,再用Voyage重排器精选前4个送入LLM,输入token从约10,000降至2,000,减少约80%。重排器在已缩小的候选集上运行,速度快,其成本通常远低于节省的LLM输入token费用。这种“宽召回、精重排、小发送”的模式是降低token成本最直接的手段。
平台整合:减少智能体循环中的网络跳数与胶水代码
智能体搜索需要多轮检索与推理,每轮都是网络往返。将操作数据、向量、元数据、嵌入和重排统一在MongoDB Atlas平台,可避免维护独立向量库、嵌入服务和重排服务之间的同步与胶水代码,从而降低每轮延迟和运维复杂度,让智能体循环更高效。
Q&A
为什么说智能体AI搜索中最贵的Token是“你从未发送的”?
因为生产级智能体AI应用的最大成本往往不是模型调用,而是喂给模型的上下文。每个检索到的片段都是需要付费的输入Token,而低相关性的上下文不仅浪费钱,还会稀释答案质量。通过提升检索精度,减少发送给LLM的无关片段,就能同时降低Token成本、延迟并改善答案质量。
如何利用MongoDB和Voyage AI降低向量存储和查询的成本?
Voyage AI嵌入模型支持灵活维度(256到2048),可以在精度和索引占用之间权衡。MongoDB向量搜索支持自动量化,将浮点嵌入压缩为int8(标量)或二进制表示,标量量化减少约3.75倍RAM,二进制量化减少约24倍RAM,从而降低存储成本并加快搜索。
在MongoDB中如何实现混合搜索(向量+全文)并减少网络往返?
使用$rankFusion聚合阶段,在单次查询中融合$vectorSearch和$search管道,实现倒数排名融合(RRF)。这样无需在客户端合并结果,减少一次网络往返,并且可以附加元数据过滤器(如租户、日期范围)来避免检索无关数据。
重排器在智能体AI搜索流水线中起什么作用?能节省多少Token?
重排器使用交叉编码器模型对宽召回候选集按真实相关性重新排序,然后只保留最相关的少量片段(如top 4)送入LLM。示例中,从发送20个片段减少到4个,输入Token减少约80%,同时降低延迟并提高答案质量。
智能体循环(agentic loop)与传统检索-回答模式有何不同?
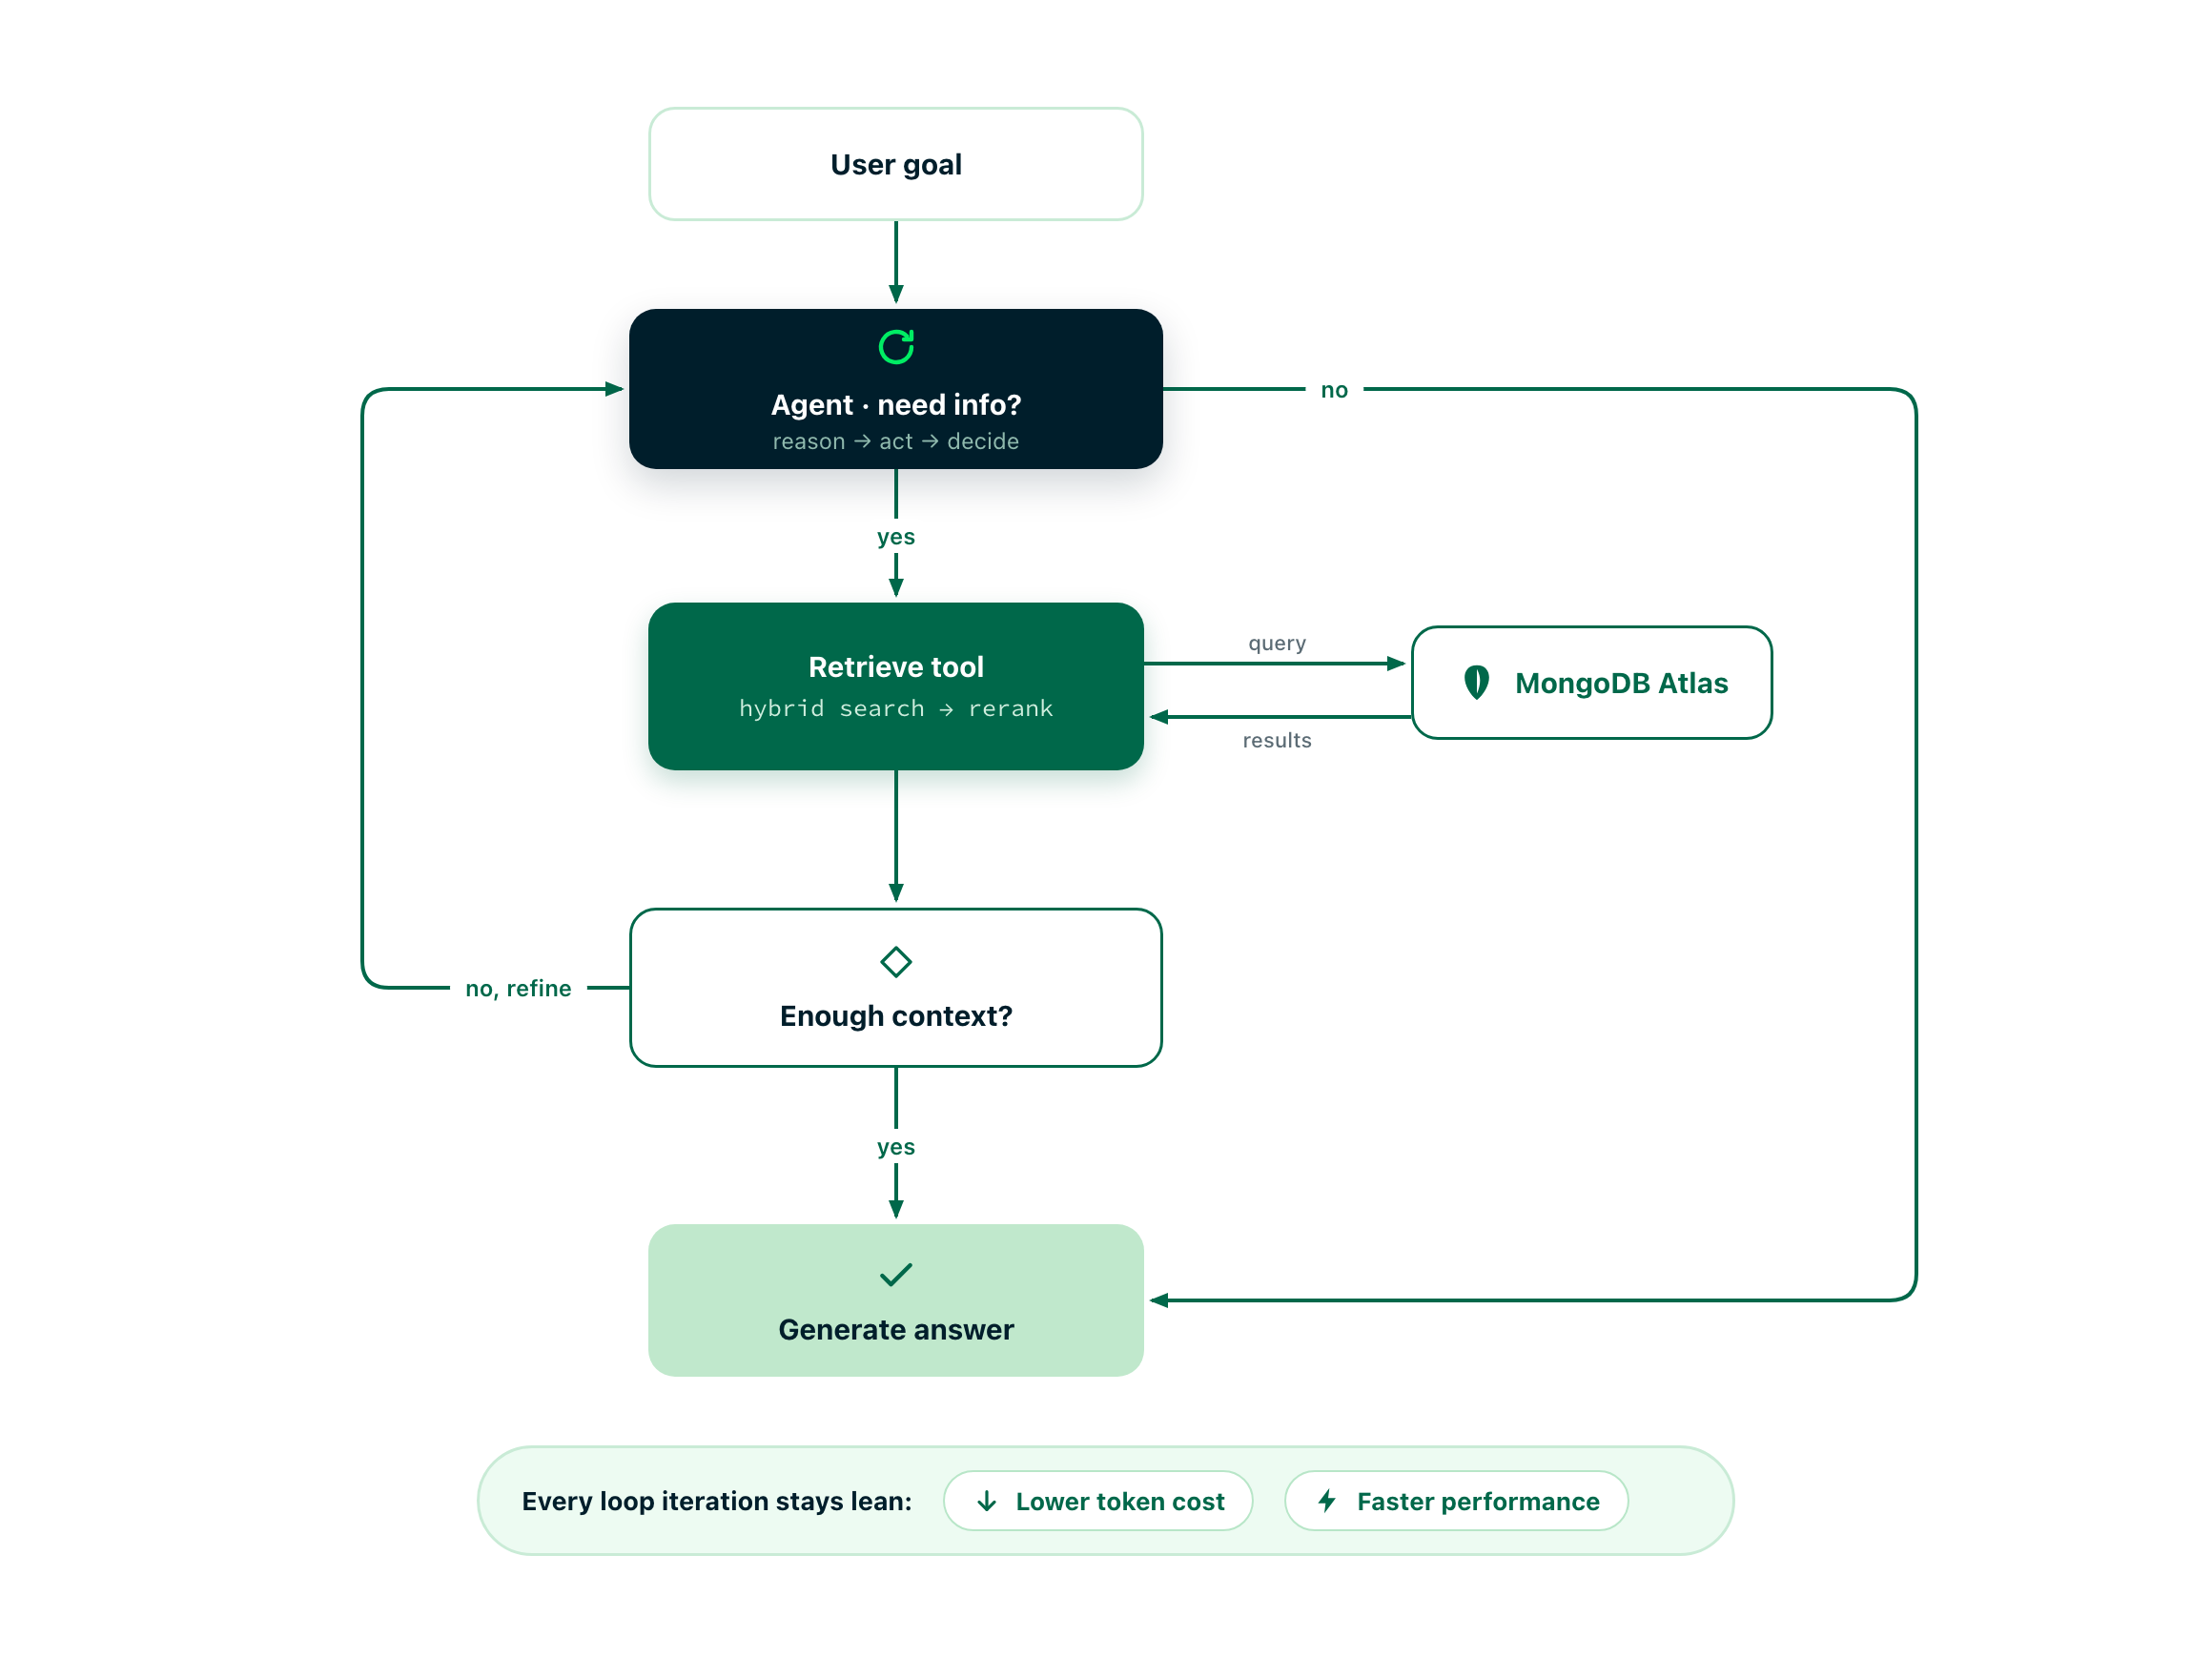
智能体循环让代理决定是否需要检索、发起一个或多个检索工具调用、评估返回结果,然后才生成答案,有时会循环优化查询。搜索成为代理采取并推理的动作,而不是固定的预处理步骤。在整合的Atlas平台上,每次迭代网络跳数更少,且更精准的检索减少每个代理步骤的Token消耗。
根据文章示例,采用“宽召回→重排→发送top 4”策略后,每月输入Token能减少多少?
示例中,假设每个片段约500 Token,每月10万次调用,朴素top-20方法每月输入Token为10亿,而宽召回后重排发送top 4方法每月为2亿,减少约80%。
在什么场景下应该选择二进制量化而不是标量量化?
当向量数量巨大、内存受限且对成本敏感时,选择二进制量化(约24倍RAM减少);如果希望获得大部分内存节省同时最小化精度损失,则选择标量/int8量化(约3.75倍RAM减少)。
