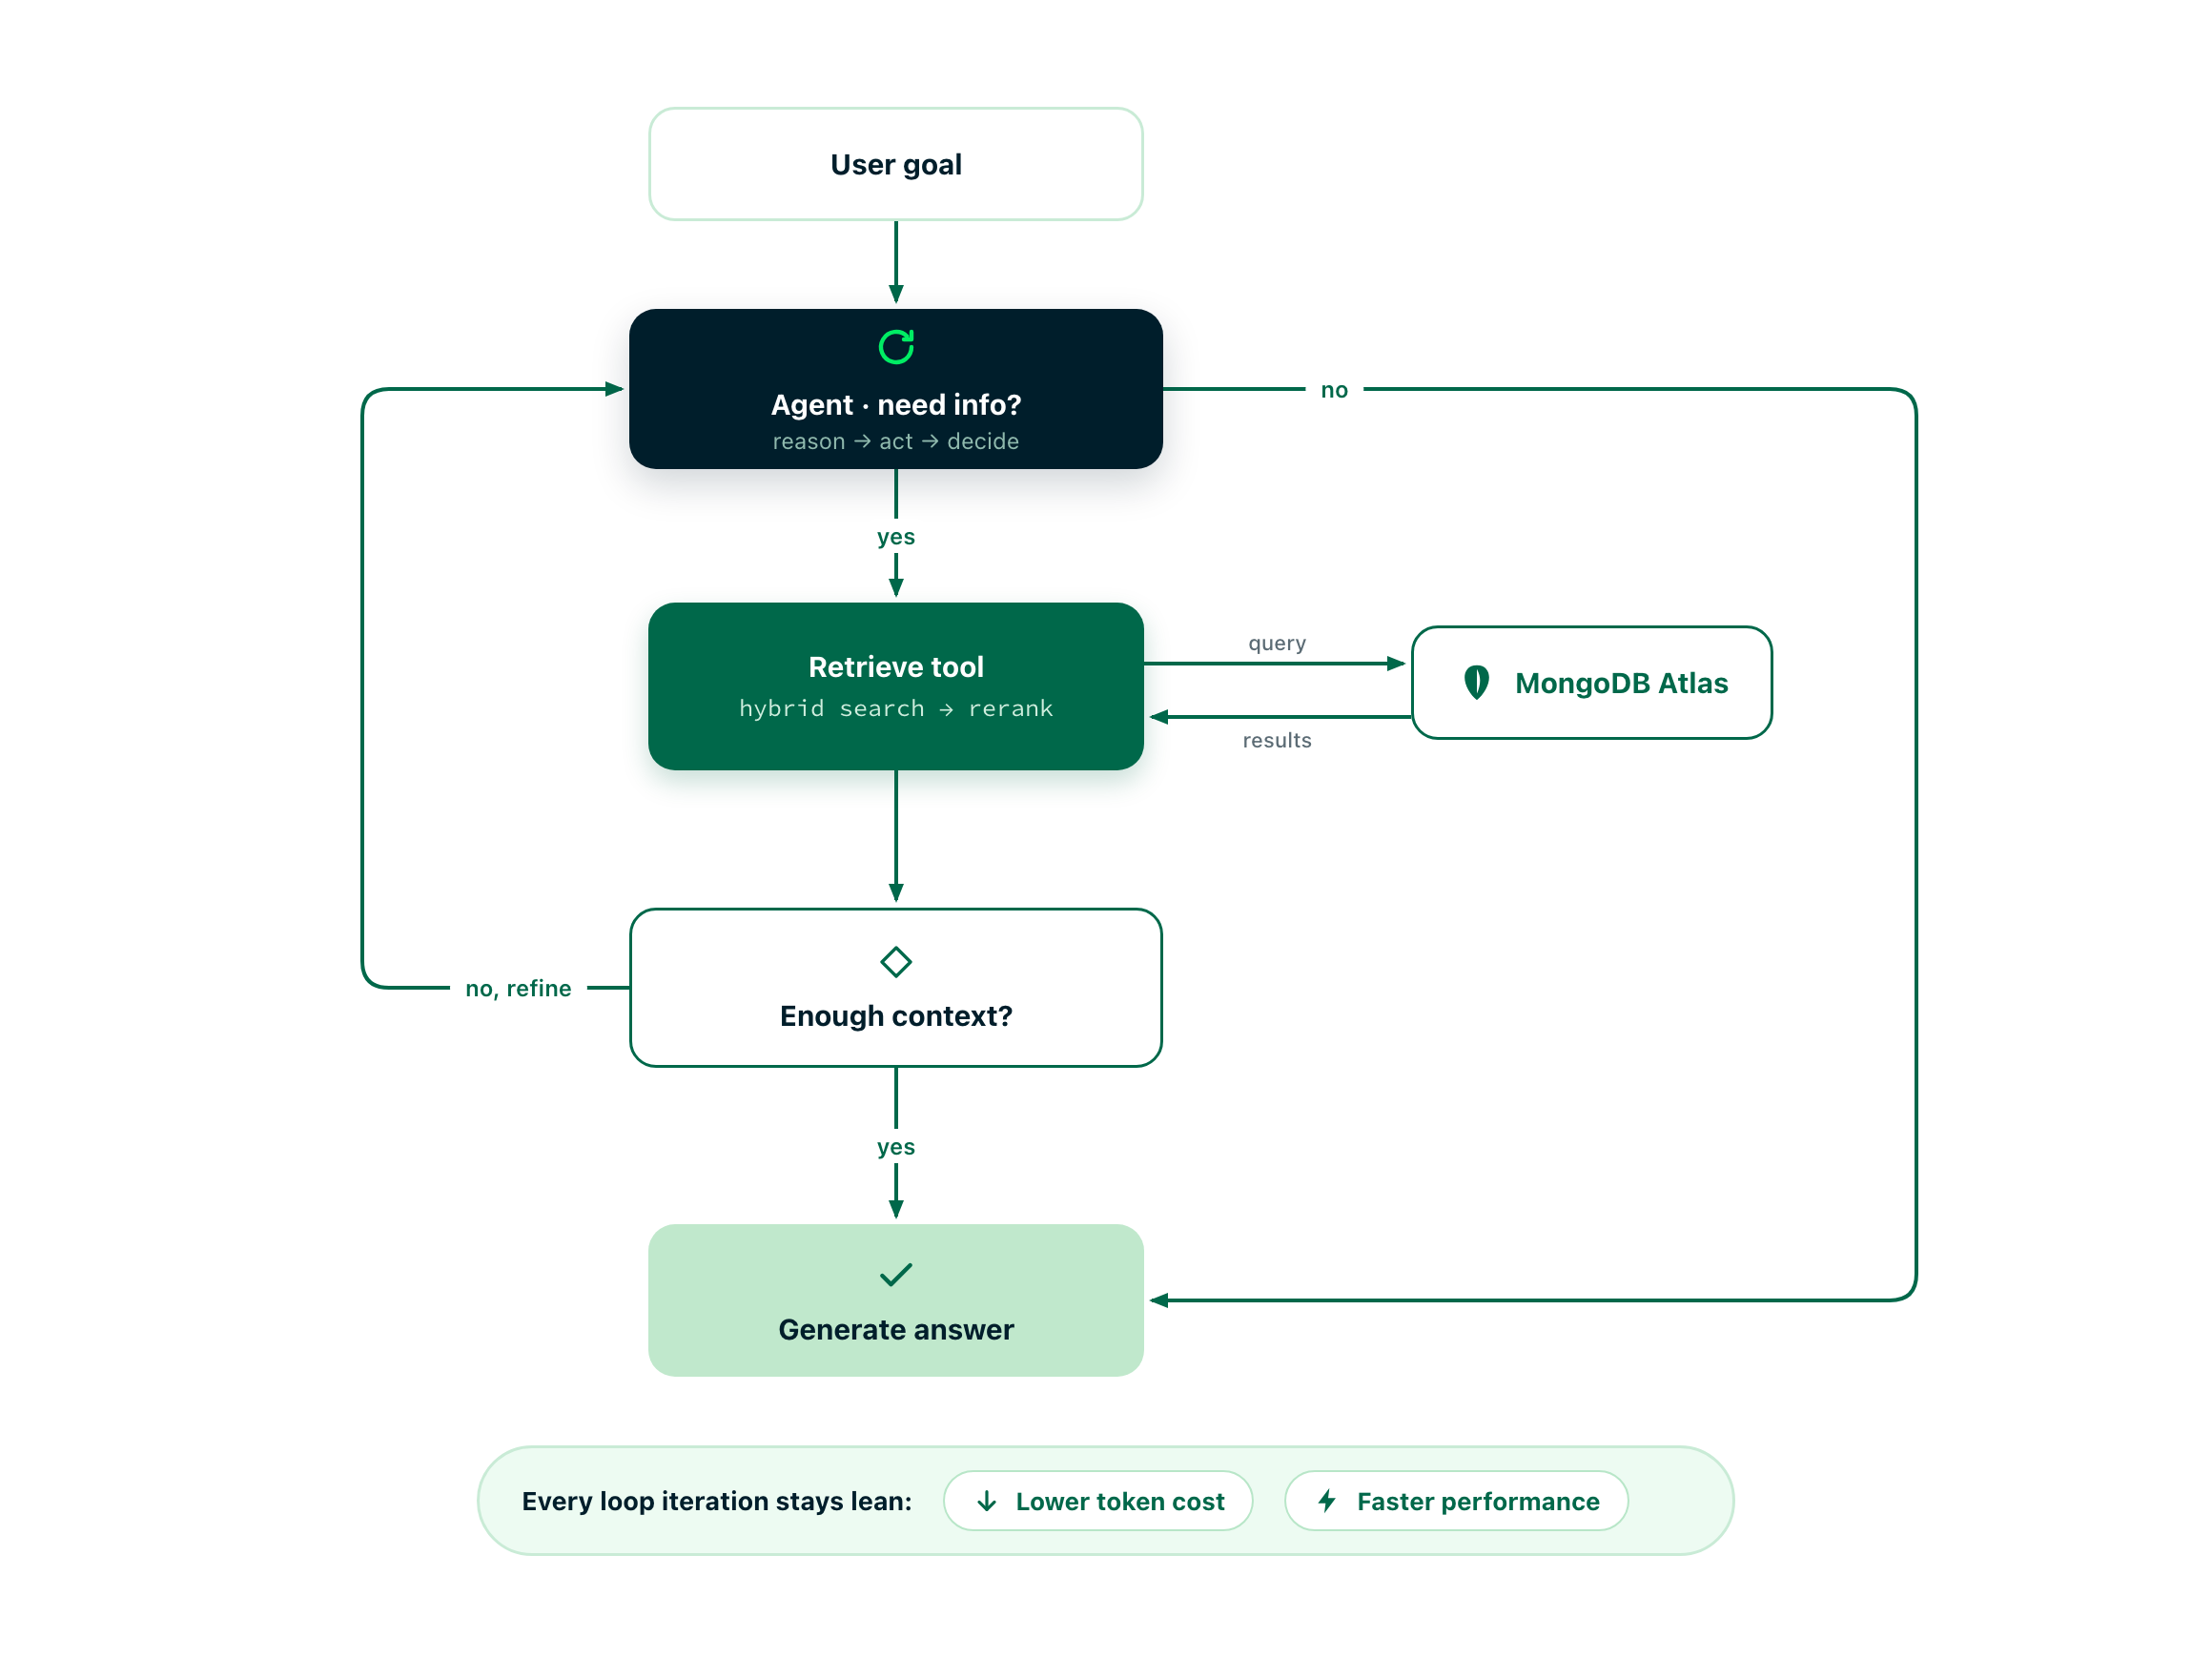
文章指出,生产级智能体AI搜索的最大成本往往不是模型调用,而是喂给模型的上下文;低相关上下文既费钱又稀释答案。文章介绍基于MongoDB向量搜索、Voyage AI嵌入与重排器的流水线:通过灵活维度和自动量化降低存储与查询成本;用$rankFusion在单次查询中融合向量与全文检索并加元数据过滤;再用重排器从宽召回候选中精选少量高相关片段送入LLM。示例显示输入token可减少约80%。核心观点:提升检索精度是同时降低token成本、延迟并改善答案质量的最廉价杠杆。
完成下面两步后,将自动完成登录并继续当前操作。