


JointRF: 动态神经辐射场表征与压缩的端到端联合优化 | ICIP 2024 Oral
内容提要
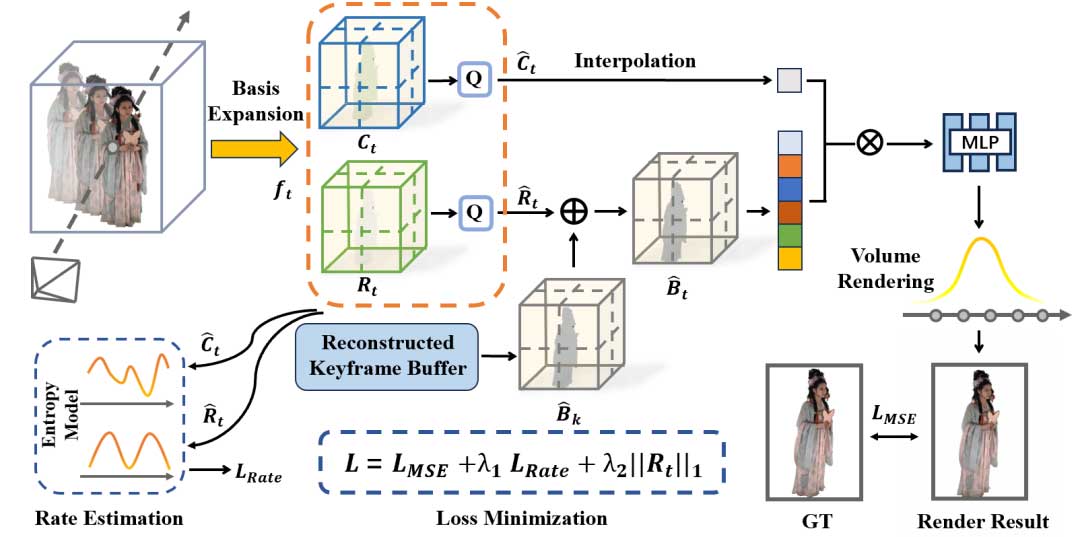
本文介绍了一种新的动态神经辐射场(NeRF)表示和压缩的方法,称为JointRF。该方法通过联合优化动态NeRF的表示和压缩,提高了质量和压缩效率。JointRF采用紧凑的残差特征网格和系数特征网格来表示动态NeRF,并引入了顺序特征压缩子网络来减少时空冗余。实验结果表明,JointRF在各种数据上实现了卓越的压缩性能。
延伸解读
动态NeRF的存储与传输挑战
动态神经辐射场能表示逼真的体积视频,但存储和传输面临巨大挑战,尤其是涉及任意运动和长持续时间的序列。直接将静态NeRF逐帧扩展会导致网络参数过多,而4D时空域方法在渲染质量和模型存储上表现欠佳。JointRF通过紧凑的残差特征网格和系数特征网格表示动态NeRF,并引入顺序特征压缩子网络减少时空冗余,为动态NeRF的实用化提供了新思路。
端到端联合优化的优势
传统方法如ReRF使用传统图像编码器压缩动态特征,但图像编码器不适合高维特征域,导致细节丢失和压缩效率降低。JointRF将表示和压缩子网络进行端到端联合训练,通过熵模型估计比特率并集成到损失函数中,鼓励特征分布低熵。消融实验表明,联合优化不仅减小模型大小,还略微提高PSNR,因为联合优化获得的特征更易于压缩且对量化误差更鲁棒。
实验性能与对比结果
在ReRF和DNA-Rendering数据集上,JointRF与INGP、MERF、TiNeuVox、ReRF等先进方法对比,以最低的模型存储获得了最好的重建质量。率失真性能方面,在ReRF数据集上训练和测试视图的平均BDBR分别减少51.28%和69.66%,在DNA-Rendering数据集上分别节省35.06%和36.38%。消融实验还显示,压缩方法将模型存储需求减少约40倍,同时保持相当的重建质量。
技术细节与创新点
JointRF将辐射场分解为系数特征网格和基特征网格,显式建模长参考基函数与非长参考基函数之间的残差特征网格。对于第一个关键帧,仅使用长参考基函数和系数网格表示;后续帧则使用紧凑的残差网格和系数网格补偿误差和新观察到的区域。此外,采用熵最小化压缩方法,不依赖预设特征分布,而是在训练中建模数据分布,实现精确的比特率估计和可微分的定量近似。
Q&A
JointRF的主要创新点是什么?
JointRF通过联合优化动态NeRF的表示和压缩,提高了质量和压缩效率,采用紧凑的残差特征网格和系数特征网格来表示动态NeRF。
JointRF如何减少时空冗余?
JointRF引入了顺序特征压缩子网络,以减少时空冗余,并通过动态残差表示来优化特征关联。
JointRF在实验中表现如何?
实验结果表明,JointRF在模型大小和重建质量方面优于其他先进方法,实现了卓越的压缩性能。
为什么传统的静态NeRF方法不适用于动态场景?
传统的静态NeRF方法忽略了场景的时空连续性,导致网络参数过多,不适合动态场景的表示。
JointRF的压缩方法有什么特点?
JointRF采用熵最小化压缩方法,确保辐射场特征具有低熵,从而提高压缩效率。
JointRF对体积视频的应用前景如何?
JointRF为体积视频的多种潜在应用奠定了坚实的基础,特别是在虚拟现实和远程呈现中提供身临其境的体验。
