


AI能帮助科学家识别有前景的候选药物吗?
内容提要
OpenAI推出MedChemBench基准,基于117篇论文和专利的99道题目,从分子结构重建、科学解释、化合物排序选择及性质预测四方面评估AI的药物化学推理能力。测试中GPT-6.2 Astra得分最高(84.5%),GPT-6 Astra为83.3%。模型在分子结构重建和实验证据解释上表现较强,但在化合物选择和数值性质预测上仅约一半得分。研究强调,该结果尚不能证明AI能发现新药或改进实验决策。
延伸解读
基准测试的局限:历史证据与真实研发的差距
MedChemBench基于已发表的117篇论文和专利设计题目,评估的是模型对历史证据的推理能力,而非真实药物发现流程。文章明确指出,结果不能证明AI能发现新药或改进实验决策,且无法排除模型此前接触过这些公开来源。此外,每个回答仅一次尝试,无工具、反馈或新实验。这意味着高分反映的是对已知信息的整合,而非在未知空间中探索的能力。读者需区分“推理测试”与“实际研发辅助”之间的鸿沟。
能力不均衡:结构重建强,选择与预测弱
在xhigh推理设置下,GPT-6 Astra在分子结构重建上获得95.4%的分数,科学解释也表现较强,但在化合物排序选择和数值性质预测上仅约一半得分。这种不均衡提示:模型擅长从给定信息中还原分子并解释已有证据,却在需要综合多属性权衡(如活性、渗透性、代谢稳定性)时明显吃力。药物化学的核心恰是权衡相互竞争的属性,因此当前模型更适合辅助结构核对与证据梳理,而非独立决策。
推理投入与收益:提高设置能涨分,但差距仍在
文章测试了11个GPT模型在不同推理努力下的表现,发现提高推理设置普遍能提升分数,例如GPT-6 Astra在max effort下达到83.8%,略高于xhigh的83.3%。但模型间的大幅差异依然存在,GPT-5.6 Sol在xhigh下仅58.2%。这说明增加推理 token 能带来一定增益,却无法弥合代际能力差距。读者应关注:高分模型在关键弱点(如数值预测)上的提升是否随推理投入而改善,而非只看总分。
Q&A
MedChemBench是什么?它主要评估AI的哪些能力?
MedChemBench是OpenAI推出的一个基准测试,用于评估AI模型在药物化学研究中的推理能力。它通过99道源自117篇论文和专利的题目,从四个方面测试模型:分子结构重建、科学解释、化合物排序与选择、以及性质预测。
在MedChemBench测试中,哪个AI模型表现最好?得分是多少?
在xhigh推理设置下,GPT-6.2 Astra得分最高,获得84.5%的可用分数;GPT-6 Astra紧随其后,得分为83.3%。其他模型如GPT-6.1 Sol得82.0%,GPT-5.6 Sol得58.2%。
AI在药物化学推理中哪些方面较强,哪些方面较弱?
根据MedChemBench结果,AI模型在分子结构重建和科学解释方面表现较强,例如GPT-6 Astra在结构组件上获得95.4%的分数。但在化合物选择和数值性质预测上较弱,仅获得约一半的分数。
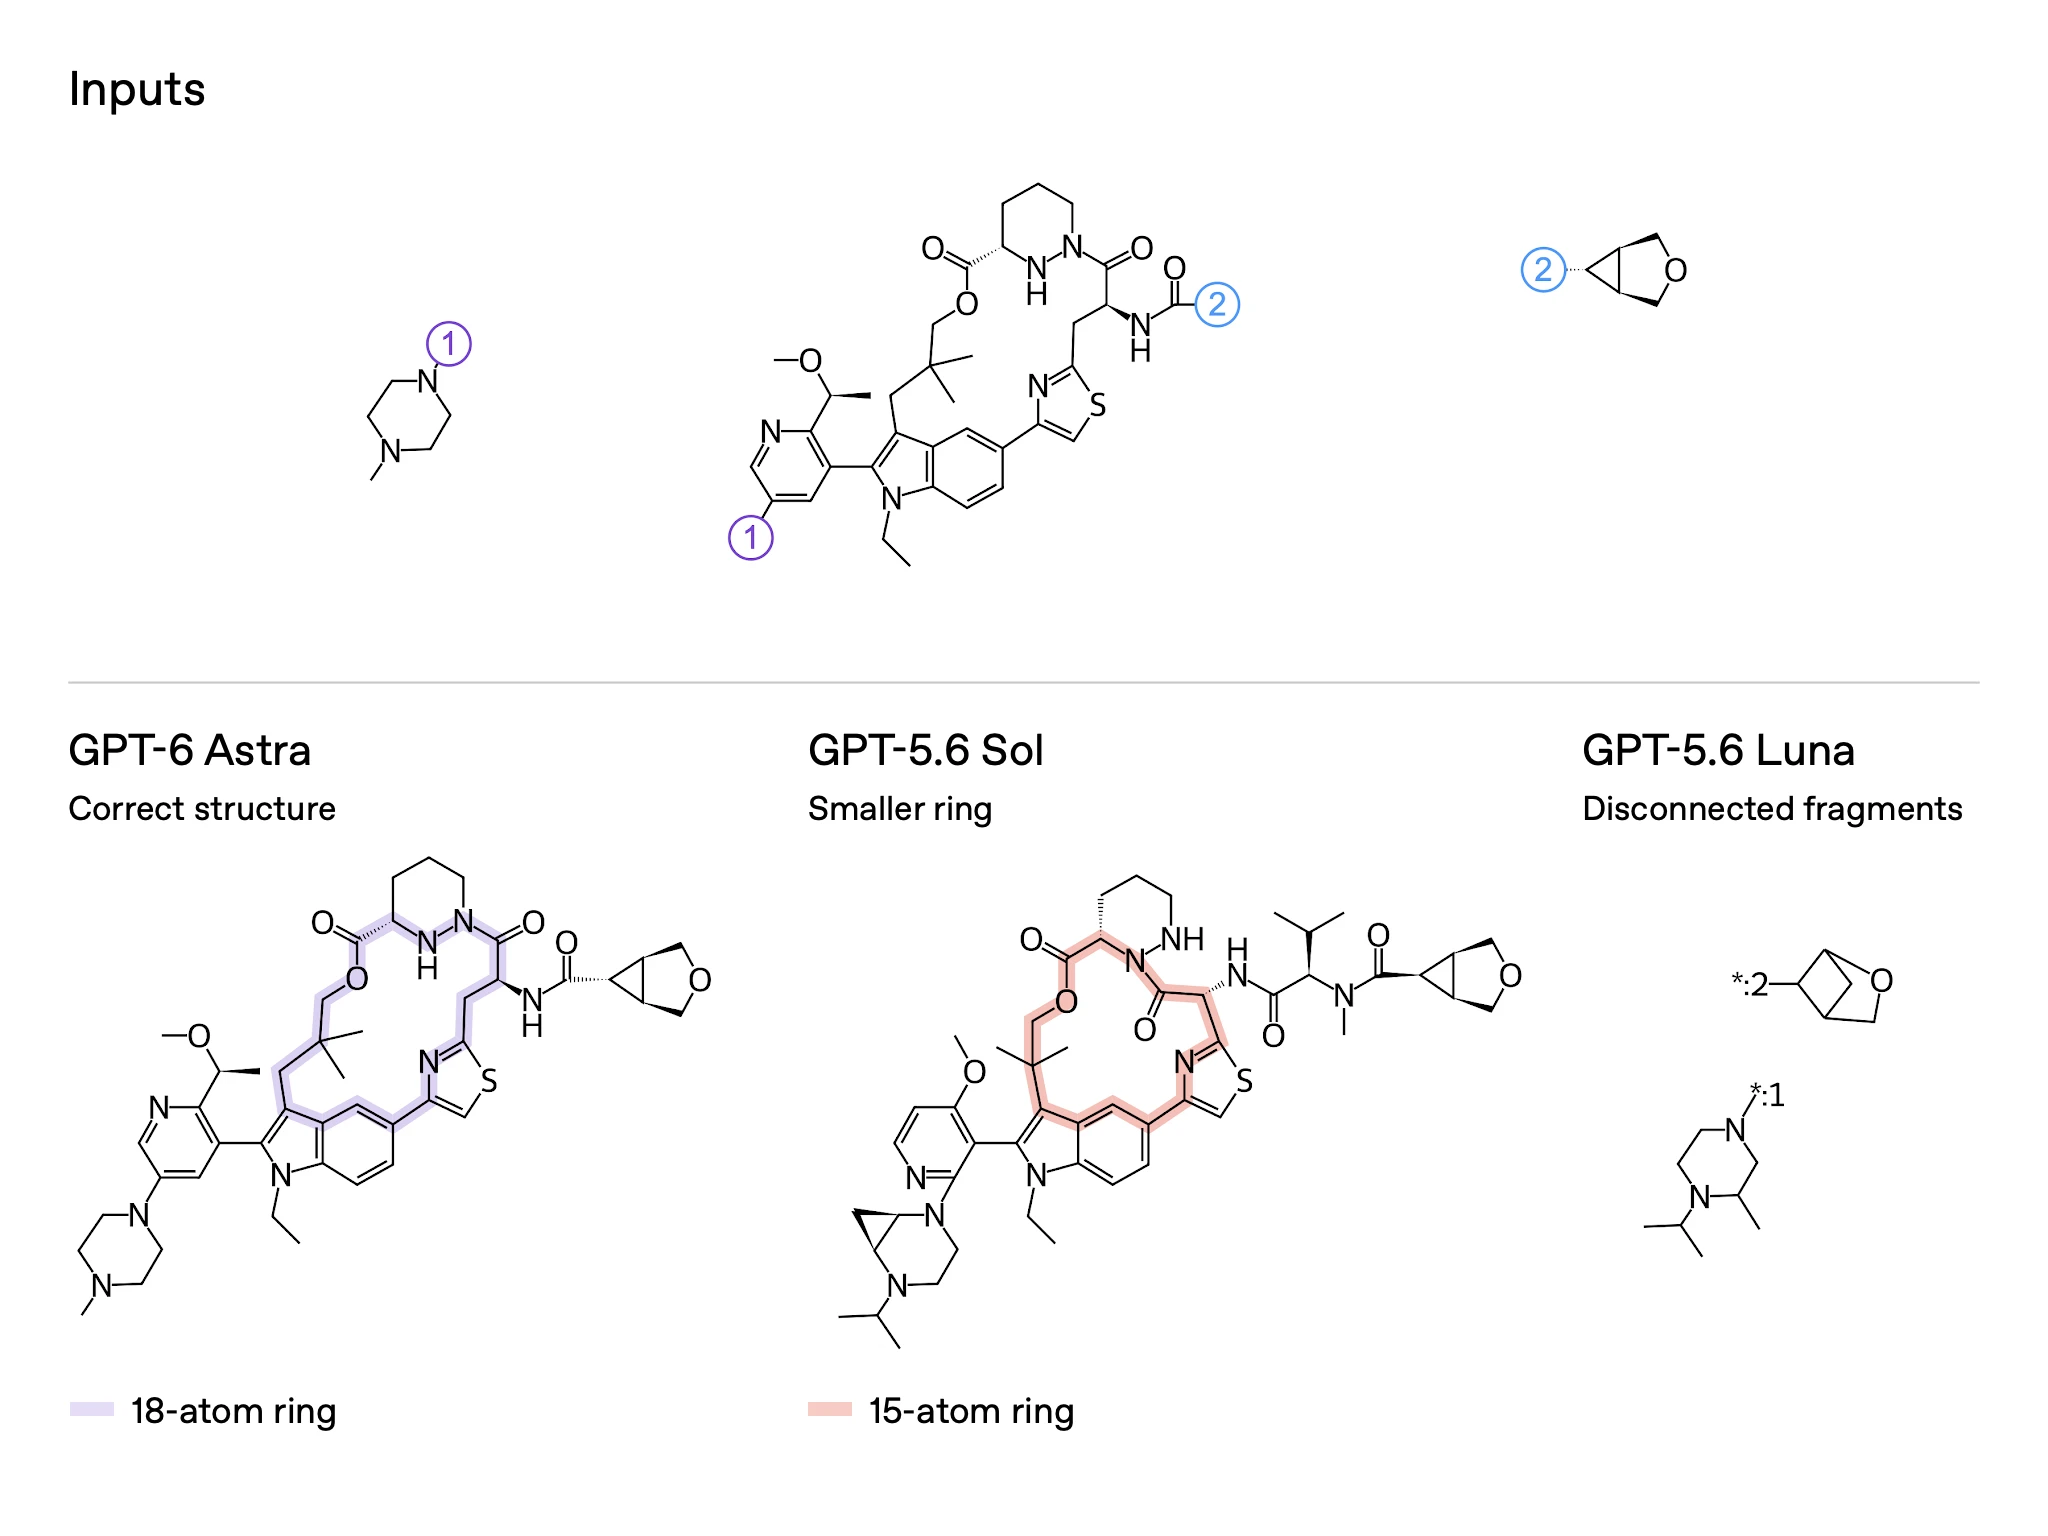
MedChemBench如何测试AI对分子结构的理解?
MedChemBench要求模型根据提供的化学 drawings 和基团重建分子,确保原子连接和立体化学正确。例如,一个任务要求模型组装一个保留18原子环的分子,测试模型能否准确表示化合物结构。
MedChemBench中的化合物性质预测任务具体是怎样的?
任务提供分子结构和先前实验结果,要求模型预测相关化合物的多种性质,如抑制靶蛋白的强度、细胞通透性和肝酶降解速度。预测结果根据与实验值的接近程度获得部分分数,测试模型连接结构与多种性质的能力。
MedChemBench的结果能否证明AI可以发现新药?
不能。研究强调,这些结果尚不能证明AI能发现新药或改进实验决策。模型可能接触过已发表的来源,且每次响应都是单次尝试,没有工具、反馈或新实验。该基准评估的是基于历史证据的推理,而非真实药物发现。
