

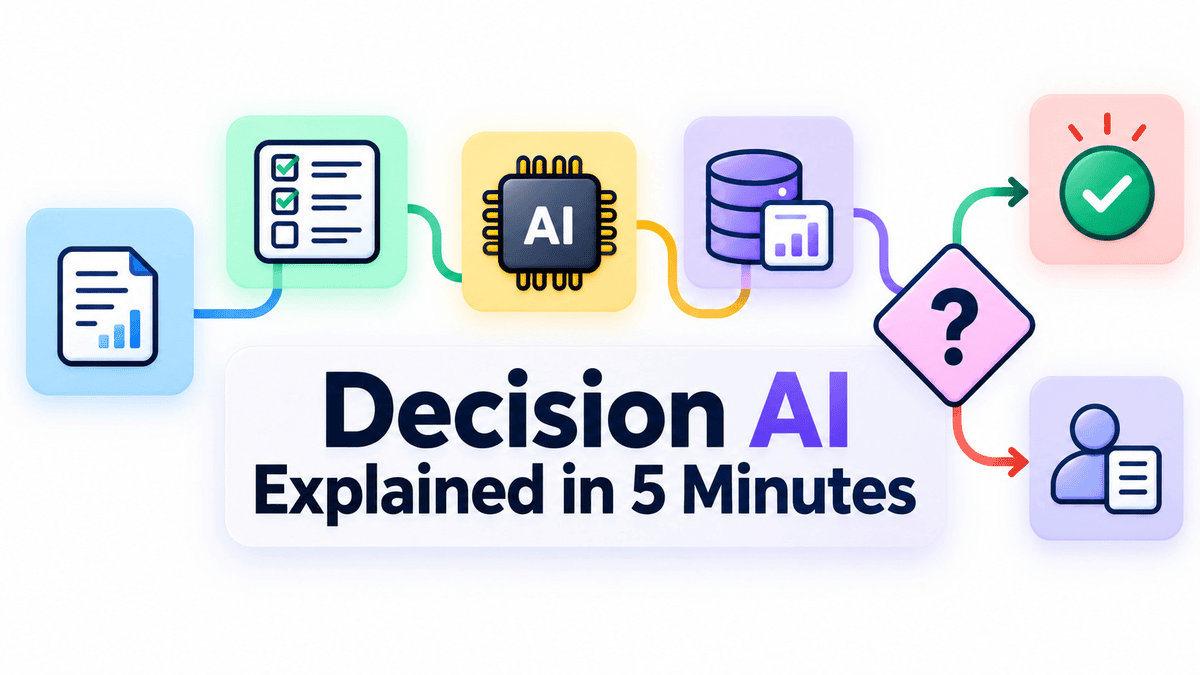

5分钟了解决策AI
内容提要
决策AI不生成文本,而是从预设答案中选择并返回概率,支持选择、评分和是/否三类问题,适合客服分类等高频场景。可将LLM的logits经softmax转为概率,或替换输出层微调。开源模型有Laya、Kev、Simple Jev、Decider、SemIf。llama.cpp和Ollama已支持本地运行,可降低成本并保护数据,但可靠性仍需校准与人工审核。
延伸解读
决策AI与生成式LLM的本质区别
决策AI不生成文本,而是从预设答案中选择并返回概率,支持选择、评分和是/否三类问题。与LLM逐词生成不同,它直接输出结构化结果,适合客服分类等高频场景。例如,客户邮件“被重复收费”可被分类为“账单”部门并返回概率,无需生成解释。这种设计让应用能直接使用答案,避免从段落中提取信息。
将LLM改造为决策模型的两种路径
文章介绍了两种方法:一是提取LLM对预设答案的logits,经softmax转为概率;二是替换输出层为小型预测头并微调,支持单次前向传播中评分多个选项。前者无需训练,后者更高效。例如,产品评论分类中,正面和负面logit经softmax得到约73%和27%的概率。这跳过了逐词生成,使重复决策更快。
开源决策模型与本地运行选择
开源社区提供了Laya、Kev、Simple Jev、Decider和SemIf等模型,各具特点:Laya轻量支持百种语言,Kev基于Qwen参数范围0.8B到27B,Simple Jev可直接用Hugging Face模型分类,Decider单次前向支持最多255个选项,SemIf专注本地并支持多种硬件。llama.cpp和Ollama已支持本地运行,可降低成本并保护数据。
可靠性是决策AI落地的关键挑战
文章指出,决策AI的最大挑战是可靠性:模型给出的置信度(如95%)是否可信需要验证。在实际自动化前,应在真实数据上测试准确率和概率,并依赖更好的训练、校准和人工审核。此外,开源模型虽可本地运行,但需注意其与闭源API的差异,以及不同模型在基准测试中的表现可能不同。
Q&A
决策AI和普通大语言模型有什么不同?
决策AI不生成文本,而是从预设答案中选择并返回概率,支持选择、评分和是/否三类问题。普通LLM则生成文本,适合需要自然语言输出的任务。
决策AI能处理哪些类型的问题?
决策AI支持三种类型的问题:选择(如选择部门)、评分(如评估紧急程度)和是/否(如判断是否为垃圾邮件)。
如何将现有的大语言模型改造成决策模型?
可以提取LLM对预设答案的logits,通过softmax转换为概率;或者替换输出层为小型预测头,并在决策任务上微调模型,从而在一次前向传播中完成多个决策。
有哪些开源的决策AI模型或框架?
开源决策AI模型包括Laya(支持100+语言)、Kev(基于Qwen,0.8B到27B参数)、Simple Jev(无需训练即可分类评分)、Decider(单次前向传播处理多决策)和SemIf(支持本地运行)。
如何在本地运行决策AI模型?
可以使用llama.cpp或Ollama,它们支持决策模型并通过/v1/systemone端点调用。例如用llama.cpp运行Laya:先启动服务(llama serve -hf ggml-org/Laya-GGUF),然后发送包含状态和问题的JSON请求即可获得决策结果。
决策AI的主要挑战是什么?
最大的挑战是可靠性,即模型给出的置信度是否可信。需要更好的训练、校准和人工审核来确保决策质量。
