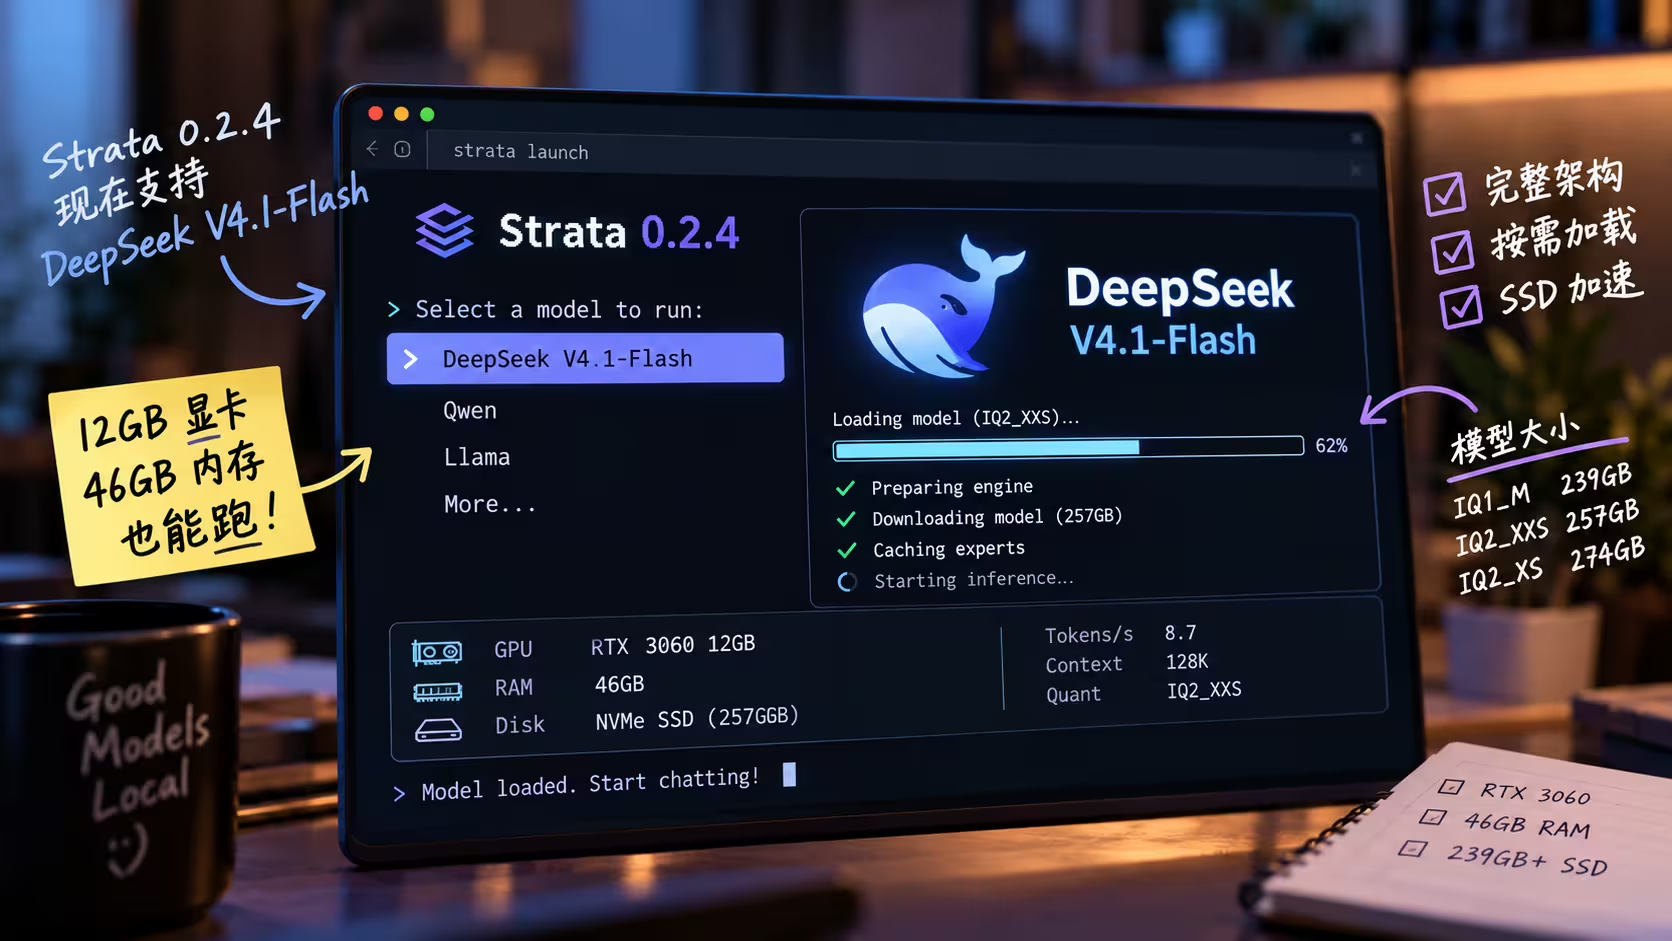
Strata 0.2.4 终端版可在配备12GB显存显卡(如RTX 3060)和46GB内存的普通电脑上本地运行DeepSeek V4.1-Flash量化模型。该方案采用MoE“热门专家缓存”机制,将常用专家保留在内存中,其余存放于SSD,需至少239GB硬盘空间。提供1.75至2.25-bit三个量化版本,最低版本基准测试性能约为原版的98.7%。实测生成速度为8~10 tokens/s,适合聊天测试。目前仅支持Windows/Linux系统下的NVIDIA及部分AMD显卡。
Jack Dorsey旗下Block发布AI语音模型Dessa,完全基于人类对话从零训练,是真正的语音到语音模型,可在MacBook Pro M4 Max或更高配置上本地运行。演示对话自然但偶显尴尬,如误认对方名字、谈及电影时跑题。团队称开发动机是好奇心、促进人机理解与安全,因现有语音AI忽视语调情感。将先向少数AI安全研究者开放早期访问。
开发者推出精力管理应用Pikko,面向P型和ADHD人群,解决传统任务工具“记了不做”的问题。该应用从精力、设备、场景、心境四个维度描述任务,结合作息与心率数据计算当前精力值,自动推荐合适任务,并提供小票打印机、专注围栏、印章工坊等功能。应用完全本地运行以保护隐私,基础功能免费,高级功能需付费解锁。
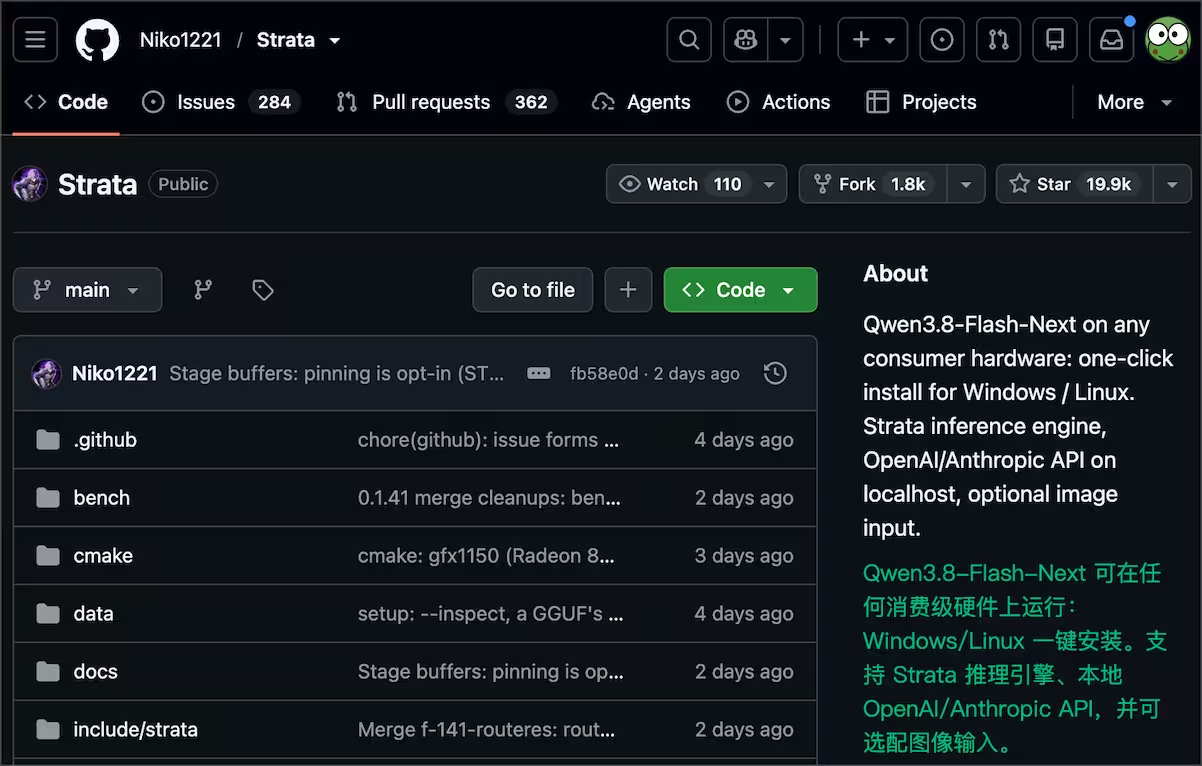
开源项目 Strata 支持在普通电脑本地运行千亿参数大模型 Qwen3.8-Flash-Next,通过将部分模型放入内存和固态硬盘,8GB 显存即可运行,但内存需 32GB 起步、推荐 64GB。生成速度约 20 至 70 tok/s,40 以上可用,无需 API 费用,AMD 用户可用 gufo。
Ollama 简化了本地语言模型运行,但需确保模型与上下文能装入内存。`ollama ps` 可查看模型占用及 GPU/CPU 分配,低于 100% GPU 表示部分已转 CPU,生成变慢。macOS 桌面应用需通过 `launchctl setenv` 设置环境变量,否则配置无效。传入 JSON schema 可约束结构化输出,而 "json" 仅保证合法 JSON。速查表还涵盖磁盘管理、API 端点、Modelfile 及环境变量。
AMD在IFA 2026发布Personal AI战略,推出Ryzen AI Max 400、HP ZBook及Threadripper Halo Station,支持本地运行大模型。强调本地计算、隐私与个人上下文,以降低AI成本。开源模型如GLM、Qwen可本地运行,性能优于云端,推动AI从云端转向个人设备。
Perplexity与Nvidia合作推出Portable Computer,将AI助手Computer带到桌面,需Nvidia RTX显卡(至少24GB VRAM)或DGX Spark。它本地运行模型,支持文件编辑、命令执行等,通过沙箱保障安全,必要时可请求云端模型建议。支持Qwen3.8-27B等模型,性能优于同类,面向Pro等订阅用户,Windows支持九月推出。
JetBrains团队优化Qwen3.6-27B模型以支持Junie本地运行,通过扩展滚动上下文复用KV缓存、调整提示词顺序、禁用推理模式提升速度,并采用4位量化及优化推理引擎的预填充和投机解码。相比Qwen3.8,3.6无需推理模式,性能更佳,适合Mac硬件。
openleetcode 是一个用 Haskell 编写的开源工具,旨在本地运行 LeetCode 测试用例,将判题环境透明化。它支持 12 种语言,通过 YAML 文件存储测试数据,并利用 Docker 和 Piston 后端执行。项目强调开源测试用例,让用户无需猜测黑盒逻辑,但测试质量依赖社区维护,且不支持系统设计、SQL 等题型。其核心价值在于打破 LeetCode 的神秘感,提供可调试、可追溯的本地刷题体验。
小型语言模型(SLM)虽知识量有限,但适合本地运行,可处理三类任务:保密数据文档结构化、批量分类(如邮件路由)及低延迟即时响应。关键在于将知识外置(如用模式约束输出),避免依赖模型记忆,并注意上下文窗口和推理限制。
阿里巴巴发布Qwen3.8-27B模型,采用Apache 2.0许可,可在MacBook Pro等本地设备运行。其性能接近Anthropic Opus 4.6,在编码和知识任务上超越旧旗舰,并具备视觉能力。尽管存在过度思考、量化质量损失等局限,但整体表现亮眼,优于Meta的Glimmer-30B。社区已提供MLX转换,4位版本约16GB,适合32GB内存Mac运行。
该文章介绍PipeNetwork的kimi-k3-mlx项目,将Moonshot AI的2.8T参数MoE模型Kimi K3转换为苹果芯片MLX格式,通过流式转换和REAP剪枝技术删除73%专家,将模型从1.6TB压缩至350GB,使Mac Studio等大内存设备能本地运行,展示了巨型模型个人化的工程路径。
本文介绍如何在本地运行Qwythos-9B-Claude-Mythos-5-1M模型,该模型为9B参数推理编码模型,适合消费级硬件。通过llama.cpp安装并启动服务,设置100K上下文和MTP推测解码,在RTX 4070 Ti Super上达到81.74 tokens/秒。随后安装Pi及llama插件,连接本地服务器作为编码代理。测试显示模型能成功构建浏览器游戏和CSV转Excel CLI工具,表现快速准确,无需外部API,适合日常编码任务。
2017年谷歌团队发表论文《Attention Is All You Need》,提出Transformer架构,使机器翻译从逐词处理转向理解上下文,成为ChatGPT等大模型的基础。文章随后介绍QVAC平台,支持在移动设备本地运行翻译模型,无需云端,保护隐私,并展示英译法应用的完整实现代码。
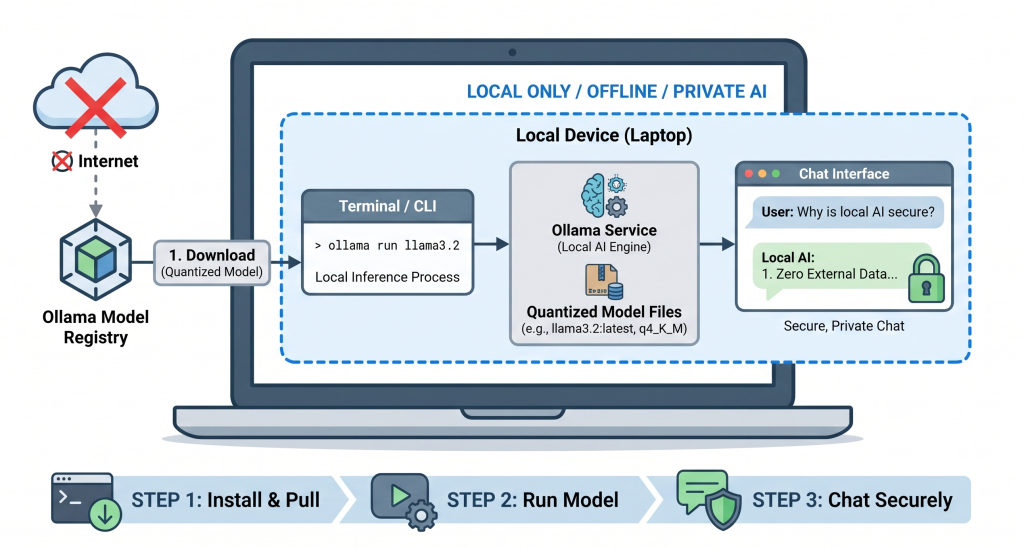
本文介绍了如何在15分钟内使用Ollama在本地运行小型语言模型。用户只需安装Ollama、下载模型(如Llama 3.2 3B)并开始聊天。Ollama通过量化技术减少内存占用,确保模型高效运行,保障数据安全和隐私。
本文介绍了如何使用JavaScript构建一个基于浏览器的PDF图像提取工具。用户可以上传PDF文件,预览页面,提取嵌入的图像,并按页面组织下载。该工具在本地运行,确保用户隐私,提取的图像保持原始质量,适用于设计、营销、教育等多个行业。
本文探讨了在本地运行生成模型进行编码的可行性,分析了影响模型性能的因素,如内存、处理器核心、模型参数和推理能力。尽管小型模型在工具调用上存在困难,但Qwen3.6 35B MoE模型在能力、速度和内存占用方面表现最佳。总体而言,当前模型仍需改进,尚未实现简单的“即插即用”体验。
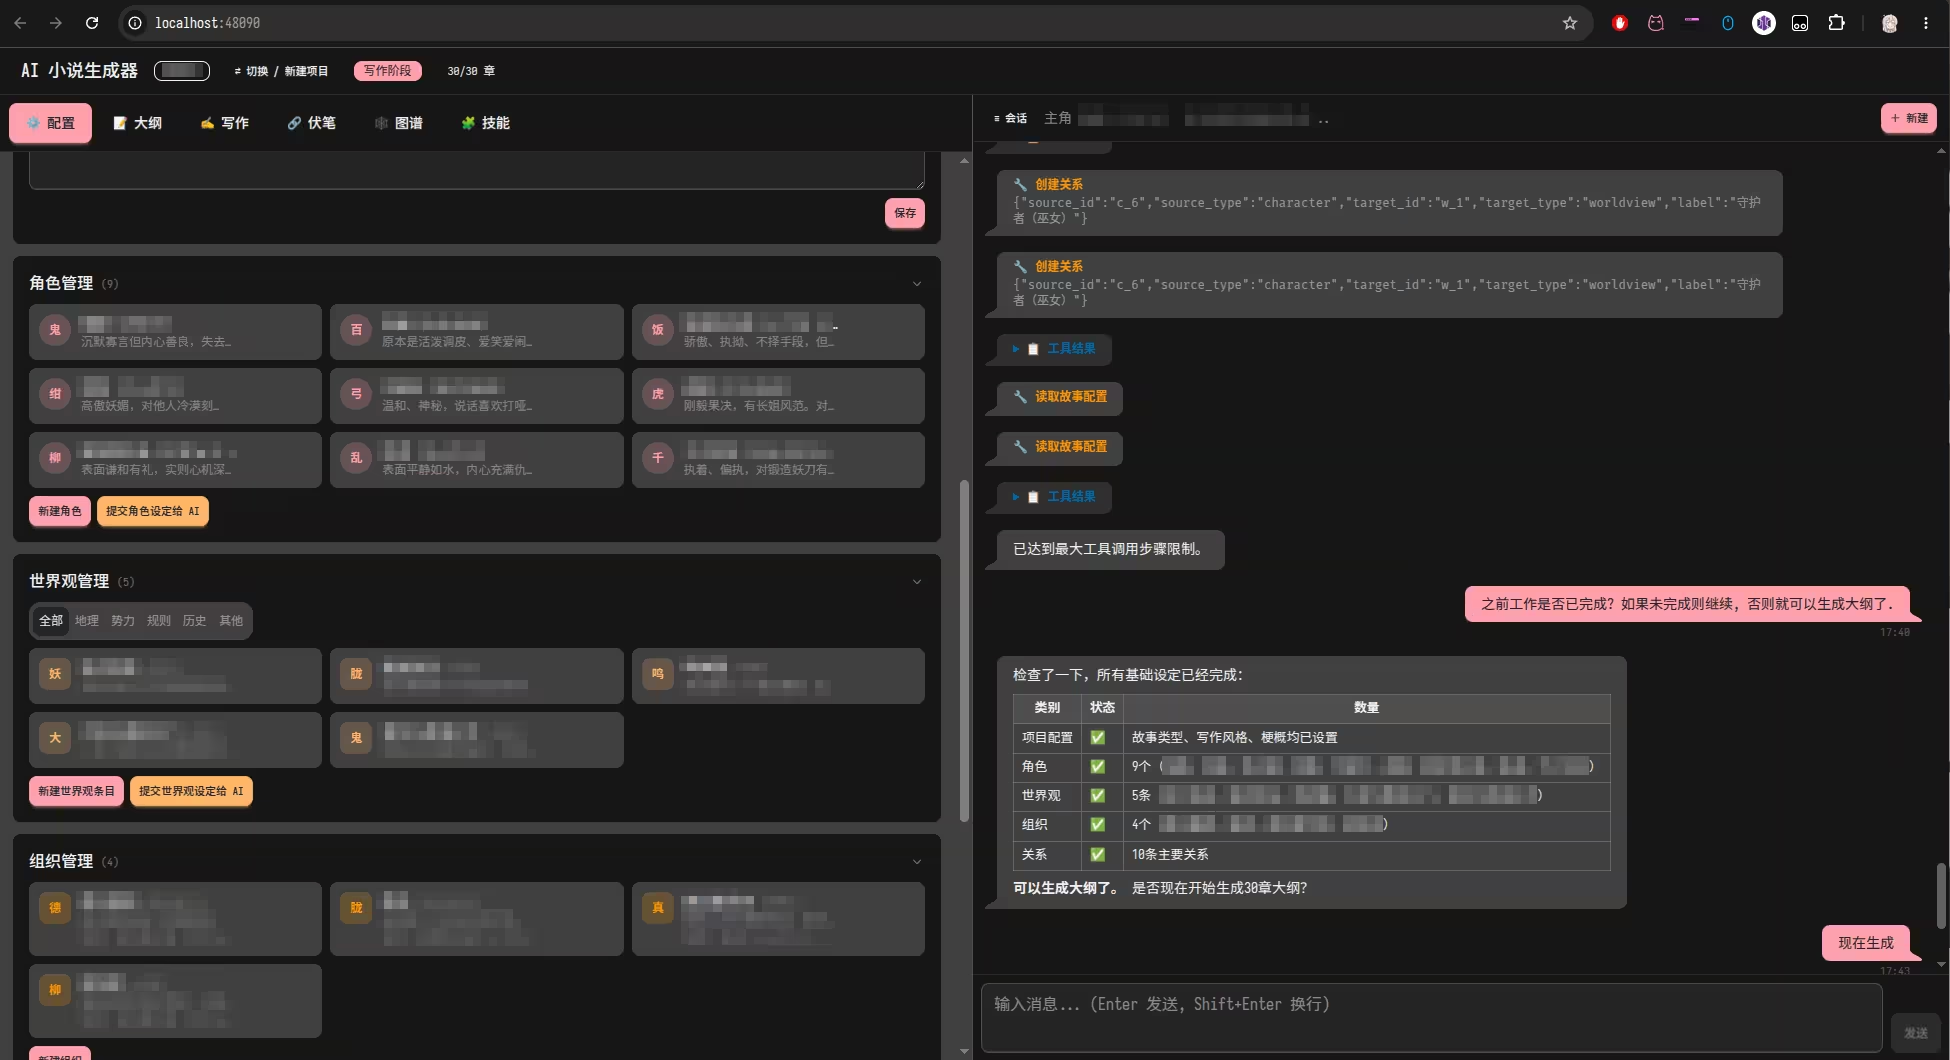
Show Me The Story是一款AI写小说工具,支持从设定到大纲再到逐章成文的全过程,适合网文和长篇小说作者。它提供角色和世界观管理及AI生成大纲等功能,用户可在本地运行以避免AI腔,并支持润色和章节优化。该工具在GitHub开源,建议用户先配置故事设定以提高大纲质量。
谷歌推出了Gemma 4 12B模型,旨在为标准笔记本电脑提供高性能的多模态智能。该模型内存占用比Gemma 4 26B小一半,但性能接近,支持本地运行,适合开发者使用。其统一架构可直接处理音频和图像输入,减少延迟和内存使用,吸引了开发者的关注。
谷歌最新的Gemma 4 12B是一款轻量级多模态AI模型,采用无编码器架构,能够直接处理图像和音频,提升了效率和理解能力。其120亿参数使其在普通电脑上运行成为可能,具备高效、快速的响应能力,并支持本地运行,确保隐私和安全。Gemma 4 12B适合个人用户和开发者,具有极高的可定制性。
完成下面两步后,将自动完成登录并继续当前操作。