为什么 ChatGPT 总爱在标题里塞色情赌博小广告?
内容提要
ChatGPT会话标题频现博彩色情小广告,根源可追溯至2024年。OpenAI新版分词器o200k_base的中文词表混入大量未清洗的广告语料,长词元中98%来自广告;而语言模型训练时又清洗掉这些词元,导致模型无法理解它们。标题生成模型收尾失败时,便从这些“乱码”词元中随机输出,形成异常标题。彻底解决需重制词表并重训基模,OpenAI暂无动机。
延伸解读
问题根源:词表污染与模型盲区
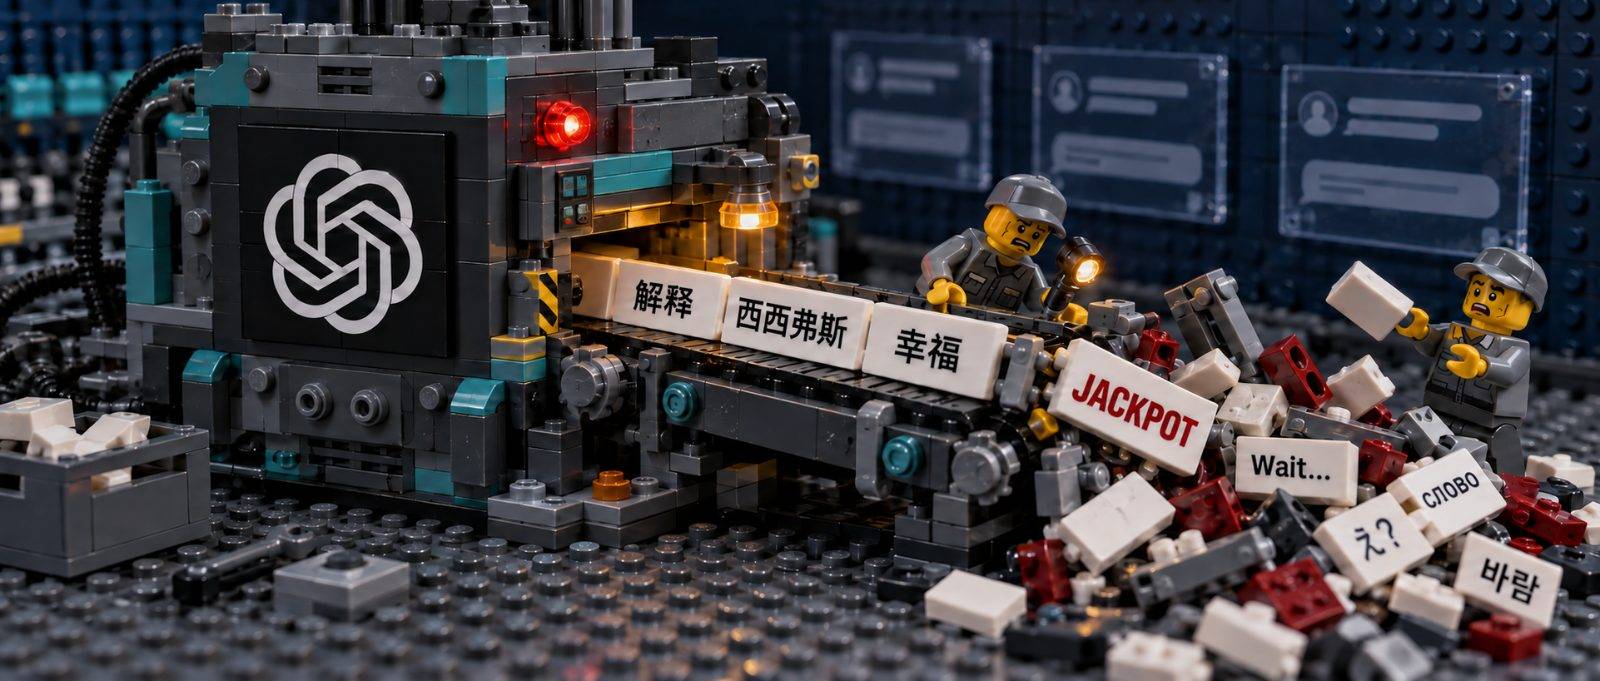
文章指出,ChatGPT异常标题的根源可追溯至2024年OpenAI新版分词器o200k_base。其中文词表混入大量未清洗的广告语料,长词元中98%来自广告。但语言模型训练时又清洗掉这些词元,导致模型无法理解它们。当标题生成模型收尾失败时,便从这些“乱码”词元中随机输出,形成异常标题。
为何小广告频频出现?
由于小广告词元在词表中数量占优,尤其是长词元几乎全为广告,当模型需要插入乱码时,从“垃圾房”中随机选取,大概率会选中广告词元。这解释了为何异常标题多为色情赌博小广告,而非其他乱码。
解决难点与现状
彻底解决需重制词表并重新训练基模,但词表与基模绑定,OpenAI暂无动机为中文用户体验推翻重做。目前可能采用事后检查规则,导致小广告减少但仍有漏网之鱼。短期内用户可能需继续与异常标题共存。
Q&A
ChatGPT 会话标题里为什么会出现色情赌博小广告?
根源在于 OpenAI 新版分词器 o200k_base 的中文词表混入了大量未清洗的广告语料,而语言模型训练时又清洗掉了这些词元,导致模型无法理解它们。当标题生成模型收尾失败时,就会从这些“乱码”词元中随机输出,形成异常标题。
ChatGPT 的标题生成机制是怎样的?
标题生成是独立于主对话的一次模型调用。用户发起第一轮对话后,网页端会向特定接口发送请求,服务端用指定模型根据会话内容生成标题,并作为对话元数据存储。标题生成模型可能是一个更轻量化的推理模型,但有时会在应该结束时停不下来,继续输出乱码。
为什么小广告词元在词表中这么多?
因为分词器训练时使用的中文语料包含大量从外网抓取的色情、赌博和盗版影视网站数据。小广告擅长在多个网站重复固定词组,极易被分词器识别为独立词元。论文发现,4 字词元中 68% 是小广告,6 字以上词元中 98% 来自广告,最长的 100 个中文词元有 96 个与赌博、色情或盗版影视相关。
为什么模型会输出这些它不理解的词元?
因为语言模型正式训练前会清洗掉低质量广告数据,所以模型从未见过代表这些词元的数组,无法理解其含义。当标题生成模型收尾失败、需要继续输出“下一个词”时,就会从这些“垃圾房”词元中随机选择,而小广告词元数量占统治地位,因此很容易被选中。
OpenAI 目前有解决这个问题吗?
OpenAI 在 7 月 25 日首次回应称已了解问题,预计未来模型更新中解决,但至今未彻底解决。目前可能采用了事后检查规则,将不合规标题打回重新生成,这解释了小广告减少但仍有漏网之鱼的现象。彻底解决需要重制词表并重训基模,但 OpenAI 暂无动机。
要彻底解决这个问题需要做什么?
治本的方法是重制一个干净的词表,因为词表和基模绑定,更新词表意味着整个模型都要重新训练。但 OpenAI 显然没有为了中文用户体验而将整个基模推翻重做的动机,所以未来一段时间可能还要与小广告共存。
