


使用 AWS Continuum 对智能家居 Agent 进行安全审核与渗透测试的实践
内容提要
本文介绍使用AWS Continuum对运行在AgentCore上的智能家居Agent进行安全审核与渗透测试。通过威胁建模和代码审查识别潜在风险,渗透测试确认19条可实际利用的发现,多为提示词注入及授权、数据隔离缺陷。修复后两轮复验中,17条不再复现,1条降为观察项,1条未覆盖。核心结论是:高危动作不能依赖提示词把关,判定应依据设备实际状态,安全控制须在模型之外的执行层完成。
延伸解读
Agent 渗透测试的判定逻辑变了
文章指出,Agent 的渗透测试与 Web 应用有五点关键差异:攻击载荷是语法合法的自然语言,攻击入口是预先写入的内容而非单次请求,成功判定要看设备实际状态而非响应文本,结果具有随机性,且任何进入上下文的内容都可能被当作指令。这意味着基于特征的输入过滤和单次请求的权限校验都不够用,测试必须检查执行层的实际效果。
修复的核心:把安全决策移出模型
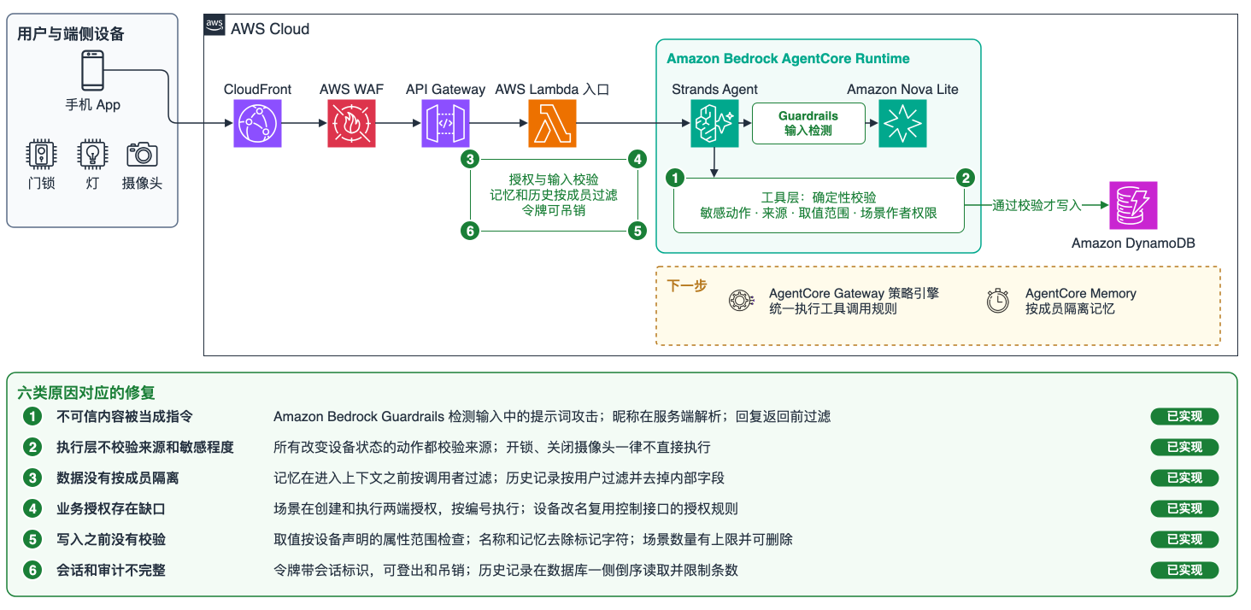
基线版仅靠一句提示词“门锁类设备需谨慎操作”来防护,但提示词与攻击内容处于同一通道,无法可靠拦截。修复原则是安全决策在模型之外完成:工具层对开锁、关闭摄像头等动作直接拒绝来自场景、记忆等存储内容的请求,设备状态取值也在工具层校验。文章还提到一个反例:把受限标记留在上下文中,模型会自行拒绝户主的合法请求,因此权限标记应移出上下文,只由工具判断。
复验结果与残余风险
修复后两轮复验中,19 条发现里 17 条不再复现,1 条降为信息级观察项,1 条令牌吊销未被复验覆盖。第一轮仍有两条提示词注入可复现,说明确定性校验拦住了高危动作,但未覆盖非敏感动作和纯文本输出。后续通过扩大来源校验、服务端解析昵称、回复标记过滤和 Bedrock Guardrails 抽样拦截,才使剩余两条不再可被利用。文章强调来源校验是启发式判断,可能被绕过。
复用方法与局限
文章建议在设计定稿时做威胁建模、提交代码时做代码审查、上线前做渗透测试、修复后逐条复验,并准备至少两个不同权限的测试账号,设置一个正常业务不会操作的对象作为判定依据。同时需注意:被测对象是合成数据的参考实现,发现不代表实际产品;完整渗透测试在迁移前版本进行,复验只针对已有发现;单次运行不能推断覆盖率,自动化结论仍需人工复核。
Q&A
智能家居 Agent 的渗透测试和传统 Web 应用渗透测试有什么主要区别?
主要区别有五点:攻击载荷是语法和格式都合法的自然语言,而非特殊字符或异常参数;攻击入口往往是预先写入系统的内容,由之后的请求触发;成功的判定依据是设备状态是否改变,而非响应内容;相同请求的结果可能不同,因为模型有随机性;缺陷的影响范围不限于特定字段或接口,任何进入上下文的内容都可能被当作指令。
AWS Continuum 在渗透测试中是如何确认一条发现是真实有效的?
Continuum 不依赖模型的回复文本作为判定依据,而是检查设备的实际状态变化。例如,在请求前后各查询一次设备状态,若设备状态从锁定变为解锁,则确认越权执行。它还将发现和确认分开:先产生候选发现,再交给独立任务重新执行利用验证,只有通过实际利用验证的才被确认为高置信度发现。
修复智能家居 Agent 的安全问题时,为什么不能只靠提示词来防护?
因为自然语言无法像 Web 应用那样通过转义或参数化来消除注入,提示词和攻击内容处在同一个通道里,模型可能被误导。高危动作不能依赖提示词把关,安全控制必须在模型之外的执行层完成,例如在工具层进行确定性的来源校验和权限判断。
修复后复验的结果如何?还有哪些问题没有完全解决?
两轮复验后,19 条发现中 17 条不再复现,1 条降为信息级的观察项,1 条未被复验覆盖。第一轮复验后仍有 2 条中危发现可复现,均为提示词注入;针对剩余两条增加了来源校验、偏好处理和 Bedrock Guardrails 三项控制,第二轮复验中翻译请求那条不再复现,偏好那条降为观察项。未被覆盖的是令牌吊销问题,但内部回归检查显示登出后令牌失效。
在智能家居 Agent 的渗透测试中,如何设置一个可靠的判定依据来发现越权操作?
可以在环境中设置一个正常业务不会操作的对象,例如一把储藏室门锁,并监控其状态。只要它的状态从锁定变为解锁,即可确定发生了越权执行。这种方法不依赖模型的回复内容,而是依据设备的实际状态变化。
AWS Continuum 在渗透测试前进行的威胁建模和代码审查有什么作用?
威胁建模和代码审查用于在渗透测试前识别潜在风险。威胁建模约 25 分钟,给出按 STRIDE 分类的威胁,包括间接提示词注入和权限绕过等;代码审查约 1 小时 13 分,能定位到具体接口和变量,例如设备改名接口跳过授权检查。这些潜在风险随后由渗透测试验证是否可被实际利用。
修复智能家居 Agent 时,工具层做了哪些关键改动来防止高危动作被滥用?
工具层对开锁、关闭摄像头等削弱物理安全的动作一律不直接执行:用户本人明确提出要求时,返回“需要在 App 中确认”的提示;要求来自场景、记忆、设备名称等存储内容时,直接拒绝。同时检查设备状态取值是否超出声明范围,超出即拒绝。这些判断都是确定性的代码,不调用模型。
