


多模态检索增强生成的评估
原文英文,约1200词,阅读约需5分钟。
📝
内容提要
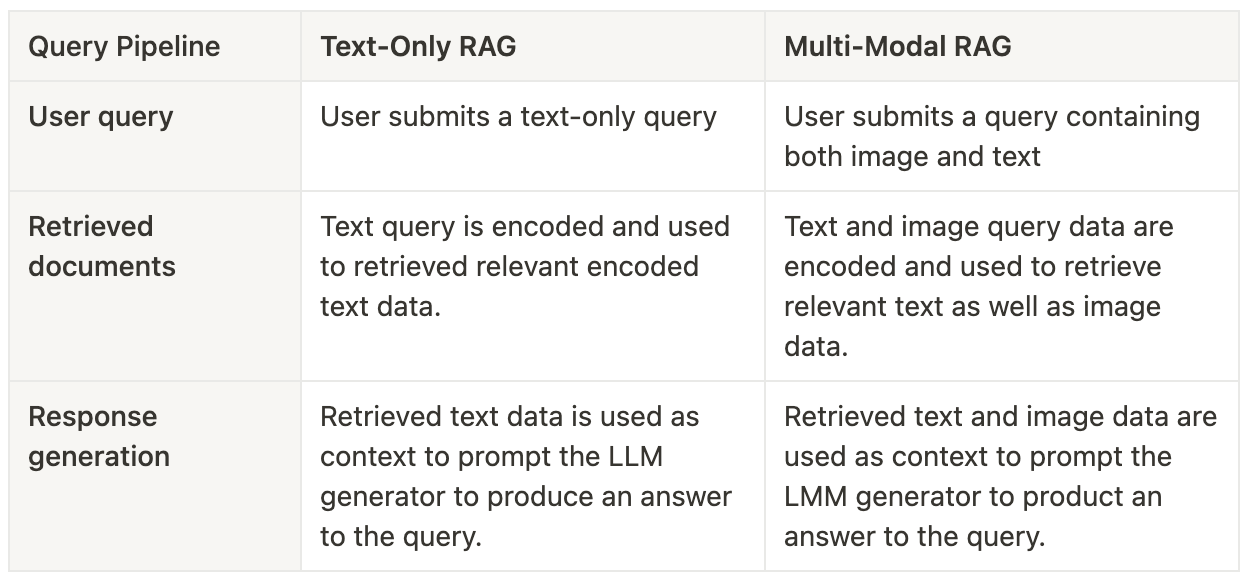
本文讨论了多模态检索增强生成(RAG)系统的评估方法,强调与传统文本RAG相比,多模态RAG需同时考虑文本和图像的检索与生成评估。评估指标包括检索的相关性和忠实度,使用多模态大模型(LMM)作为评估工具,并指出分开评估文本和图像的重要性,以提高评估的准确性和可见性。
🔎
延伸解读
多模态RAG评估:分开评估文本与图像检索
文章指出,多模态RAG的检索评估应分别计算文本和图像的相关性指标,如命中率和平均倒数排名。这样做可以更清晰地了解检索器在不同模态上的表现,便于针对性优化。例如,文本检索的命中率可能高于图像检索,分开评估能揭示这种差异,避免单一聚合分数掩盖问题。
使用LMM作为评估工具的注意事项
文章强调,使用多模态大模型(LMM)作为评估工具时,需注意其可能存在的幻觉和不一致性问题。虽然强LLM与人类判断有较高对齐率,但LMM尚无类似研究。在生产系统中应谨慎使用,并考虑结合人工评估或其他验证手段。
多模态RAG生成评估:相关性与忠实度
生成评估需考虑响应与检索文本和图像的匹配程度。相关性衡量响应与查询的匹配,忠实度衡量响应与检索上下文的匹配。由于涉及图像,评估需使用能处理多模态输入的LMM,如GPT-4V或LLaVA,以计算这些指标。
❓
Q&A
多模态RAG系统的评估方法有哪些关键点?
多模态RAG系统的评估方法需要同时考虑文本和图像的检索与生成评估,评估指标包括检索的相关性和忠实度。
如何评估多模态RAG中的检索效果?
在多模态RAG中,检索评估应分别计算文本和图像的相关性,以提高评估的准确性。
使用什么工具进行多模态RAG的评估?
评估工具使用多模态大模型(LMM),如OpenAI的GPT-4V,来评估生成的响应与检索文本和图像的匹配程度。
多模态RAG生成器的评估指标是什么?
生成器评估需要考虑生成的响应与检索文本和图像的匹配程度,主要指标包括相关性和忠实度。
多模态RAG评估中可能存在什么问题?
使用LMM作为评估工具时,可能存在幻觉和不一致性问题,需要谨慎处理。
如何提高多模态RAG评估的准确性?
通过分别计算文本和图像的检索相关性,并使用LMM进行评估,可以提高多模态RAG评估的准确性。
🏷️
