


Instacart 如何利用大语言模型让人们买得更多
内容提要
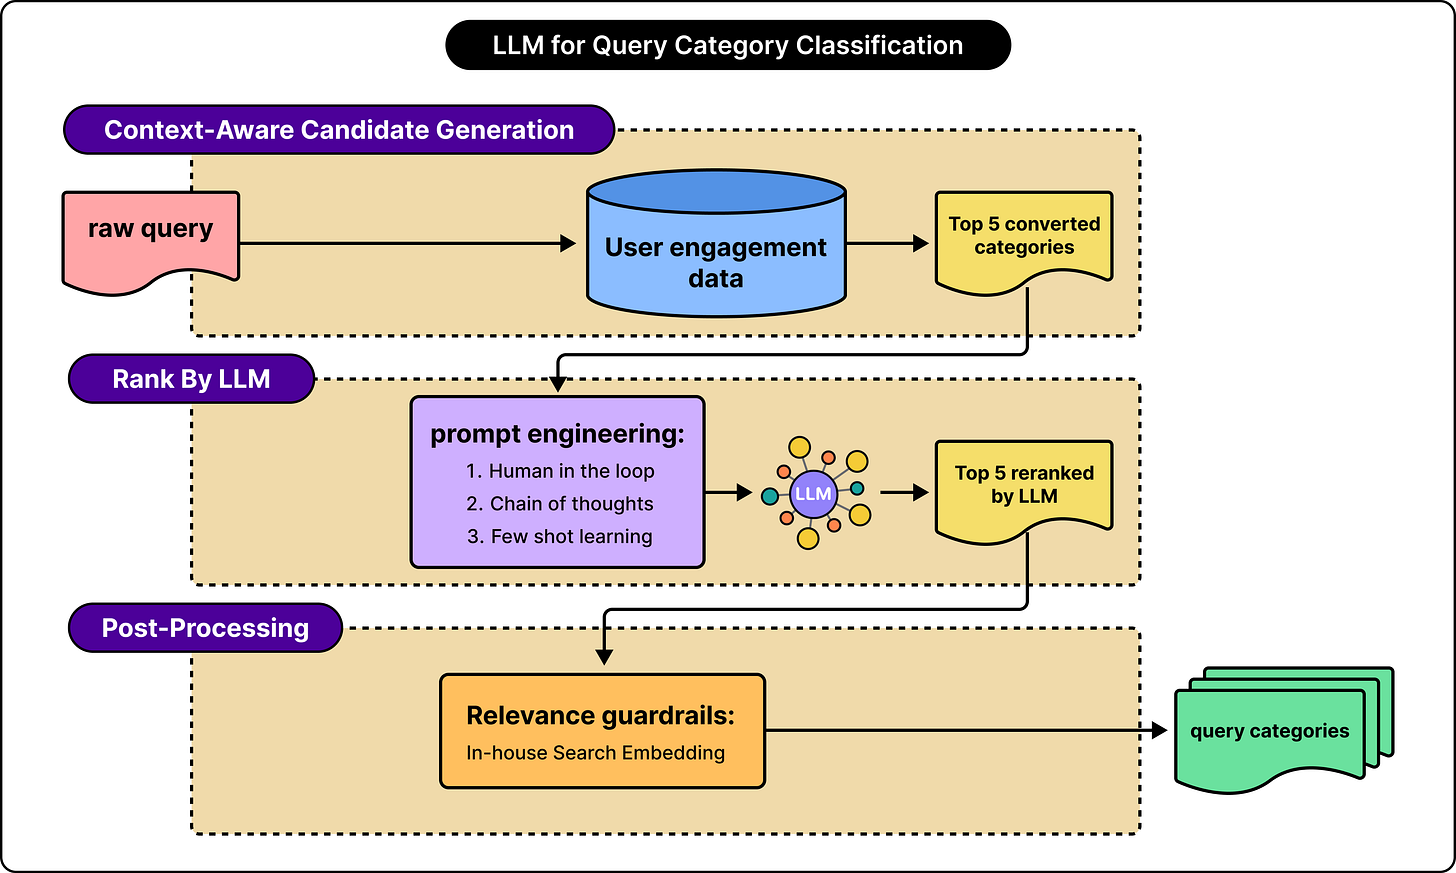
Instacart 利用大语言模型改进电商搜索的查询理解。旧系统依赖点击购买数据训练,存在标签噪声大、长尾查询覆盖不足、多模型维护成本高的问题。新方案结合历史购买候选、LLM 重排类目路径与嵌入相似度校验来提升类目识别;查询改写分为同义、放宽、替代三类,覆盖率从 50% 提升至 95% 以上;结构化标签采用离线大模型生成高质量样本,蒸馏微调 Llama-3 8B 用于实时推理,并缓存高频查询。经 LoRA 合并、H100 升级和缓存优化,延迟降至约 300 毫秒。A/B 测试显示长尾查询滚动深度下降 6%,投诉减半。
延伸解读
从行为数据到LLM:训练信号的取舍
Instacart旧系统依赖点击和购买行为训练,但用户搜“面包”却买香蕉这类行为噪声大,且长尾查询缺乏历史样本。新方案用LLM的通用语言知识弥补数据稀疏,同时保留历史购买作为候选生成来源。这提示:行为数据适合召回候选,但不宜直接作为分类标签;LLM负责解释,规则或嵌入校验负责过滤,三者分工比单一模型更稳健。
查询改写分三类,覆盖与精度并重
旧改写系统仅覆盖约50%搜索流量,直接让LLM改写又容易产生“1%牛奶→one percent milk”这类无助于找替代品的同义转换。Instacart将改写拆为同义、放宽、替代三类,分别对应保持原意、降低约束、推荐替代品,并配专用提示与后处理过滤。结果覆盖率超95%,三类精度均超90%。这说明改写任务需要明确意图分类,而非笼统生成。
大模型当老师、小模型做实时推理
结构化标签提取需兼顾质量与延迟。Instacart用离线大模型管道生成高质量标签并校验,同时作为训练数据蒸馏到Llama-3 8B小模型,实时处理未命中缓存的查询。缓存覆盖高频查询后,仅约2%查询需实时推理。这种“离线教师+在线学生+缓存”的架构,把昂贵计算移出请求路径,是平衡效果与成本的可复用思路。
延迟优化的取舍:合并LoRA、升级GPU、放弃量化
初始SRL服务在A100上延迟近700毫秒,团队通过合并LoRA适配器降约30%,再升级H100达到约300毫秒目标。FP8量化虽再降10%延迟,但召回略降,最终选择不量化以保质量。这说明延迟优化需识别瓶颈来源:适配器合并减少计算,硬件升级提升吞吐,而量化带来的精度损失需按业务优先级权衡,不能只看速度。
Q&A
Instacart 原来的查询理解系统存在哪些问题?
旧系统依赖点击购买数据训练,标签噪声大;长尾查询覆盖不足;多模型维护成本高,且对同一查询可能产生不一致解释。
Instacart 如何利用大语言模型提升类目识别准确率?
结合历史购买候选、LLM 重排类目路径,并用嵌入相似度校验,过滤掉与查询语义不符的类目路径。
Instacart 的查询改写分为哪几类?效果如何?
分为同义改写、放宽改写和替代改写三类。覆盖率从 50% 提升至 95% 以上,三类改写的精确率均超过 90%。
Instacart 如何为实时搜索提取结构化标签?
采用离线教师管道生成高质量标签样本,蒸馏微调 Llama-3 8B 用于实时推理,并缓存高频查询结果。
Instacart 如何将模型延迟降低到约 300 毫秒?
通过合并 LoRA 适配器到基础模型(延迟降低约 30%)、升级到 H100 GPU,以及缓存高频查询(仅 2% 查询需实时推理)。
Instacart 新搜索系统上线后的 A/B 测试效果如何?
长尾查询的平均滚动深度下降 6%,用户投诉减少 50%,延迟仅有轻微增加。
