


关于过滤向量搜索的所有信息:它的重要性及其背后的原理
内容提要
过滤向量搜索在大规模数据检索中至关重要,显著提高检索精度。MyScale通过预过滤和列存储等技术,实现高效的过滤搜索,支持多用户系统。在金融分析等应用中,精度可从60%提升至90%。结合结构化数据与向量数据,MyScale为大规模LLM应用奠定了基础。
延伸解读
预过滤与后过滤:精度差异的关键
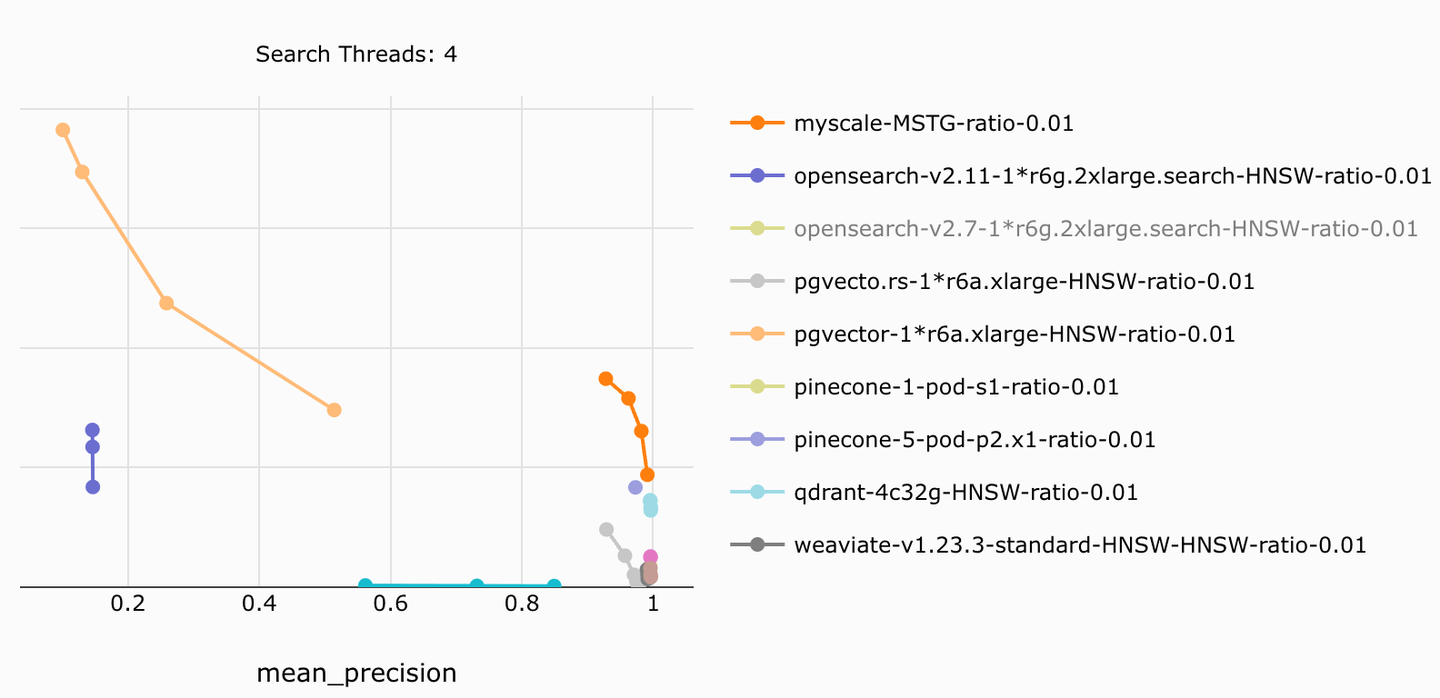
文章指出,过滤向量搜索有两种实现方式:预过滤和后过滤。预过滤先根据元数据筛选出符合条件的向量,再在这些向量中进行相似性搜索,能保证返回k个结果。后过滤则先进行向量搜索得到m个结果,再应用元数据过滤,但最终结果可能少于k个,当符合条件的向量稀少时,精度会显著下降。pgvector采用后过滤,在低过滤比例下精度损失严重。
列式存储:高效过滤的基石
为了实现高效的预过滤,快速扫描元数据至关重要。列式存储(如ClickHouse)在分析处理、扫描多列数据、批量导入和压缩存储方面效率更高,适合大规模数据扫描。许多专用向量数据库如Milvus和Qdrant也采用了列式存储。MyScale基于ClickHouse,利用跳数索引和SIMD等技术进一步提升扫描效率,而pgvector等基于行式存储的系统则面临精度或速度问题。
多用户系统与过滤搜索的灵活性
大规模多用户系统(如文档问答、虚拟角色聊天)需要支持数百万用户的查询,且每次查询通常只涉及单个或少量用户的数据,要求在低过滤比例下保持高精度。Pinecone、Weaviate等通过命名空间机制隔离用户数据,但灵活性受限,单次查询只能搜索一个命名空间。而使用WHERE条件进行过滤查询更灵活,例如社交网络中查询好友相关内容。MyScale通过数据分区和主键排序(如ORDER BY (user_id, message_id)和PARTITION BY sipHash64(user_id) % 100)进一步提升效率。
MyScale的优化策略与性能表现
MyScale结合列式存储、预过滤和算法创新,在任何过滤比例下都能保持高精度和效率。文章提到,与同类产品相比,MyScale的每QPS成本低4-10倍,在开源基准测试中搜索速度和精度最高,且成本更低。此外,MyScale支持丰富的SQL数据类型和函数,LLM可自动将自然语言转换为SQL WHERE条件,使非技术用户也能执行过滤查询,提升RAG系统的灵活性和精度。
Q&A
过滤向量搜索的主要优势是什么?
过滤向量搜索显著提高了检索精度,尤其是在处理大规模数据时,可以将精度从60%提升至90%。
MyScale是如何实现高效的过滤搜索的?
MyScale通过结合预过滤、列存储和高效的搜索算法,实现了高效的过滤搜索,支持多用户系统。
预过滤和后过滤有什么区别?
预过滤先选择符合条件的向量再进行搜索,确保结果的准确性;而后过滤则是在获得初步结果后再应用过滤条件,可能导致最终结果不确定。
列存储在数据分析中有什么优势?
列存储在分析处理上效率更高,适合大规模数据的扫描和分析,能够显著提高数据检索性能。
过滤向量搜索在金融分析中的应用效果如何?
在金融分析中,过滤向量搜索可以将检索精度从60%提升至90%,有效提高信息检索的准确性。
MyScale与其他向量数据库相比有什么优势?
MyScale在搜索速度和精度上表现优异,且成本比其他产品低4到10倍,适合生产级RAG系统。
