


Triton 的交叉熵损失
内容提要
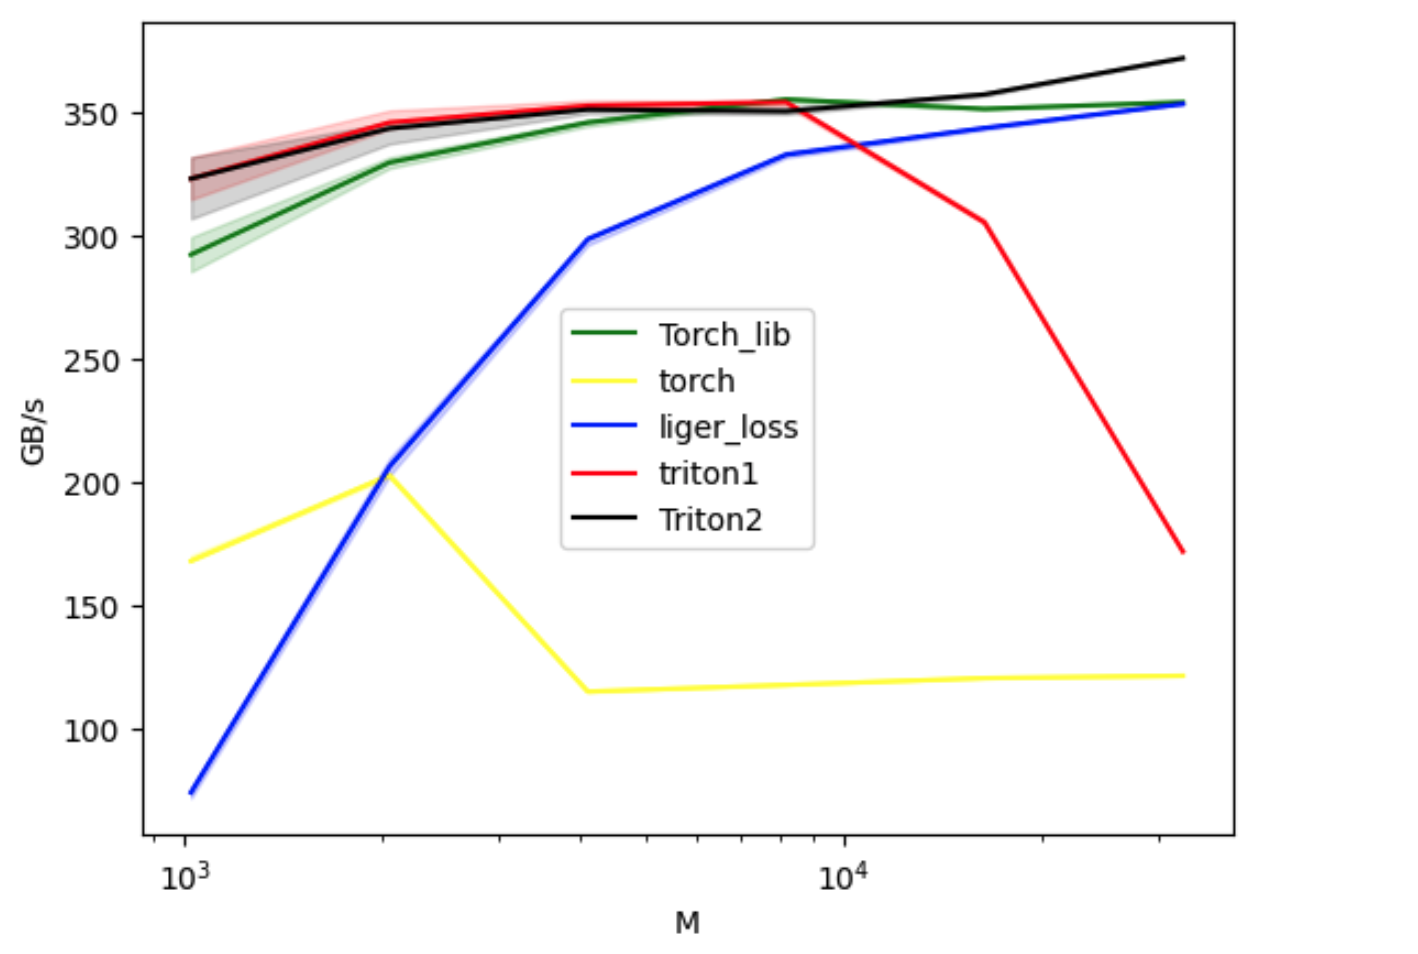
作者用 Triton 实现交叉熵损失,数值与 PyTorch 仅差 1e-7,但速度慢约 1000 倍。参考 Liger-Kernel、Attorch 后仍不及 PyTorch。经 gpumode 社区帮助,发现环境变量是自制 kernel 慢的根因,并给出含前向、反向的 Triton kernel 代码。
延伸解读
性能差距的根源:环境变量
作者发现自制 Triton kernel 比 PyTorch 慢约 1000 倍,即使参考 Liger-Kernel 和 Attorch 后仍无改善。最终在 gpumode 社区帮助下,确认环境变量是根本原因。这提示读者,在优化 Triton 内核时,除了算法和实现,运行环境配置也可能成为性能瓶颈,值得优先排查。
数值精度与速度的权衡
作者的 Triton 实现与 PyTorch 的数值差异仅 1e-7,精度足够,但速度却慢 1000 倍。Liger-Kernel 虽节省内存(0.51 vs 1.25),速度仍远不及 PyTorch(3053.16ms vs 0.04ms)。这说明在自定义 kernel 时,数值正确性容易达到,但性能优化需要更深入的调优,不能仅满足于结果正确。
社区协作的价值
作者在 gpumode discord 群组获得关键帮助,才定位到环境变量问题。这体现了在 Triton 等底层优化中,社区经验分享能快速解决个人难以发现的陷阱。读者在遇到类似性能异常时,可积极寻求社区支持,避免重复踩坑。
Q&A
用 Triton 实现交叉熵损失,数值精度和 PyTorch 相比怎么样?
作者实现的 Triton 交叉熵损失与 PyTorch 的数值差异仅为 1e-7。
为什么自己写的 Triton 交叉熵损失比 PyTorch 慢很多?
根本原因是环境变量设置问题,而非核心 kernel 代码本身。在 gpumode 社区朋友的帮助下发现并解决了该问题。
Liger-Kernel 和 Attorch 在交叉熵损失上的性能表现如何?
Liger-Kernel 速度仍低于 PyTorch(3053.16ms vs 0.04ms),但节省大量内存(0.51 vs 1.25)。Attorch 与作者之前的 Triton kernel 及 Liger-Kernel 相比没有太大差异。
Triton 交叉熵损失 kernel 的前向计算是如何实现的?
前向计算通过分块循环处理输入,使用在线 softmax 技巧维护最大值和指数和,并累加目标类别的 logit,最后计算 log(sumexp) + max_val - allcurx 作为损失值。
Triton 交叉熵损失的反向传播是如何计算的?
反向传播通过另一个循环计算梯度:对每个元素,梯度为 exp(input_val - max_val) / sumexp 减去目标位置的 1(如果该位置是目标类别),然后存储回输入指针。
作者在实现 Triton 交叉熵损失时遇到了什么困难,如何解决的?
作者发现 Triton kernel 比 PyTorch 慢约 1000 倍,尝试 Liger-Kernel 和 Attorch 后仍不理想。最终在 gpumode discord 社区的帮助下,发现环境变量是根本原因,并成功实现了包含前向和反向的 Triton kernel。
