

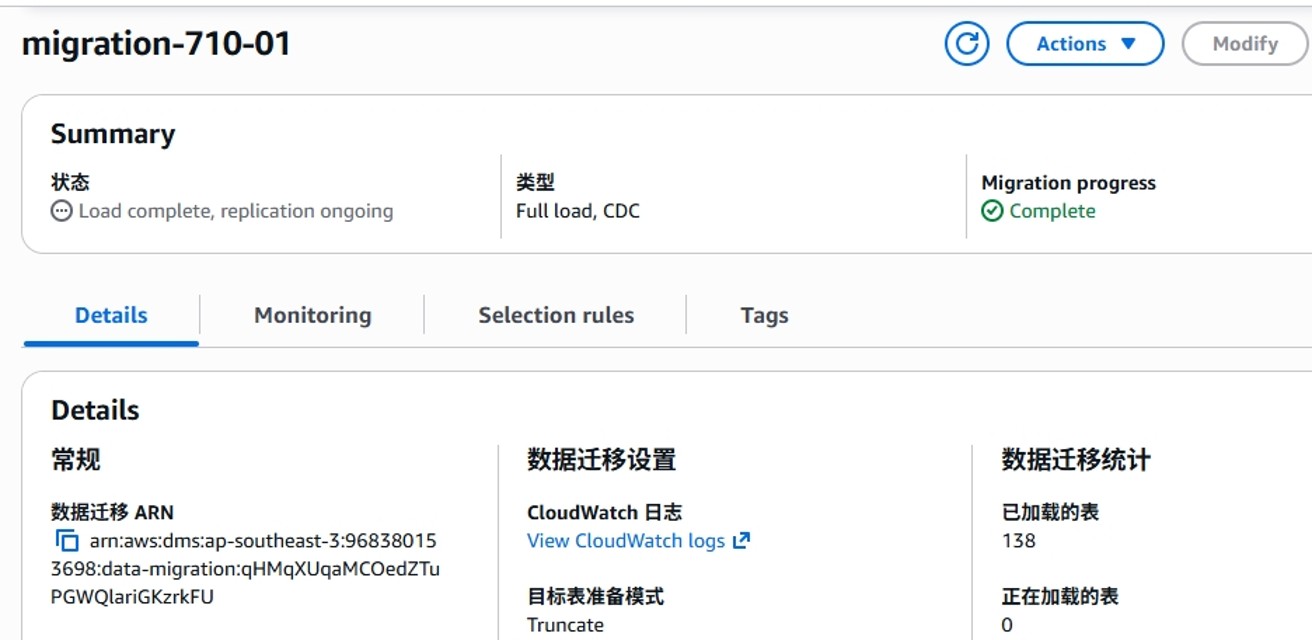

同构跨云 / IDC 的 PostgreSQL 迁移工程化实践——当源库含触发器、无主键 LOB 表等情况时,用一套可复用脚本 + AWS DMS 完成完整、一致的迁移
内容提要
本文介绍同构PostgreSQL跨云迁移实践:当源库含触发器、无主键LOB表等不满足AWS DMS直接迁移条件时,采用DMS同构迁移(全量+CDC)配合脚本套件。脚本自动生成预建结构、禁用触发器、迁移后补齐索引/外键/序列及一致性校验SQL,并输出执行清单RUN_ORDER。源库需设REPLICA IDENTITY FULL。方案实现最小停机,经实际项目验证,可复用。
延伸解读
触发器与无主键 LOB 表:DMS 直接迁移的常见盲区
文章指出,当源库含触发器或存在无主键的 text/jsonb 大字段表时,直接使用 DMS“转换或迁移至托管”无法保证一致性。触发器会在灌数据时被触发,污染审计或时间戳字段;无主键 LOB 表在 CDC 阶段难以捕获完整行变更。因此,迁移前应先用脚本识别这类表,并评估是否必须引入预建结构、禁用触发器、设置 REPLICA IDENTITY FULL 等额外步骤,而非默认 DMS 开箱即用。
REPLICA IDENTITY FULL 是 CDC 正确性的前提,但需权衡
文章强调源库必须对所有表设置 REPLICA IDENTITY FULL,否则增量阶段无法捕获 UPDATE/DELETE 的完整行,尤其对无主键表。脚本 00 会自动生成全表设置语句。但该设置会增加 WAL 体积,属于正常现象。读者需注意:修改 wal_level 或 rds.logical_replication 通常需重启数据库,生产环境应安排在维护窗口执行,并提前评估 WAL 增长对存储和复制延迟的影响。
脚本套件的价值在于固化执行顺序与次级对象补齐
文章的核心工具 generate_migration_scripts.sh 从源库系统目录动态生成 SQL,不写死表名,可随 Schema 变更重复运行。它把容易遗漏的次级对象(索引、外键、约束、序列、触发器、默认值)和执行顺序沉淀为 RUN_ORDER.md。读者可借鉴其思路:用 pg_dump 的 --section 拆分 pre-data 与 post-data,分别对应 DMS 加载前后;用 setval 自动重置序列,避免新写入主键冲突。这套方法可复用于类似同构迁移,减少手工梳理遗漏。
最小停机依赖“停写→追平→校验→切换”的窗口控制
方案将停机窗口压缩到分钟级:全量与 CDC 期间源库保持在线,仅在最后停止源库写入、等待 CDC 延迟归零、执行 03/04 补齐对象与序列、运行 05_verify.sql 比对一致后切换应用。文章建议切换前保留源库只读一段时间,并预设回滚触发条件,以便快速回切。读者应重点演练增量追平耗时和校验脚本覆盖范围,05_verify.sql 只比较通用对象,业务数据关系校验需按需补充。
Q&A
源库有触发器,直接用AWS DMS同构迁移会有什么问题?
如果不禁用触发器,DMS灌数据时会触发审计、校验、时间戳等业务触发器,污染数据并导致记录不一致。因此需要先在目标库预建结构并禁用触发器(设置session_replication_role=replica),再启动DMS同构迁移灌数据,迁移后再恢复触发器。
为什么源库必须设置REPLICA IDENTITY FULL?
REPLICA IDENTITY FULL是CDC阶段能正确捕获UPDATE/DELETE完整行(含TOAST/大字段列)的关键,尤其对于无主键表。设置后增量阶段可捕获完整行,含LOB列的表无需额外的临时主键处理。脚本会自动为源库全表生成设置语句。
迁移脚本套件包含哪些文件,各自在什么时机执行?
脚本生成的文件包括:00_set_source_db_identity_full.sql(迁移前在源库设置REPLICA IDENTITY FULL)、01_pre_data.sql(Full Load前在目标库预建表结构等)、02_pre_dms_disable_triggers.sql(Full Load前禁用触发器)、03_post_data.sql(Full Load后创建索引、外键等)、04_post_dms_restore.sql(Full Load后重置序列、启用触发器)、05_verify.sql(迁移后一致性校验)、dms_task_config_reference.json(DMS任务配置参考)和RUN_ORDER.md(执行顺序清单)。
如何保证迁移后序列不会导致主键冲突?
Full Load后目标库序列的last_value不会自动对齐,新写入会主键冲突。脚本通过反查“序列→列”归属,自动生成setval语句(在04_post_dms_restore.sql中),将序列值重置为对应列的最大值,从而避免冲突。
迁移过程中如何实现最小停机?
方案采用DMS同构迁移的全量加载+增量同步(CDC),源库在全量与追增量期间保持在线可写。停机窗口仅为最后“停写→等增量追平→校验→切换”这一小段,通常为分钟级。
迁移后如何校验源库和目标库的一致性?
使用脚本生成的05_verify.sql在源库和目标库分别执行,逐项比对表数、行数、索引、序列、触发器、约束、LOB非空行数等。全部一致后,再切换应用连接串并做回归测试。
生产环境迁移前需要做哪些关键准备?
关键准备包括:对源库做完整可恢复的备份(如快照或pg_dump并验证恢复);在测试环境按相同流程完整演练RUN_ORDER的Step 0–7和DMS任务,记录耗时以估算停机窗口;演练一致性校验和应用连通性;切换前确认备份、通知、回滚条件等检查点。
