
自变量 X2-NativeCursor 开源:不用 ASR,TTS也能知道自己说到哪了
内容提要
自变量机器人提出X2-NativeCursor,用约2M参数进度模型直接从TTS原生语音token估计原文位置,无需ASR或波形对齐。结合播放时钟确定播报进度,支持打断后续读、字幕高亮等。中文位置误差低于在线基线,RTF从0.36降至0.018,并可适配CosyVoice2等不同TTS。
延伸解读
为什么需要原生语音token的进度跟踪
流式TTS中,模型生成的文本位置与用户实际听到的语音位置存在滞后。传统方法依赖ASR或波形对齐,但ASR需额外识别,波形对齐需等待完整音频或增加声学计算。X2-NativeCursor直接利用TTS原生语音token,在波形解码前估计原文位置,避免了这些开销,为实时交互提供了更高效的进度映射方案。
局部匹配与游标设计如何平衡精度与稳定性
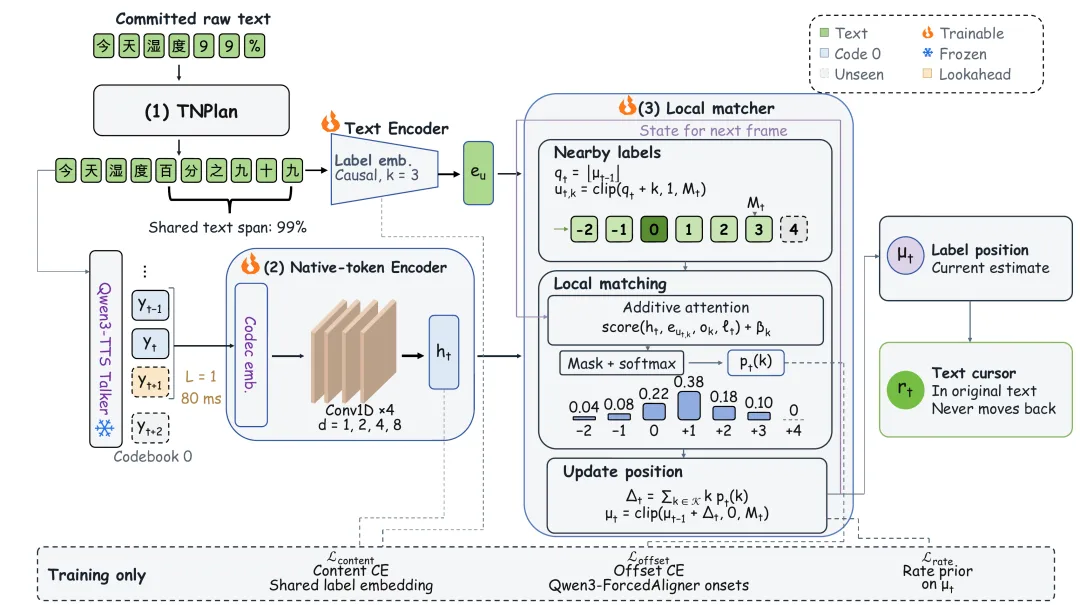
进度模型采用局部窗口匹配,只比较上一位置附近的七个偏移,通过softmax加权更新内部位置。内部允许回退修正,但对外游标只保留历史最远整数位置,确保显示进度不后退。这种设计在消融实验中显示,禁止内部回退和跳步会显著增加英文误差,说明保留修正空间对维持跟踪精度至关重要。
性能优势与泛化能力
在中文测试中,X2-NativeCursor的位置误差低于在线波形基线,且RTF从0.36降至0.018,计算开销大幅降低。16路并发下,每帧游标更新中位耗时2.45ms,远低于80ms的帧时长。同一结构适配CosyVoice2时中文MAE为0.284,表明其可迁移到不同TTS骨干,但需针对具体模型重新训练进度模型。
实际应用中的分工与限制
实现打断后续读等功能,需要进度模型、播放器和上层应用协同:进度模型估计位置,播放器提供实际播放时钟作为锚点,应用负责停止播放和更新对话历史。论文也指出,当前评估基于自动参考,且需为不同TTS训练匹配的进度模型,跨语言、音色和终端场景的泛化仍需进一步验证。
Q&A
X2-NativeCursor 是什么?它主要解决什么问题?
X2-NativeCursor 是自变量机器人提出的一个约 2M 参数的进度模型,它直接从 TTS 的原生语音 token 中估计原文位置,再由客户端结合播放时钟确定播报进度。它解决的核心问题是:在流式 TTS 中,系统知道模型生成了多少文本,却不知道声音实际播到了哪里,导致打断时无法准确回答“刚才说到哪了”。
X2-NativeCursor 为什么不需要 ASR 或波形对齐?
因为语音 token 本身已经携带内容和时间线索,进度模型可以直接读取这些原生 token,在波形解码之前完成位置估计。传统方法需要先把语音 token 解码成波形,再用声学模型对齐,而 X2-NativeCursor 把这一步提前,避免了在线波形对齐的等待和额外声学计算。
X2-NativeCursor 的进度模型由哪几部分组成?
由三部分组成:TNPlan、进度模型和游标输出。TNPlan 负责处理书写与读音的差异,将文本转换成读音标签并记录每个标签对应的原文区间;进度模型从原生语音 token 估计原文进度;游标输出则对外提供位置信息。主模型共 2.166M 参数。
X2-NativeCursor 在中文位置误差和计算效率上的表现如何?
在中文测试中,X2-NativeCursor 用在线波形基线四分之一的前瞻,获得了更低的中文位置误差。计算开销方面,实时率 RTF 从在线波形基线的 0.3598 降到 0.0180。在单张 A800 上,16 路会话下,一次完整游标更新的中位耗时为 2.45 ms,第 90 百分位为 4.92 ms,低于一帧代表的 80 ms 语音时长。
X2-NativeCursor 能否适配其他 TTS 模型?
可以。论文将同一套进度模型结构用于 CosyVoice2,固定 TTS 并使用它自己的语音 token 重新训练进度模型,中文 MAE 为 0.284,95% 置信区间为 0.237–0.343。这表明同一结构可以在不同骨干上适配,但仍需针对不同 TTS 训练匹配的进度模型。
X2-NativeCursor 如何帮助全双工语音助手处理打断?
当用户打断时,应用先记录播放器实际播到的音频位置作为锚点,再查找对应帧的原文游标。这样就能知道用户实际听到了哪里,而不是模型生成到了哪里。例如从 1 数到 100,模型已生成到 100,但用户只听到 27,助手可以回答“刚才数到了 27”,并在收到“继续”后从 28 开始。
X2-NativeCursor 有哪些潜在应用场景?
主要应用包括:全双工语音助手,用户插话时按实际播放位置更新对话历史;实时字幕与随读高亮,让文字展示跟随声音推进,用于语音阅读、语言学习和实时讲解;数字人与机器人交互,把手势、画面切换或界面提示关联到具体文本片段,在对应内容播出时触发。
