


广义语言模型
内容提要
2018年以来,NLP领域出现CoVe、ELMo、GPT、BERT等预训练语言模型,通过无监督预训练学习上下文相关词表示,再微调适配下游任务,解决了传统词嵌入无法区分语境的问题。BERT采用双向Transformer和掩码语言模型,GPT为单向生成。后续ULMFiT、GPT-2、RoBERTa、ALBERT、T5、GPT-3、XLNet等持续改进,大幅提升NLP性能。
延伸解读
从词向量到上下文表示:NLP预训练范式的转变
文章指出,传统词嵌入(如GloVe)基于词语共现学习,无法区分同一词在不同语境下的含义,例如“apple”在“吃苹果”和“苹果手机”中向量相同。CoVe、ELMo等模型通过编码整个句子生成上下文相关表示,解决了这一问题。这一转变使NLP模型能更准确地捕捉语义和句法信息,为后续BERT、GPT等通用架构奠定基础。
ELMo与GPT/BERT:架构与使用方式的差异
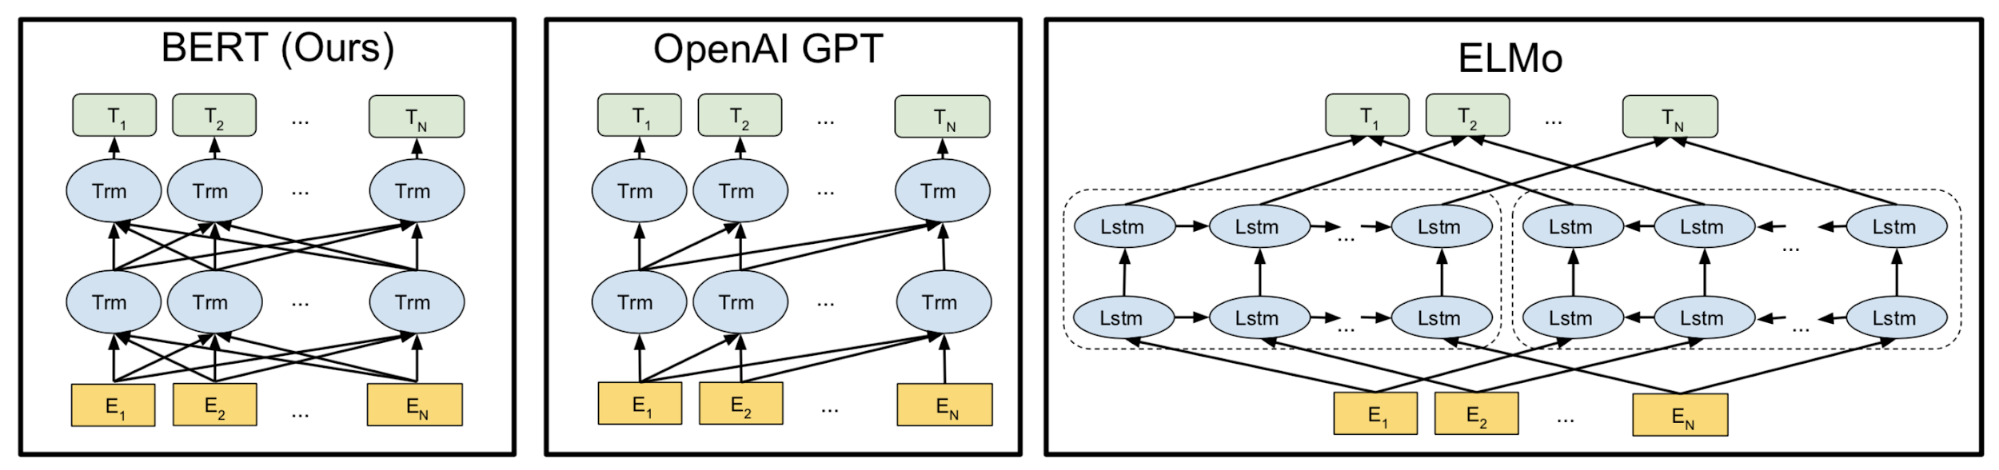
ELMo使用双向LSTM,将预训练得到的上下文向量作为额外特征输入到任务特定模型中,微调时需定制模型结构。而GPT和BERT采用Transformer架构,预训练后通过少量新增参数即可微调适配多种下游任务,无需为每个任务设计专门模型。这种统一框架大幅降低了应用成本,并提升了跨任务泛化能力。
BERT的双向性与训练任务设计
BERT的核心改进是双向Transformer编码器,通过掩码语言模型(MLM)和下一句预测(NSP)两个任务进行预训练。MLM随机遮盖15%的词,并采用80%替换为[MASK]、10%随机词、10%保留原词的策略,迫使模型学习左右上下文。NSP则帮助模型理解句子间关系。这种设计使BERT在多项NLP任务上取得突破。
模型演进中的效率与规模权衡
后续模型如ALBERT通过分解嵌入参数和跨层参数共享,在减少参数量的同时保持性能;GPT-2和GPT-3则大幅增加参数量(从1.5B到175B),探索零样本和少样本学习。RoBERTa通过更长时间训练、更大批次和动态掩码优化BERT。这些改进反映了NLP领域在模型效率与规模之间的不同探索方向。
Q&A
广义语言模型中的预训练语言模型是如何解决传统词嵌入无法区分语境的问题的?
预训练语言模型通过无监督预训练学习上下文相关的词表示,再微调适配下游任务,从而解决传统词嵌入无法区分语境的问题。
BERT和GPT在模型架构和训练方式上有什么主要区别?
BERT采用双向Transformer和掩码语言模型,GPT为单向生成模型。
ULMFiT在微调过程中使用了哪些技术来稳定训练?
ULMFiT使用了判别式微调(不同层不同学习率)和斜三角学习率(STLR)来稳定微调过程。
ALBERT相比BERT做了哪些改进来减少参数?
ALBERT通过分解嵌入参数化、跨层参数共享和用句子顺序预测(SOP)替换下一句预测(NSP)来减少参数并加速训练。
GPT-3在少样本学习上的表现如何?
GPT-3在少样本设置下无需梯度微调,就能在许多NLP数据集上达到与微调BERT模型相当的性能,且性能随模型规模和示例数量增加而提升。
XLNet提出的排列语言建模目标解决了什么问题?
XLNet通过排列语言建模目标,结合了自回归模型和自编码器模型的优点,既能学习双向上下文,又避免了自编码器对掩码位置独立性的假设。
