


二进制量化 - 向量检索,速度提升40倍
内容提要
Qdrant的二进制量化技术显著提高了高维向量的检索速度,最多可达40倍,并减少内存消耗。该技术将浮点数向量转换为二进制值,优化了存储效率和搜索速度。尽管在小维度嵌入中效果较差,但在大数据集上,二进制量化能够在保持准确性的同时,实现更快的检索和更低的内存使用。
延伸解读
二进制量化的适用场景与限制
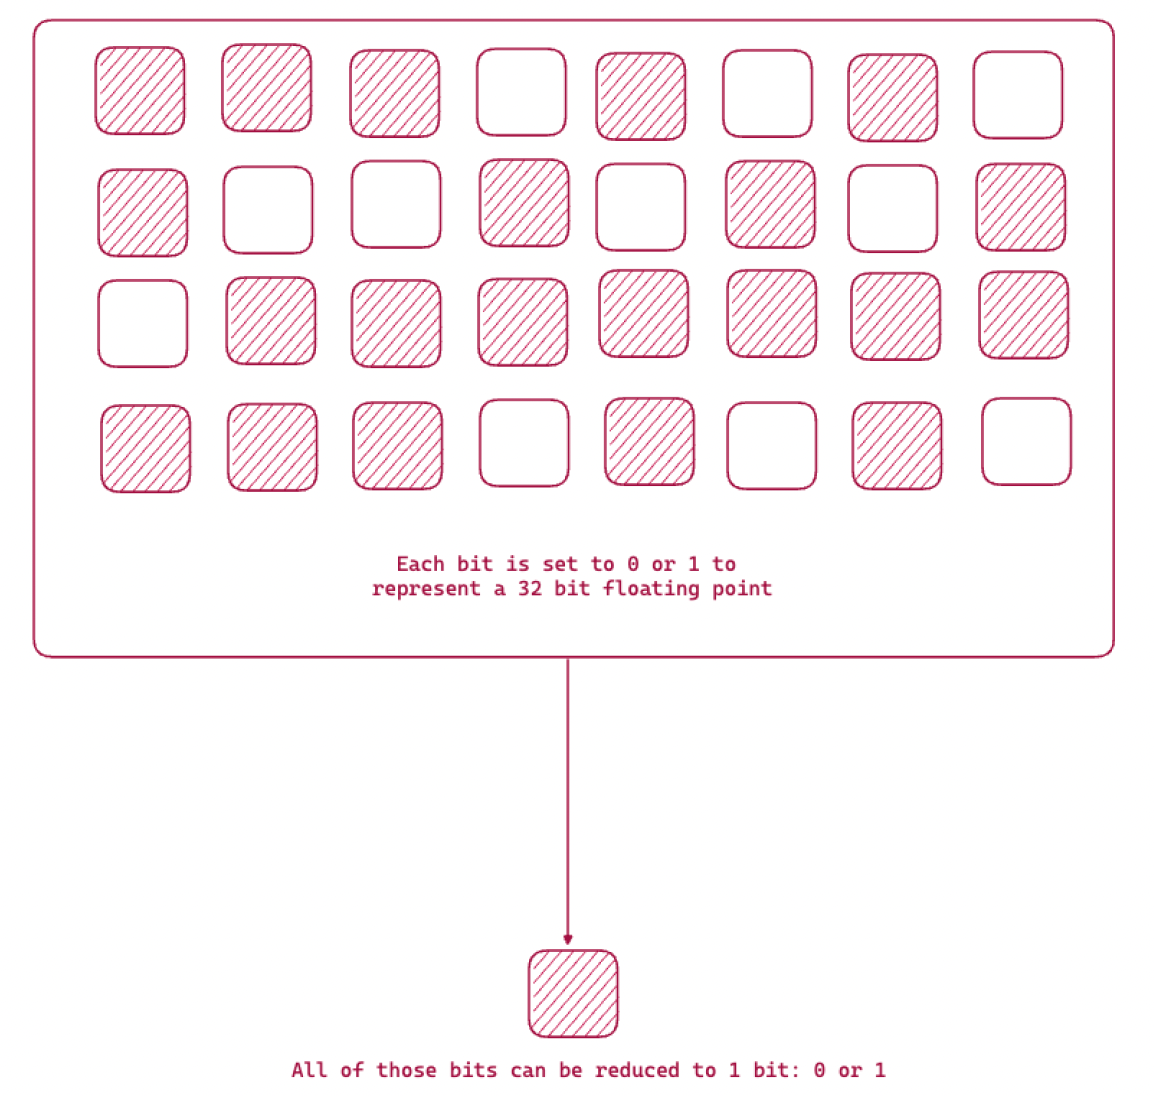
二进制量化通过将浮点向量转换为二进制值,大幅提升检索速度并降低内存占用,尤其适合高维向量(如1536维)和大规模数据集。然而,对于维度低于1024的嵌入,由于信息量不足,量化后精度下降可能过于显著,因此不建议使用。文章指出,OpenAI的1536维嵌入在检索任务上甚至不如384维的开源模型,说明高维向量存在过参数化,这为二进制量化提供了空间。
速度与精度的权衡:过采样与重打分
二进制量化在提升速度的同时会牺牲召回率,但Qdrant允许在搜索时动态调整权衡。通过设置过采样率(如2.0)和启用重打分(rescore=True),可以先在二进制索引中快速筛选候选,再用完整向量精确排序,从而在可接受的速度损失下提高准确性。文章建议使用OpenAI或Cohere嵌入时,过采样设为2.0或更高,并启用重打分。若对精度要求较低,也可仅使用二进制索引搜索。
内存优化与存储策略
二进制量化将32位浮点向量压缩为1位,显著减少内存占用。例如,10万个OpenAI向量(1536维)原本需要约900MB内存,量化后仅需128MB。Qdrant建议在创建集合时将完整向量存储在磁盘上,而二进制嵌入保留在内存中(always_ram=True),以平衡内存使用和检索速度。搜索时,二进制索引提供过采样候选,再从磁盘读取完整向量进行重打分,整个过程自动完成。
实践建议与配置要点
文章提供了具体配置示例:创建集合时启用二进制量化,设置on_disk=True存储完整向量,并配置always_ram=True。上传数据时可暂时禁用HNSW图构建(m=0)以加快上传,之后再将m设为16启用。搜索时通过SearchParams设置oversampling和rescore。对于OpenAI或Cohere嵌入,推荐过采样3倍(如text-embedding-3-large在3072维下召回率0.996),但需根据实际数据测试调整。
Q&A
二进制量化技术如何提高向量检索速度?
二进制量化技术通过将浮点数向量转换为二进制值,优化了存储效率和搜索速度,最多可提高检索速度40倍。
使用二进制量化时有哪些存储建议?
建议在创建集合时将完整向量存储在磁盘上,而将二进制嵌入存储在内存中,以节省内存。
二进制量化在小维度嵌入中的效果如何?
在小维度嵌入中,二进制量化效果较差,可能导致准确性下降。
如何在使用OpenAI嵌入时优化二进制量化的准确性?
建议设置oversampling为2.0或更高,并启用rescore,以提高准确性。
二进制量化对内存消耗的影响是什么?
使用二进制量化后,内存消耗显著减少,例如100K个OpenAI向量只需128MB的RAM。
二进制量化的实现过程是怎样的?
二进制量化通过构建二进制索引来提高搜索速度,而不是减少每个探测的搜索空间。
