


分布式数据库中隔离级别的陷阱
内容提要
在分布式数据库中,隔离级别对系统的可扩展性至关重要。可用的隔离级别包括可序列化、可重复读、快照读和已提交读。可序列化虽然理论上完美,但在实际应用中不实用,容易导致死锁。快照读适合只读工作负载,而已提交读则更灵活,适合修改数据的事务。为了提高可扩展性,建议使用较低的隔离级别,避免分布式事务,并尽量将相关数据保存在同一分片中。
延伸解读
可序列化隔离级别的实际代价
文章指出,可序列化隔离级别虽然理论完美,但在实际中不实用,甚至非分布式数据库也推荐避免使用。在银行案例中它表现良好,但在零售案例中,更新汇率的进程会被阻塞直到订单事务完成,导致不必要的依赖和扩展性问题。此外,可序列化容易引发死锁,例如两个事务先读后写同一行时,会因锁升级而互相阻塞。因此,对于有争用的负载,可序列化会限制扩展性;而无争用的负载则无需如此高的隔离级别。
快照读的适用场景与局限
快照读(MVCC)在事务开始时创建快照,读操作无锁,写操作遵循严格可序列化规则。它最适合只读工作负载,能提供一致的数据视图,并支持变更数据捕获等工具。但对于写事务,快照读并不比已提交读更有优势:若允许值变化,快照读到的值可能立即过时;若不允许变化,则需要锁定行以获取最新值。因此,快照读在写负载中并无额外好处,且分布式环境下实现分布式快照读需要集中式并发控制或全局时钟,增加了紧耦合。
已提交读的灵活性与锁升级
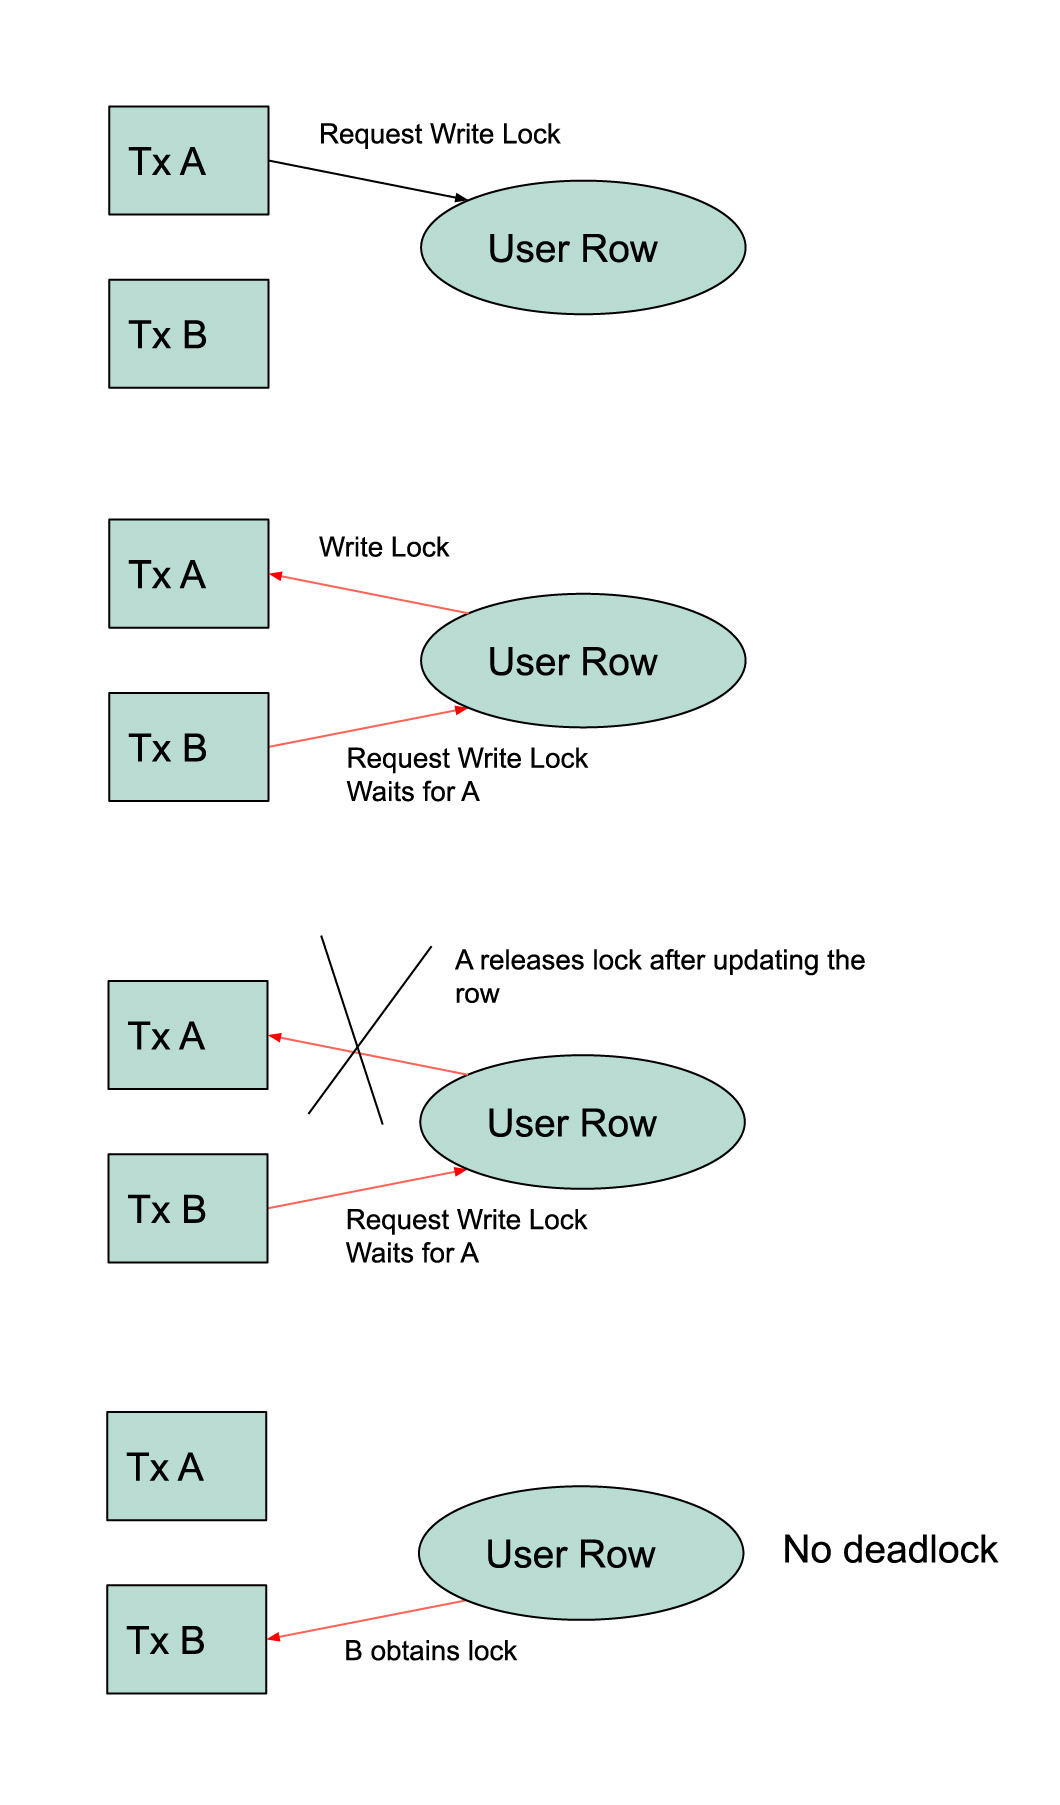
已提交读是最少争用的隔离级别,它始终返回数据库的最新视图,但每次读取可能得到不同的值。它允许通过读锁或写锁按需升级为可序列化读,从而在修改数据的事务中兼顾灵活性与一致性。例如,使用“select ... for update”写锁可以避免死锁,让竞争事务顺序执行。Postgres 默认使用已提交读。文章建议,如果应用能基于已提交读工作,就不应转向快照读,更不应使用可序列化或可重复读。
分布式事务与分片策略
分布式事务(如两阶段提交)会带来显著开销:需要持久化元数据、准备和提交多个节点,并与隔离级别交互,例如部分提交时需防止应用读到不一致状态。过度使用 2PC 会降低可用性和增加延迟,因为系统可用性受最差分片影响。文章建议避免分布式事务,通过将相关行保留在同一分片来实现。这些建议需要在应用设计初期就考虑,因为事后将非并发程序重构为并发程序非常困难。
Q&A
分布式数据库中的隔离级别有哪些?
分布式数据库中的隔离级别包括可序列化、可重复读、快照读和已提交读。
为什么可序列化隔离级别在实际应用中不实用?
可序列化隔离级别容易导致死锁,并且在复杂事务中会影响系统的可扩展性。
快照读适合什么样的工作负载?
快照读适合只读工作负载,因为它避免了锁的争用,提供一致的快照视图。
已提交读隔离级别有什么优势?
已提交读隔离级别灵活,适合修改数据的事务,并且允许读取最新的数据库视图。
如何提高分布式数据库的可扩展性?
为了提高可扩展性,建议使用较低的隔离级别,避免分布式事务,并将相关数据保存在同一分片中。
分布式事务对系统性能有什么影响?
分布式事务会增加系统的复杂性和开销,可能导致可用性和延迟降低。
