


三元组损失 - 高级介绍
内容提要
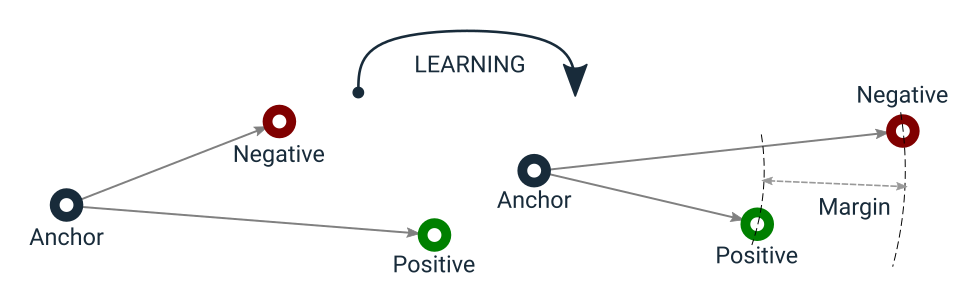
三元组损失(Triplet Loss)是一种相似性学习的损失函数,首次在2015年FaceNet中提出。它通过确保相似样本之间的距离小于不相似样本之间的距离来优化模型。与对比损失不同,三元组损失允许样本间的变异性,并通过在线三元组挖掘策略提高效率,动态生成有效的三元组以增强模型的学习能力。
延伸解读
三元组损失与对比损失的关键差异
三元组损失不强制将锚点和正样本编码到同一点,因此能容忍类内方差,允许簇拉伸以包含离群点,同时确保不同类样本间有间隔。对比损失则迫使锚点与正样本距离趋近于0,可能过早陷入局部极小。三元组损失更注重组织向量空间,使类间距离大于类内距离加边界。
在线三元组挖掘为何更高效
离线策略在每个epoch开始时生成三元组,需传递3n个样本才能得到n个三元组的损失,且三元组可能随权重更新失效。在线策略则从n个样本中动态生成n^3个可能三元组,仅使用有效子集,能获得更多损失值,提升学习效率。
高效实现中的距离矩阵与掩码技巧
通过距离矩阵和广播可向量化计算所有三元组损失,避免低效循环。距离矩阵利用||a-b||^2 = ||a||^2 - 2⟨a,b⟩ + ||b||^2高效计算,并处理数值稳定性。掩码则筛选出有效三元组:锚点与正样本标签相同且索引不同,负样本标签不同。
批量所有策略的简单性与局限
批量所有策略使用批次内所有有效三元组计算损失,实现简单,但可能包含大量简单三元组,导致梯度信号弱。更复杂的策略如批量困难挖掘和半困难挖掘能选择更有信息量的三元组,但实现更复杂,需单独讨论。
Q&A
三元组损失是什么?
三元组损失是一种相似性学习的损失函数,首次在2015年FaceNet中提出,旨在确保相似样本之间的距离小于不相似样本之间的距离。
三元组损失与对比损失有什么区别?
三元组损失允许样本间的变异性,能够容忍类内方差,而对比损失则强制相似样本的距离为零。
如何计算三元组损失?
三元组损失的计算公式为L=max(d(a,p) - d(a,n) + m, 0),其中d是样本间的距离,m是边际值。
什么是在线三元组挖掘策略?
在线三元组挖掘策略是动态生成有效三元组以增强模型学习能力的方法,相比离线策略更高效。
三元组损失的有效三元组如何形成?
有效三元组由锚点、正样本和负样本组成,需满足特定条件,如锚点和正样本标签相同,负样本标签不同。
如何提高三元组损失的计算效率?
可以通过距离矩阵和掩码技术来高效计算有效的三元组损失值,避免使用低效的嵌套循环。
