

现代大语言模型应用架构 [译]
内容提要
文章介绍构建大语言模型应用的五个步骤:聚焦具体问题、选择合适模型、通过上下文学习、RLHF或微调定制模型、搭建含用户输入、提示增强与负责任AI工具的架构、在线评估;并以客服案例说明用户输入、向量数据库、嵌入模型、数据过滤、提示优化、缓存、内容分类器和遥测等组件的协作方式。
延伸解读
从具体问题切入,避免过度设计
文章强调构建LLM应用的第一步是聚焦一个足够具体的问题,以便快速迭代,同时又要足够广泛以带来惊喜。GitHub Copilot的案例说明,从软件开发生命周期的一个环节(在IDE中编写功能代码)入手,而非试图解决所有开发者问题,是更可行的策略。这提示读者,在资源有限时,选择边界清晰、可验证的场景比追求大而全的方案更容易取得进展。
模型选择需权衡许可、规模与性能
文章指出选择预训练模型时要考虑商业许可、参数规模和性能。参数越多通常学习与预测能力越强,但小型模型在速度、成本上的优势及其预测质量的提升,使其成为有力竞争者。同时,在定制前应先通过离线评估衡量模型在速度、效率和一致性上的表现。这意味着读者不应盲目追求大模型,而应根据应用场景和预算,在许可允许的范围内综合评估。
定制技术各有适用场景与代价
文章对比了上下文学习、RLHF和微调三种定制方式。上下文学习通过提示中的指示或示例引导输出,灵活但依赖提示设计;RLHF借助奖励模型学习用户接受度,不依赖精确标签,能接受更多样输出;微调则需为每个输入提供标准答案,精确但耗时。读者应根据任务对精确度的要求、标注成本和输出多样性需求来选择,而非默认采用某一种方法。
架构组件协作决定应用体验与责任
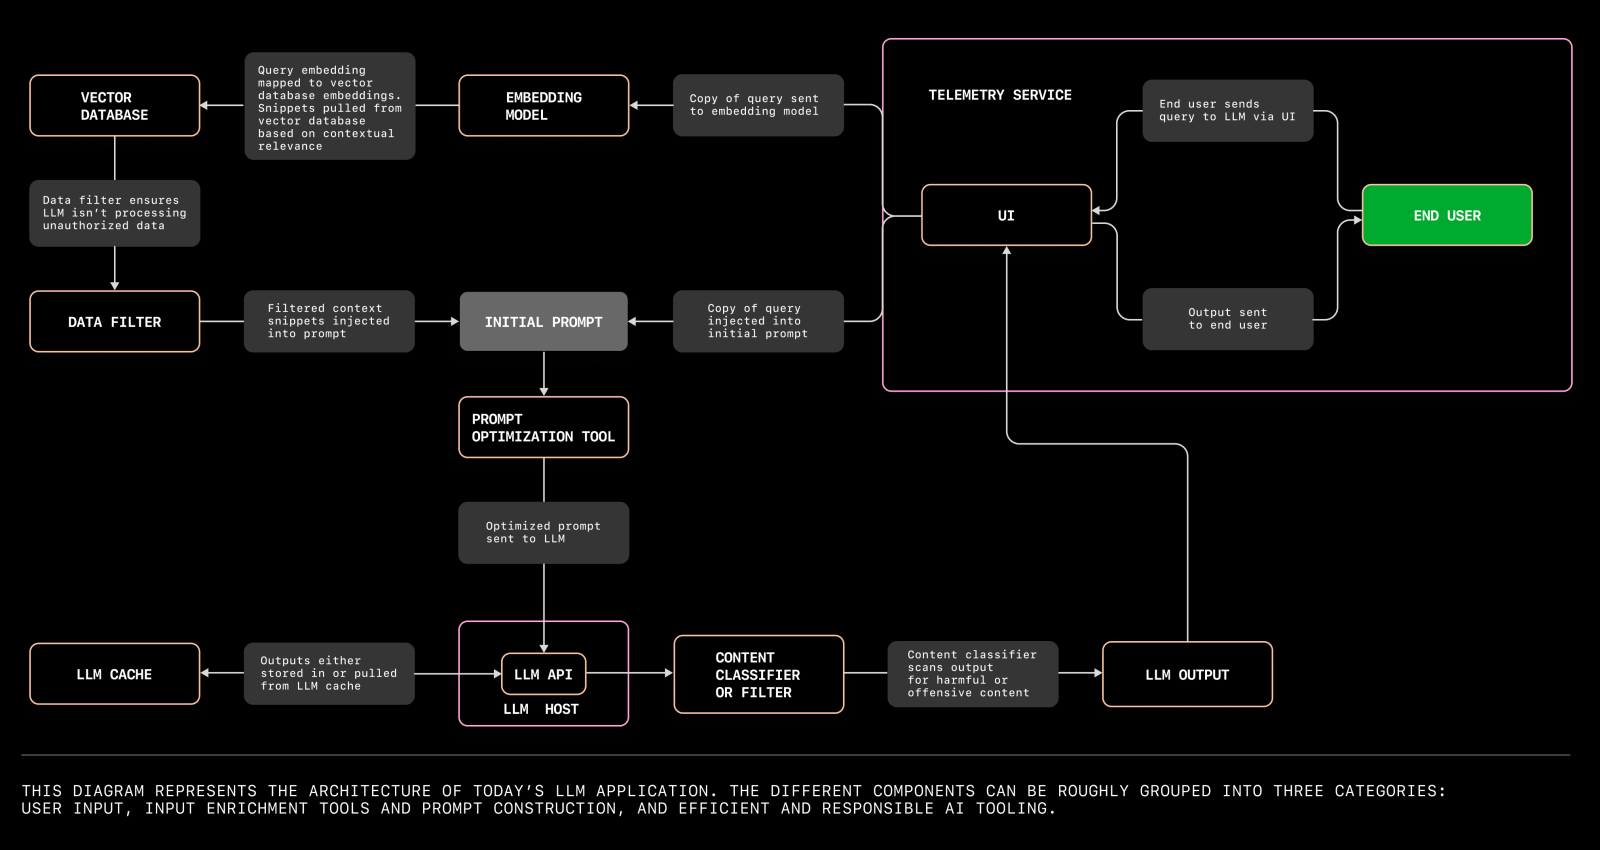
以客服案例为例,文章展示了用户输入、向量数据库、嵌入模型、数据过滤、提示优化、缓存、内容分类器和遥测等组件的协作。向量数据库与嵌入模型提升回答的相关性,数据过滤器防止未经授权数据进入模型,缓存降低延迟与成本,内容分类器避免有害回应,遥测则实时反馈真实表现。这提示读者,一个可用的LLM应用不仅需要模型本身,还需在效率、安全与可观测性上配套设计。
Q&A
构建大语言模型应用通常需要哪五个关键步骤?
五个关键步骤是:1. 专注解决一个具体问题;2. 选择合适的大语言模型;3. 通过上下文学习、RLHF或微调定制模型;4. 搭建应用架构(用户输入、输入增强与提示构建、高效且负责任的AI工具);5. 对应用进行在线评估。
选择大语言模型时应该考虑哪些因素?
选择模型时需考虑:许可问题(若计划商业销售需选择商业授权的API模型)、模型规模(参数从70亿到1750亿不等,小型模型运行更快成本更低但性能在提升)、以及模型在速度、效率和一致性方面的性能,可通过离线评估衡量。
上下文学习、RLHF和微调有什么区别?
上下文学习(提示工程)是在查询时提供指示或示例来指导模型输出;RLHF通过奖励模型预测用户是否接受输出,并反馈给原模型调整,不依赖精确标签;微调则是将模型输出与已知标准输出比较并调整参数,需要耗时的人工标注监督学习。
大语言模型应用的架构包含哪些组件类别?
架构组件大致分三类:用户输入(用户界面、LLM、托管平台);输入增强和提示构建工具(数据源、嵌入模型、向量数据库、提示构建与优化工具、数据过滤器);高效且负责任的AI工具(LLM缓存、内容分类器或过滤器、遥测服务)。
向量数据库和嵌入模型在LLM应用中起什么作用?
向量数据库存储嵌入或索引高维向量,通过提供额外信息增强用户查询的上下文,提高LLM给出有用回应的可能性。嵌入模型将用户查询转换成嵌入,使查询和数据库中的嵌入都变为高维向量,从而捕捉自然语言的语义和意图。
LLM缓存和内容分类器如何提升应用体验?
LLM缓存存储之前的回应,对相同问题可直接从缓存获取答案,减少等待时间、计算成本和建议的不确定性。内容分类器或过滤器阻止自动助手做出有害或冒犯的回应,尤其在面对用户愤怒时。
什么是在线评估?以GitHub Copilot为例说明。
在线评估是指在用户交互过程中评价LLM性能。例如GitHub Copilot通过计算接受率(开发者接受代码补全的频率)和保留率(开发者对接受的补全进行修改的频率和程度)来进行在线评估。
