

我做了一个浏览器扩展:把网页生词一键收进「不背单词」
内容提要
作者开发了“单词雷达”浏览器扩展,用于解决阅读英文技术文档时查词和记词的繁琐问题。该扩展可一键采集网页或选中文本中的生词,经词形还原、去重和缩略词过滤后,推送至“不背单词”生词本。项目从逆向接口打通推送,到上架 Chrome 和 Edge 商店,遵循人在回路、极简数据和最小权限原则。
延伸解读
从痛点出发:为什么现有工具不够用
作者在阅读英文技术文档时,常因生词中断阅读,手动查词并录入背单词App的流程繁琐。现有单词本与当前阅读内容脱节,预制词书无法覆盖GitHub Readme、RFC等页面的词汇分布。因此,作者希望将网页生词一键收集到正在使用的背单词App中,让背诵内容与真实阅读材料紧密相关。
技术实现的关键挑战与应对
项目最大不确定性在于能否程序化写入不背单词生词本。由于没有公开API,作者逆向官方查词插件,摸清接口并用真实账号打通。开发中遇到MV3 service worker被浏览器杀掉导致推送停滞,通过穿插扩展API调用作心跳保活;还解决了采集与入库的竞态问题,并引入NLP库进行词形还原。
产品化过程中的设计取舍
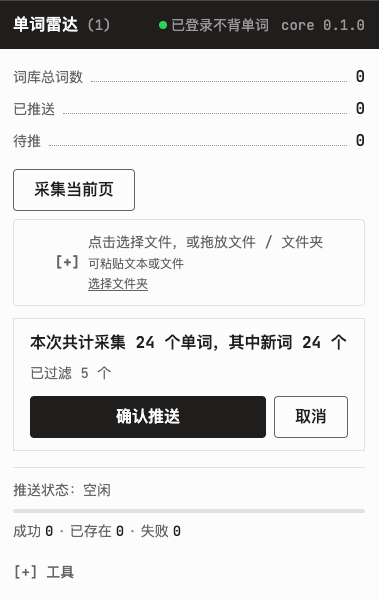
从自用工具到上架商店,作者增加了确认闸门,确保用户确认后才推送,坚持“人在回路”。推送进度实时可见,错误日志可导出。在词汇处理上,通过构建管线过滤缩略词,并给词形还原加词典守门,避免产生畸形词元。这些打磨让工具更可靠,也体现了对“什么算一个该收录的词”的深入思考。
克制原则与未来方向
工具遵循几条原则:确认即推送,永不后台自动推送;拾取做轻,背诵外包给不背单词;极简数据,本地词库只存必要字段;最小权限,仅申请storage、activeTab、scripting,网络访问限于bbdc.cn和langeasy.com.cn。多端同步、更多背单词App渠道等均在后续清单中,当前优先保证自用闭环的体验。
Q&A
单词雷达扩展的主要功能是什么?
单词雷达可以一键采集网页或选中文本中的英文生词,经过词形还原、去重和缩略词过滤后,推送到「不背单词」的生词本。还支持上传本地 .txt / .md 文件采集。
单词雷达如何处理采集到的单词?
先做归一化(所有格剥离、大小写折叠),再进行词形还原(如 cameras 归到 camera),按词元去重,并过滤缩略词和缩合形式,确保同一词的不同形态不会重复出现。
单词雷达如何将单词推送到不背单词?
作者逆向了不背单词官方查词插件的接口,摸清了网页端逐词添加生词本的接口,并用真实账号实测打通,实现了程序化推送。
单词雷达有哪些设计原则?
设计原则包括:人在回路(确认即推送,永不后台自动推送)、拾取做轻背诵外包(不解释词义,复习交给不背单词)、极简数据(本地词库只存单词和位掩码)、最小权限(只申请 storage/activeTab/scripting 权限,网络访问仅限 bbdc.cn 和 langeasy.com.cn)。
单词雷达在开发中遇到了哪些技术挑战?
主要挑战包括:MV3 service worker 在长循环中被杀导致推送停滞,通过心跳保活解决;采集与入库竞态导致计数为0,改为应答式消息链路;词形还原引入 compromise 库并处理不规则动词;缩略词过滤误杀常用词,通过词源判定规则修复;词形还原产生畸形词元,加词典守门回退。
单词雷达可以在哪里安装?
可以在 Chrome 商店和 Edge 商店直接安装,随版本发布自动更新,无需自己下载源码编译。安装后打开 bbdc.cn 登录一次即可使用。
