


机器学习模型部署:分步教程
内容提要
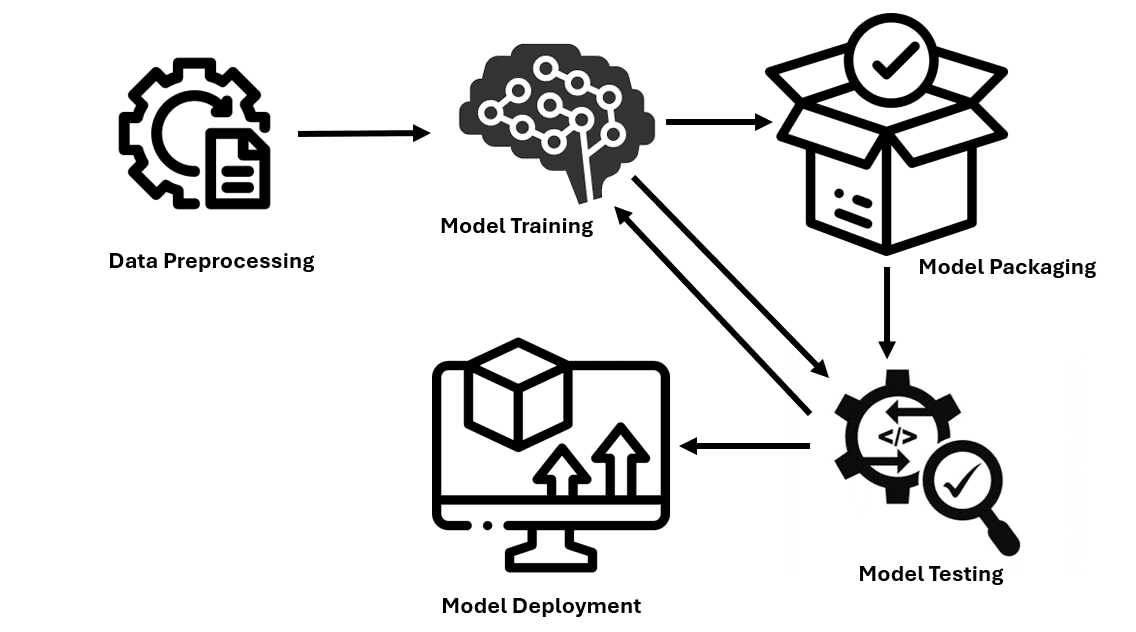
模型部署是将训练好的模型集成到实际应用中的过程,包括定义环境、指定输入输出,分析新数据并提供预测分类能力。部署步骤包括数据预处理、模型训练评估、模型打包、环境设置、构建部署流水线、模型测试、监控维护。通过这些步骤,使机器学习模型可用易于部署。
延伸解读
部署流程的七个步骤
文章将模型部署拆解为七个步骤:数据预处理、模型训练与评估、模型打包、环境设置、构建部署流水线、模型测试、监控与维护。这提供了一个从开发到上线的完整框架,读者可以按此顺序逐步实施,避免遗漏关键环节。每个步骤都配有代码示例,便于理解具体操作。
数据预处理与模型训练的关键点
数据预处理包括缺失值处理、分类变量编码和数值特征标准化,这些是模型训练前的基础工作。模型训练时需划分训练集和测试集,并通过超参数调优和交叉验证来提升模型性能。文章使用scikit-learn库演示了这些操作,强调了数据准备和模型评估对最终部署效果的重要性。
模型打包与容器化
模型打包是将训练好的模型序列化为可存储或分发的格式,常用Pickle、joblib或ONNX。文章还介绍了使用Docker容器化模型,使其更便携,易于在不同环境中迁移。这有助于解决环境依赖问题,确保模型在生产环境中的一致性。
部署环境与自动化流水线
部署环境建议使用云服务(如AWS、Azure、Google Cloud)来配置服务器和数据库等资源。构建部署流水线可借助Jenkins或GitLab CI/CD实现自动化,提高部署效率。文章提供了各云平台的CLI命令示例和Jenkinsfile片段,展示了如何自动化构建、测试和部署。
Q&A
模型部署的主要步骤有哪些?
模型部署的主要步骤包括数据预处理、模型训练评估、模型打包、环境设置、构建部署流水线、模型测试和监控维护。
如何进行数据预处理?
数据预处理包括处理缺失值、转换分类变量和标准化数值特征。
模型训练和评估的关键步骤是什么?
模型训练和评估的关键步骤是将数据分为训练集和测试集,并进行超参数调优和交叉验证。
如何打包机器学习模型?
模型打包是将模型序列化为适合存储和分发的格式,可以使用Pickle、joblib或ONNX等格式。
部署机器学习模型时环境设置的建议是什么?
建议使用云服务如AWS、Azure或Google Cloud来配置基础设施和资源。
如何监控和维护已部署的模型?
可以使用AWS CloudWatch、Azure Monitor等工具来监控模型的性能并进行维护。
