


rust手写神经网络
内容提要
本文介绍了如何用Rust实现全连接神经网络,包括训练过程、损失函数、正向传播和反向传播的实现。通过分批训练样本,计算损失并更新网络参数,详细描述了激活函数层和全连接层的结构及操作,并提供了相应的Rust代码示例,展示了神经元权重和偏置的更新过程。
延伸解读
训练流程与梯度计算
文章采用分批训练,每个批次包含多个样本。正向传播时记录每个样本的中间结果,计算损失后反向传播,利用链式法则求梯度。由于损失函数是平方和形式,每个样本的梯度可独立计算,最后取平均得到批次梯度。这种设计便于并行处理,但需注意缓存中间结果以支持反向传播。
层抽象与激活函数分离
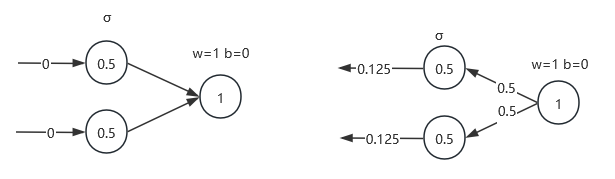
网络模型由多个层组成,每层实现正向传播、反向传播和参数更新接口。全连接层被拆分为无激活的全连接层和独立的激活函数层,这样设计更灵活,可自由组合不同激活函数。激活函数层使用sigmoid,其导数可由输出值直接计算,简化了反向传播。
全连接层的参数更新
全连接层存储权重矩阵和偏置向量。正向传播计算加权和,反向传播时,权重梯度为输入激活值与传递梯度的乘积,偏置梯度为传递梯度。更新时按学习率调整参数。文章通过测试用例验证了计算过程,但未涉及优化器或正则化,可能影响模型泛化能力。
Q&A
如何用Rust实现全连接神经网络的训练过程?
训练过程包括确定损失函数,通过分批训练样本计算损失并更新网络参数,使用正向传播和反向传播来调整权重和偏置。
神经网络中的激活函数层是如何工作的?
激活函数层使用sigmoid作为激活函数,正向传播时计算每个输入的sigmoid值,反向传播时使用sigmoid的导数进行梯度计算。
全连接层在神经网络中有什么作用?
全连接层存储每个神经元的权重和偏置,负责计算每个神经元的激活值,并在反向传播中计算梯度以更新参数。
损失函数的计算公式是什么?
损失函数的计算公式为 $$ loss= rac{1}{n} ext{sum}(f(x_i)-y_i)^2 $$,其中$f(x)$为样本的推理结果,$y$是目标结果。
在Rust中如何实现正向传播和反向传播?
正向传播通过计算每层神经元的激活值实现,反向传播则通过链式法则计算梯度并更新参数。
如何通过多轮训练来优化神经网络模型?
通过多轮训练,使用所有训练样本计算损失,并根据损失值调整网络参数,直到得到满意的模型。
