文章以数学老师预测学生成绩为例,说明现实数据常呈非线性关系。分段线性函数可在不同区间采用不同规则,ReLU即属此类,将负值归零;S形曲线过渡更平滑,sigmoid函数把输入映射到0至1,适合表示概率。文中用简单神经网络演示:隐藏层用ReLU处理学习时长,输出层分别用线性变换预测分数、用sigmoid预测及格概率,说明非线性使网络能学习复杂关系。
作者将Maven式构建工具的决策逻辑编译为固定权重矩阵,未经训练即嵌入神经网络,成功构建ZXing,产出与Apache Maven逐字节相同的JAR,549个测试全部通过。完整构建耗时约为Python版的1.42倍,优化编译器后步骤减少23%。其价值不在提速,而在于权重含义已知,可用于检验可解释性工具、嵌入学习模型及哈希验证决策逻辑。
作者借 Nick Cammarata 的长文指出,人们误以为神经网络不可理喻,实则其逻辑清晰,例如某个神经元可同时被猫脸和车前脸激活,无需强行区分。作者由此感悟:AI 之所以令人欣喜又警惕,是因为它作为人类造物,却要求人类反过来学习它的逻辑,如同顺应水流、接受光照,这种反应很自然。
OpenAI前研究员用Qwen3-32B检验神经网络的可解释性:“神经网络已经很干净了” 神经网络可解释性研究正在遭遇一次关键转向,OpenAI前研究员Nick Cammarata提出,现代大语言模型的神经元可能比传统理论预想得更容易理解,Qwen3-32B审计结果也引发了争论。叠加理论、稀疏自编码器和递归泛化之间的分
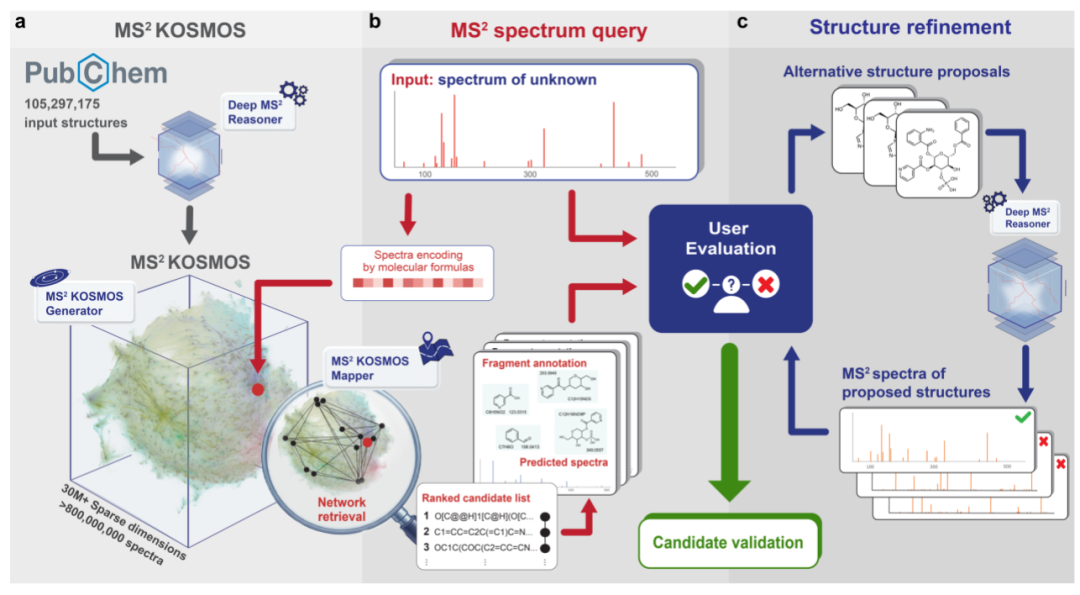
康奈尔大学团队开发了多智能体神经符号框架AIMe,结合化学规则与神经网络模拟分子碎裂,为PubChem中超过1亿个小分子生成了8亿多张预测质谱,构建了MS²KOSMOS,使可搜索质谱空间扩大约3个数量级。该模型在CASMI等测试中表现领先,并应用于小鼠代谢物及GNPS数据库注释,但结果仍属Level 3注释,需实验验证。
该文推荐五门免费课程,构成从基础到实践的LLM学习路径:Karpathy的《Neural Networks: Zero to Hero》教构建神经网络和GPT;FSDL LLM Bootcamp讲生产架构;斯坦福CS336深入理论和扩展;Hugging Face课程练微调;DeepLearning.AI短课学部署和智能体。总计约80-120小时,建议按顺序或选择性学习,以实践为主。
随机初始化的神经网络无需训练即可区分图像类别,因其架构经数十年数据筛选固化了“先天偏见”。Transformer也预编码了文本规律。AI自动化架构搜索将加速此过程,但评估标准仍依赖旧数据集,可能放大偏见,决定下一代AI形态。
神经网络通过输入、权重、偏置和激活函数进行预测,并利用损失函数、反向传播和梯度下降优化参数。本文用Python和NumPy从零构建XOR神经网络,详解前向传播、损失计算、反向传播和参数更新,并与PyTorch实现对比,强调理解基础原理的重要性。
本文面向初中生介绍人工智能基础知识,从哲学起源讲起,经图灵与计算机科学奠基,至1956年达特茅斯会议确立AI概念。重点阐述连接学派发展:万能近似定理、神经网络历经寒冬与复兴,最终Transformer架构实现并行训练,催生GPT等大模型,并迈向能调用工具的智能体生态。
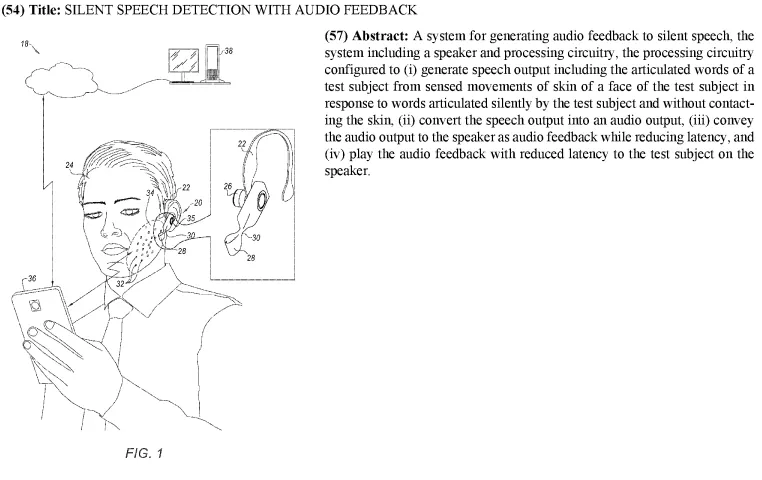
苹果申请了一项默声语音检测专利,通过光学传感器捕捉面部肌肉微动,经神经网络解码为文字并合成语音,延迟低于100毫秒。系统支持耳机或眼镜集成,可离线或分布式运行,并强调低延迟音频反馈以确认识别结果。该技术路线已有先例,核心创新在于本地反馈和硬件架构。
本文介绍PyTorch深度学习框架,涵盖其特性、张量操作、环境搭建及构建MNIST手写数字识别模型的全流程。教程指导使用PyCharm配置环境、定义神经网络、训练并评估模型,最终达到96.87%测试准确率,并提及GPU加速、分布式训练等进阶技术。
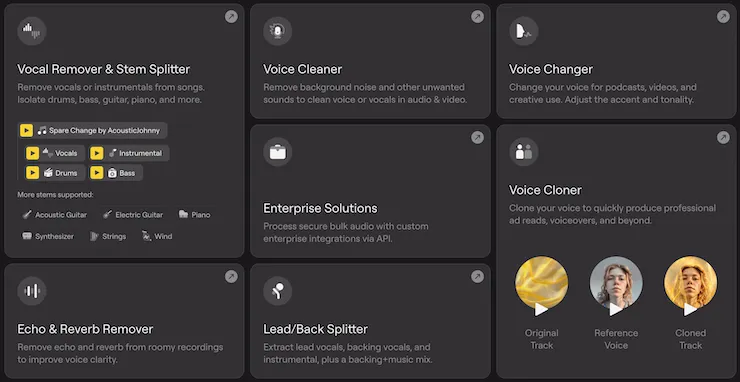
LALAL.AI推出专为语音降噪设计的神经网络Lynx,能分离人声与背景噪音,生成干净人声轨道,节省后期制作时间。模型比旗舰版小六倍,基于人工整理数据训练。Lynx已上线,成为平台使用量第二大的分离音轨,预计2025年处理超1150万音频分割,未来将改进合唱分离和远距离语音隔离。
深度学习是机器学习的一个子集,利用多层神经网络模拟人脑结构。主要类型包括卷积神经网络(CNN)、递归神经网络(RNN)和变换器(Transformers)。Keras是一个用户友好的深度学习API,简化模型构建和训练过程。
文章探讨了AI基础设施中的向量、神经网络和深度学习的核心概念。向量将词语转化为数字以计算相似度,点积运算用于衡量向量对齐程度。神经网络通过多层结构重塑输入,激活函数影响学习效果,损失函数定义错误,训练通过梯度下降优化模型参数。文章指出当前模型在处理上下文时的局限性,强调Transformer架构的重要性。
研究表明,人工智能模型并未收敛于同一世界模型,而是形成了相似的邻里关系。通过校准相似度指标,发现许多增长只是统计幻觉。新的“亚里士多德表征假说”强调模型间的关系结构,未来研究应关注邻居关系的对齐。
特伦斯·陶与达梅克·戴维斯在SAIR基金会发起了数学挑战,旨在简化解决2200万代数问题的能力。第一阶段已完成,生成了有效的“备忘单”。第二阶段正在进行,参赛者需使用Python代码生成Lean证明。新挑战聚焦于神经网络执行简单的模乘运算,探索其在处理大输入时的可扩展性。
神经网络通过前向传播、损失计算、反向传播和梯度下降进行训练。每个神经元执行线性打分和非线性激活,多个神经元组成层,层与层之间的非线性使网络能够拟合复杂函数。递归神经网络(RNN)通过引入状态,克服了多层感知器(MLP)在序列任务中的局限性。训练过程是参数在损失曲面上逐步优化的过程。
最新研究发现,快速抗抑郁的关键在于前额叶与岛叶的连接。经颅磁刺激(TMS)通过激活这一回路,显著提升情绪网络功能。研究表明,刺激前额叶后岛叶被激活,若切断连接则抗抑郁效果消失。这一发现可能改变抑郁症的治疗方法,未来将更注重神经网络的精准调控。
苹果研究人员提出了ParaRNN框架,显著提高了非线性递归神经网络(RNN)的训练效率,实现了大规模并行训练。该方法使得7亿参数的RNN在语言建模任务中表现出与变换器相当的性能,且通过引入牛顿法,ParaRNN在保持非线性表达能力的同时实现了高效的并行计算。这一进展为RNN的广泛应用和进一步研究提供了新的可能性。
最近发布了用Rust编写的轻量级自动微分库ferris-grad。该库具有PyTorch风格的自动求导引擎,核心代码不到1000行,且无外部依赖。实现包括标量计算图、张量操作和神经网络层,支持训练多层感知机和mini GPT。项目灵感来源于Karpathy的micrograd和microgpt,欢迎参与贡献。
完成下面两步后,将自动完成登录并继续当前操作。