AI Native 时代的工作方式:从信息到交付
内容提要
作者分享AI Native工作实践:信息经Agent加工入仓库,改动走PR、人看diff决策;编码采用规格驱动,细节代码少看但以指南约束,并用自测Agent分层验证;工具链自建mind-forge、skm等。核心判断是AI放大执行、人负责判断,AI善“作”,人负责“创”。
延伸解读
信息处理:仓库化与PR评审
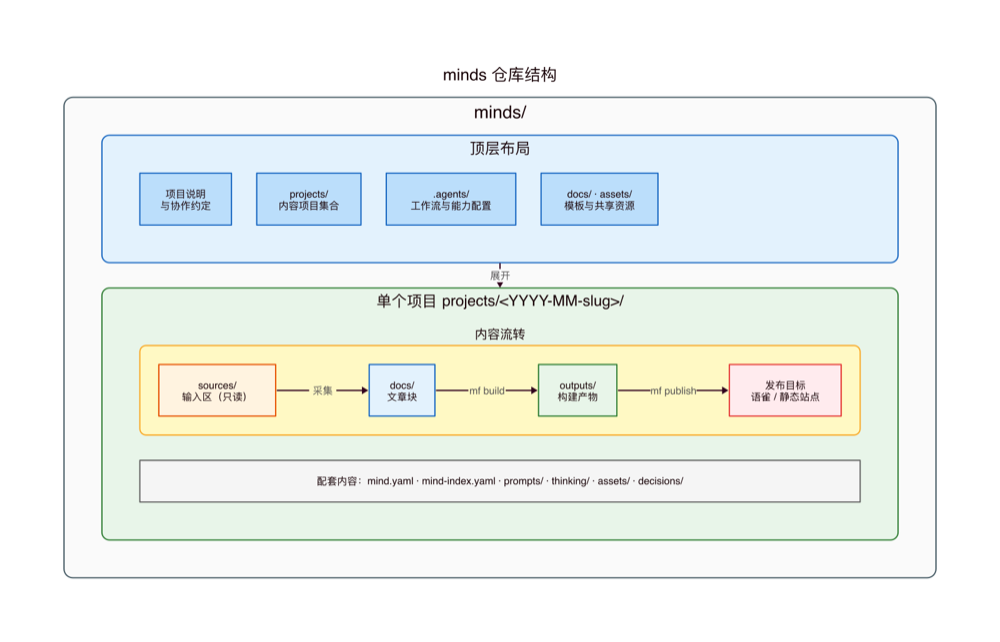
作者将信息处理流程从聊天窗口迁移到自建Forgejo上的知识仓库,所有材料经Agent加工后以PR形式提交,人只审diff决定合并。两个仓库AI参与度差异显著:minds达90%以上,my-kms仅5%。这种设计确保Agent改动可review、可回滚,同时保留私有数据不出机器。核心在于材料进仓库而非留在对话中,使信息可检索、可继续加工。
AI Coding:规格驱动与约束替代细节审查
编码方式转向规格驱动,团队强制使用spec框架定义边界和验收标准。细节代码关注减少,但通过guides固化约束,明确看什么、不看什么、何时必须看。自测Agent按成本分层验证,从smoke到E2E,最终给出带证据的结论并回写验收。这要求写清楚写什么、按什么写、怎么算做完,而非逐行盯代码。
工具链自建:效率提升的隐藏线路
作者投入自建工具链,如mind-forge管理知识仓库、skm跨电脑管理SKILL,并组合社区与自写skills(如speckit、grilling、humanizer)。这些工具支撑信息、研发、落地三条线中的隐藏线路——优化工具链路。工具选择强调本地优先和可部署性,旨在加强个人管理与产出速度,而非依赖单点工具。
人的角色:创与作的分离
作者判断AI放大执行,人负责判断。创作拆分为创与作:AI善于生产、展开、润色,人负责问题、判断、表达。信息处理中框架和观点自己出,AI展开润色;编码中规格和约束由人定,AI执行。提效会到瓶颈,决策密度成为新卡点,开会因加速产出和分歧更快而更重要,共识形成需要人。
Q&A
AI Native 工作方式中,人和 AI 的分工是什么?
AI 放大执行,人负责判断。AI 善于“作”,即生产、展开、润色;人负责“创”,即提出问题、做出判断、形成观点和表达。
如何用 Agent 管理个人知识信息?
将本地创作、会议、文档、IM 消息统一进入 Agent,Agent 开 worktree 改文件、提交、推分支、发 PR。人只看 diff 决定是否合并。每天可提 10+ 个知识经营 PR。
AI Coding 中 spec-driven 开发为什么成为团队要求?
因为规格、边界、验收标准是研发的起点。使用 speckit、superpower 等 spec 框架,从个人选择变成团队强制要求,这是今年最明显的变化。
自测 Agent 如何分层验证 AI 生成的代码?
按成本从低到高分层,fail-fast:smoke 层验证服务启动和健康闸口;API 层用 Hurl 验证 REST 合约;CLI 层用 bash+Go 验证命令行行为;E2E 层用 Playwright 验证前端关键交互。最后给出带运行证据的结论并回写验收。
作者自建了哪些工具链来支持 AI Native 工作?
包括 mind-forge 知识库管理器、skm 跨电脑管理 SKILL 的管理器、以及一系列 skills:speckit、grilling、humanizer、spec-report-html、spec-status、spec-update、session-retro、chat、distill-memory、repo-analyzer、mf-cli 等。
在 AI 辅助写作中如何保持人味?
框架自己构思,结构自己把控;长内容先语音,AI 整理、汇总、润色、结构化;观点来自自己的输入;图尽量自己画。人味不是靠 AI 模仿,而是因为框架和观点本来就是自己的。
