
大语言模型的盲区:为何模型会遗忘提示词中间的内容
内容提要
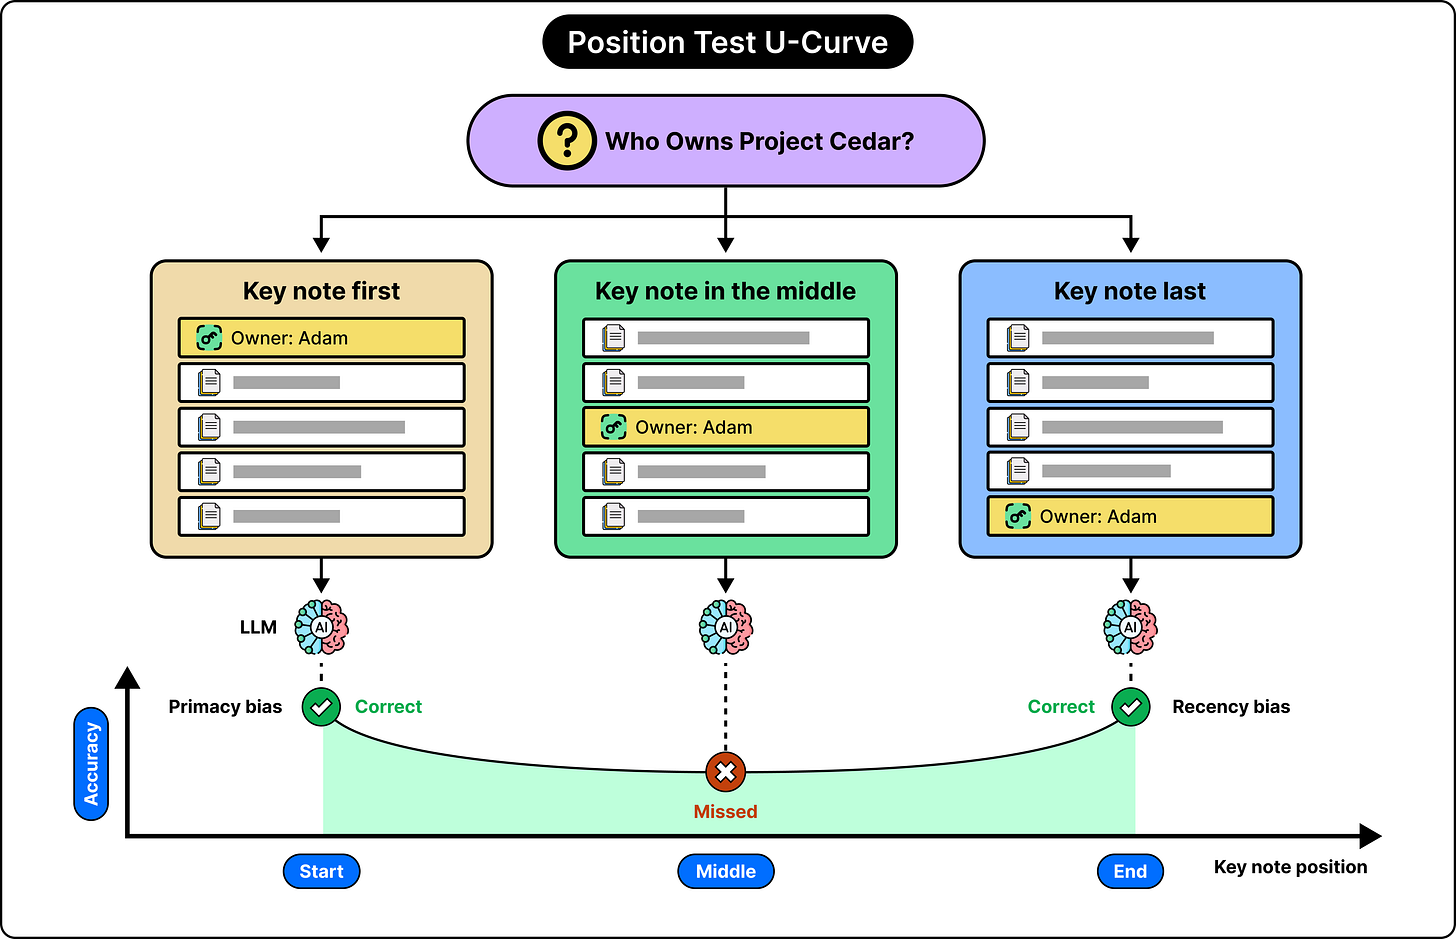
大语言模型存在“中间迷失”现象:关键信息位于长提示词中部时易被忽略,准确率呈U形曲线,开头和结尾表现更好。原因是注意力机制更偏向早期和临近结尾的信息,扩大上下文窗口也无法根治。可通过优化提示结构、精简无关内容、使用RAG检索缓解,但无法完全避免。
延伸解读
“中间迷失”的成因:注意力机制的位置偏差
文章指出,大语言模型对提示词不同位置的信息处理并不均衡。由于因果掩码的存在,早期信息有更多路径影响后续计算,而结尾信息因靠近问题与答案而获得近邻优势。中间部分则缺乏这两种优势,导致注意力权重较低,信息易被忽略。这解释了为何扩大上下文窗口无法根治该问题,因为容量提升不等于每个位置都能被可靠利用。
实际影响:信息存在不等于被使用
文章通过审计日志保留37天的例子说明,即使关键规则明确写在提示词中且未超出上下文限制,模型仍可能忽略它并生成错误代码。这提醒开发者,不能仅因为信息已放入提示词就假设模型会正确使用。在长提示词中,关键约束若位于中部,被遗漏的风险显著增加,需通过结构优化或检索来降低风险。
缓解策略:优化提示结构与检索
文章建议通过优化提示结构、精简无关内容和使用RAG检索来缓解中间迷失。例如,将任务、约束和问题明确标识,用Markdown或XML标签区分内容,并避免在提示词中堆砌无关材料。RAG可将检索责任转移给应用,但检索本身也可能遗漏关键段落或引入过多内容,因此仍需谨慎选择、排序和评估检索结果。
局限与注意事项:无法完全避免
文章强调,上述策略只能减少中间迷失的发生概率,无法完全消除。模型对中间信息的偏差受模型架构、训练和任务类型影响,不同模型表现可能不同。此外,精简上下文时若删除必要的例外或依赖,反而会降低准确性。因此,在实际应用中应针对具体模型和任务进行测试,并保留关键细节的原始来源。
Q&A
什么是大语言模型的“中间迷失”现象?
“中间迷失”是指当关键信息位于长提示词中部时,大语言模型容易忽略它,导致准确率下降。模型对提示词开头和结尾的信息利用更好,中间部分表现较差,形成U形准确率曲线。
为什么大语言模型会更关注提示词的开头和结尾?
模型使用Transformer架构,其注意力机制使早期信息有更多机会影响后续处理,而结尾信息因靠近问题和答案而受益。中间部分则缺乏这两种优势,因此影响力较弱。
扩大上下文窗口能解决中间迷失问题吗?
不能。更大的上下文窗口只增加容量,不保证每个位置的信息都能被可靠利用。有效上下文大小取决于任务,且随着输入长度增加,模型性能可能下降。
有哪些方法可以缓解中间迷失现象?
可以通过优化提示结构(如将关键约束放在开头或结尾、使用清晰标记)、精简无关上下文、以及使用RAG检索相关片段来缓解。但这些方法只能减少风险,无法完全避免。
RAG如何帮助解决中间迷失问题?
RAG通过检索系统从大量资料中选出相关片段,减少模型需要在长提示词中搜索的范围。但检索可能遗漏关键信息,且检索过多片段仍可能重现中间迷失问题。
中间迷失现象是否意味着模型完全看不到中间的信息?
不是。信息仍在上下文窗口中,模型也能访问,但注意力机制可能使其对最终答案的影响较小。这并非信息被隐藏,而是信息在表示和组合过程中未获得足够权重。
