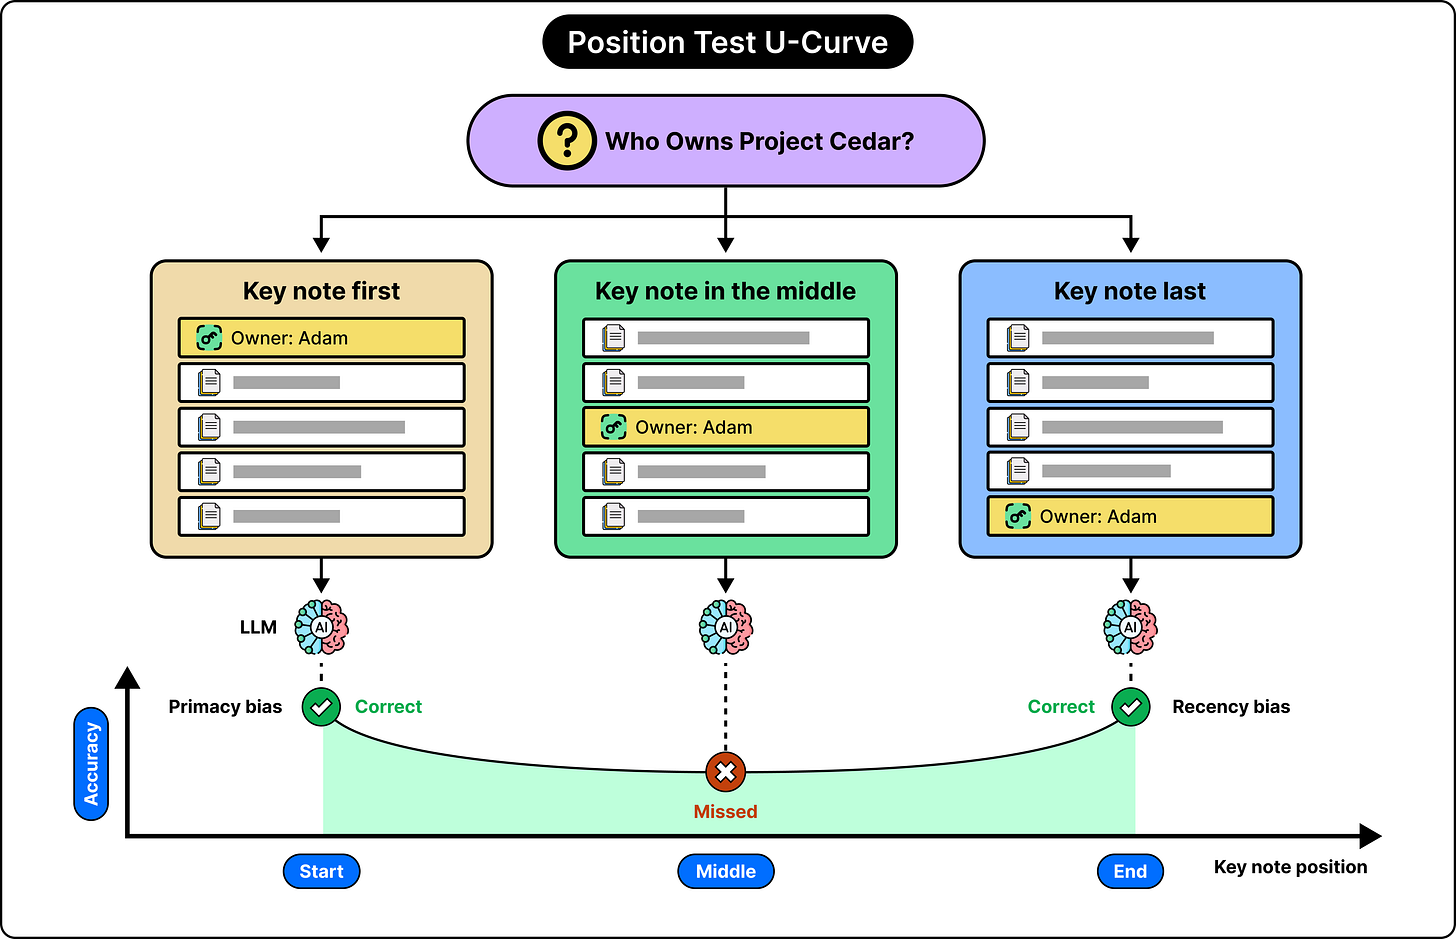
大语言模型存在“中间迷失”现象:关键信息位于长提示词中部时易被忽略,准确率呈U形曲线,开头和结尾表现更好。原因是注意力机制更偏向早期和临近结尾的信息,扩大上下文窗口也无法根治。可通过优化提示结构、精简无关内容、使用RAG检索缓解,但无法完全避免。
本文探讨Transformer注意力机制的计算复杂度问题,指出标准注意力在长上下文下时间和空间开销呈平方增长。文章概述了高效注意力、FlashAttention和线性注意力等优化方案,其中线性注意力通过将Softmax替换为elu+1特征映射,将复杂度降至线性,并引入RNN式递归状态,为后续Kimi等长上下文模型奠定基础。
本文介绍DeepSeek-V4的注意力机制,从MHA到CSA/HCA的演进,重点分析压缩KV缓存的方法。V4将每4或128个token压缩为一条512维KV向量,采用重叠窗口和逐通道softmax加权,K与V共享单头,配合分组输出投影降低参数。相比前代,V4首次压缩缓存条目数,以支持1M上下文的高效推理。
该论文提出Transformer架构,以“圆桌会议”式注意力机制取代RNN的排队传话,实现并行处理,成为现代AI基础。它通过Q/K/V机制理解词义,多头注意力和位置编码增强效果。实战中,上下文计算量平方增长,重要信息应放开头或结尾,提示词缓存可降成本,RAG能补充模型知识。
Transformer 将进化为混合架构,结合注意力机制、长程状态和外部记忆等模块,以更高效地处理信息并支持多模态输入。硬件发展将影响架构设计,评估方式将变得复杂,强调系统协作和可控性。理解 Transformer 的成功在于其抽象层次和应对未来挑战的能力。
本文探讨了大语言模型在推理阶段的退化现象,如死循环和乱码等问题。退化源于自回归Transformer的注意力机制和数值精度,导致输出失控。文章分析了退化的数学根源、表现形式及其机制,并提出了多层防御策略,包括架构设计、数值工程和解码策略,以提高模型在生产环境中的稳定性。
本文介绍状态空间模型(SSM)如何通过固定大小状态压缩历史,解决Transformer长序列瓶颈。S4用HiPPO矩阵实现长程记忆,Mamba引入选择性机制按内容更新状态,并用并行扫描保持训练效率。推理时SSM显存O(1)优于KV Cache,但在精确检索任务上受容量限制。SSD揭示SSM与注意力对偶,混合架构如Jamba平衡两者优势。
Transformer是过去十年最成功的深度学习架构,但其核心限制在于标准attention的O(n²)计算复杂度已被证明是理论下界,无法通过工程优化突破。此外,KV Cache线性增长、自回归串行性、长上下文不等于长期记忆、位置外推失效及数据供给上限等问题,共同构成架构瓶颈。新架构需在质量、成本、稳定性、生态四条战线同时超越Transformer,才能实现替代。
本文探讨视觉Transformer(ViT)的核心设计:将图像切分为patch作为token,并分析其代价。关键点包括:patch大小与分辨率决定序列长度,影响注意力机制的二次方计算成本;CNN的归纳偏置在小数据上更优,而ViT需大数据;DeiT通过数据增强和蒸馏提升训练效率;Swin通过窗口注意力降低复杂度。文章还讨论了位置编码失效、层级结构及未来高分辨率挑战。
本文介绍DiT(扩散Transformer),用Transformer替代U-Net作为扩散模型去噪网络。DiT在潜在空间通过patchify和adaLN-Zero条件注入,以更少计算量取得更优FID,但U-Net经调优仍具竞争力。视频生成中,时空token数量爆炸,联合注意力成本随帧数平方增长,需用分解式注意力平衡效率与一致性。Sora架构细节未公开,且承认物理模拟等局限。
RoPE通过旋转Q和K向量,使注意力分数依赖相对位置而非绝对位置。它利用多频率几何级数实现多尺度位置感知,保持向量范数,支持位置平移不变性。但存在周期性和相位混叠问题,长上下文需频率缩放或位置插值。RoPE不旋转V,无学习参数,是LLM中关键的位置编码方法。
从GPT-2到Kimi K3,七年参数增长22580倍,核心是解决记忆体有限问题。架构演进从KV缓存、线性注意力到DeltaNet、Gated DeltaNet、KDA,逐步优化读写效率。Kimi K3结合多头潜在注意力、混合专家模型和注意力残差,实现高效存储与计算,突破规模限制。
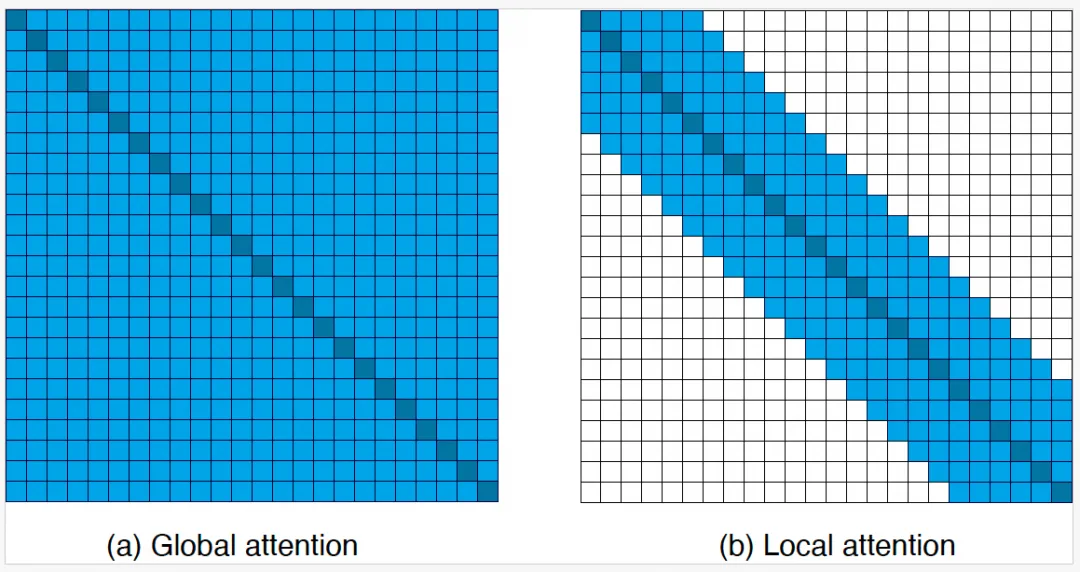
阿里团队提出TF-MossFormer,一种时频域单通道语音分离混合Transformer框架,通过结合局部滑动窗口注意力与全局注意力,并加入卷积门控机制,协同捕捉语音的细粒度局部连续性与长距离全局依赖。在WSJ0-2Mix基准上,该模型以多种规模超越现有方法,小模型高效,大模型达新SOTA,验证了局部与全局协同建模在语音分离中的有效性。
大语言模型(LLM)自1980年代的分布式表示发展至2017年的Transformer架构,展示了在大规模数据和算力下简单规则的有效性。通过自回归框架,模型学习预测下一个词,逐步掌握语言规律。注意力机制和生成式预训练提升了模型能力,使其在无监督学习中吸收大量知识。对齐技术确保模型输出符合人类价值观,最终形成智能对话助手。
Core Automation,由OpenAI前科学家创办,在显存效率上取得重大突破,可能颠覆大模型的算力瓶颈。新算法的优化有望提升显卡使用效率,帮助中小公司降低成本。业内对注意力机制的改进和缓存技术的应用表示关注,若成功,可能导致大厂硬件贬值。尽管存在质疑,AI行业对这种创新充满期待。
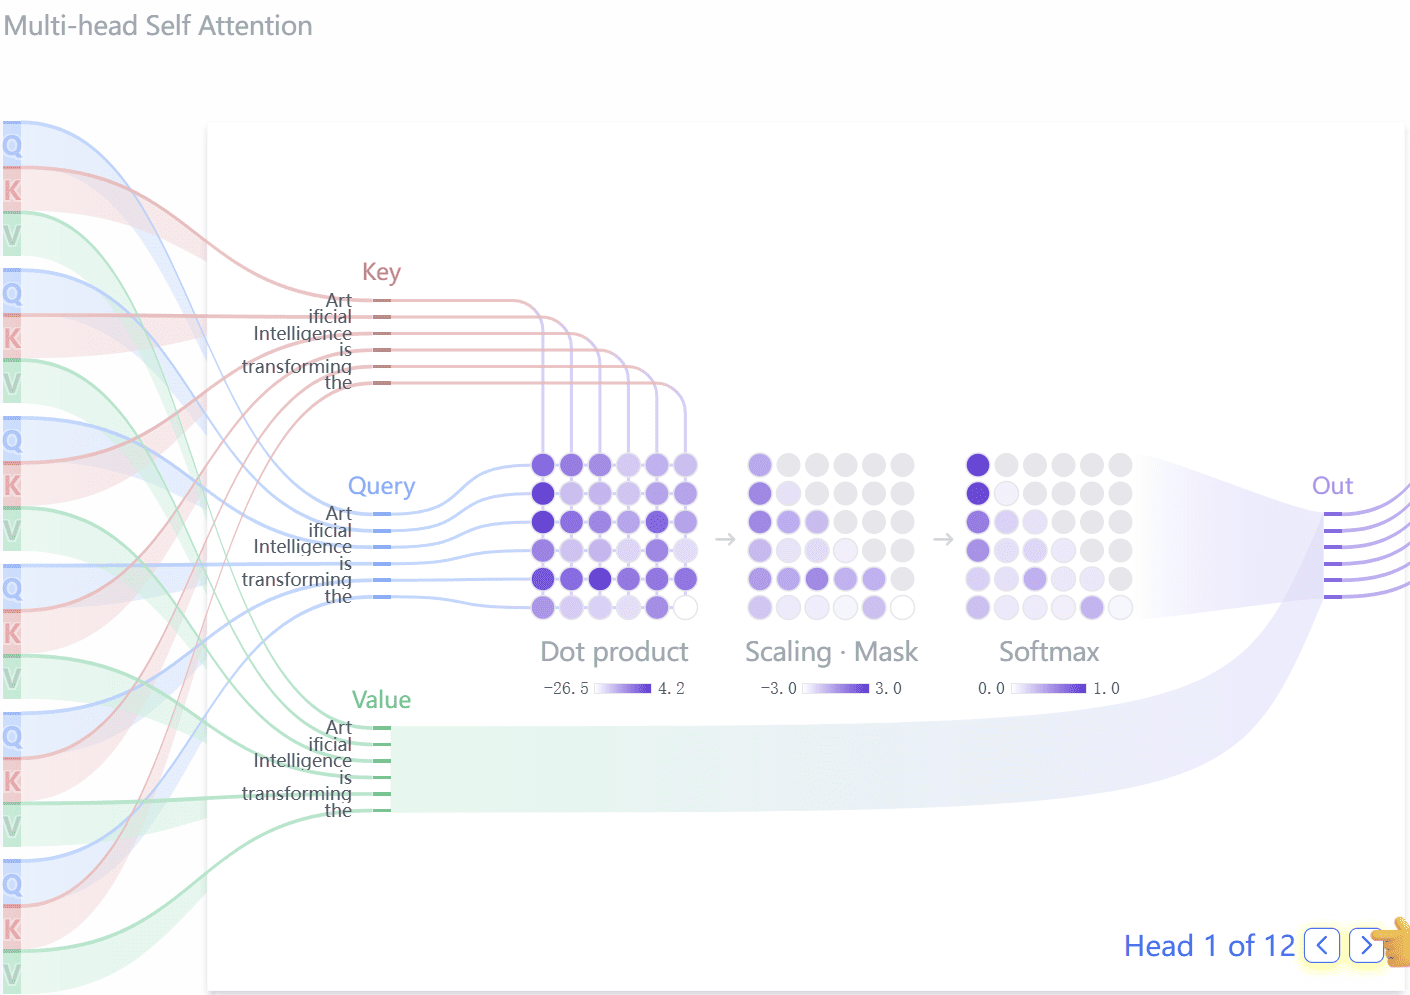
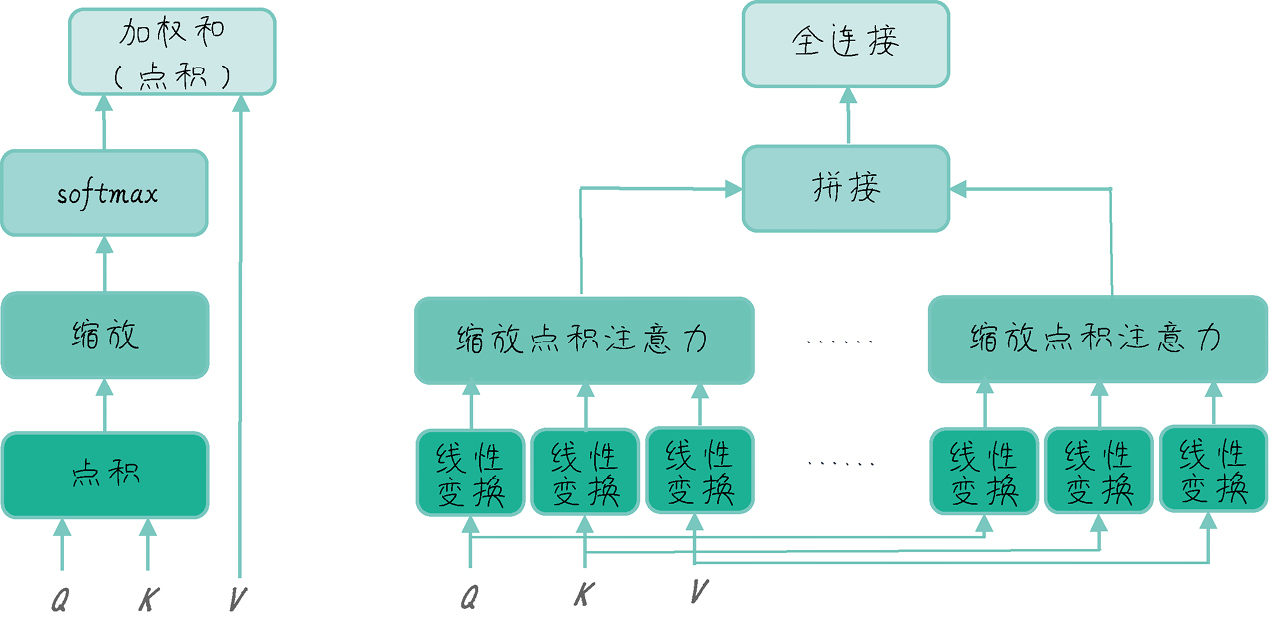
本文介绍了Transformer模型的注意力机制及其背景。传统的卷积神经网络(CNN)和循环神经网络(RNN)在处理长距离依赖时存在局限,而Transformer通过自注意力机制解决了这些问题。模型使用位置编码来区分词序,核心是通过Query、Key和Value计算注意力权重。多头注意力允许模型并行处理不同关系,增强表达能力。混合专家模型(MoE)通过选择部分专家参与计算,提高了效率和性能。
FlashAttention通过分块在线softmax优化Transformer的注意力机制,显著降低显存和计算速度瓶颈。它采用流式计算,避免物化整个分数矩阵,减少内存访问,提高效率。实测表明,FlashAttention在长序列处理上具有显著优势,并在反向传播时通过重算降低显存需求。
本文介绍了大型语言模型(LLM)的工作原理,重点在于transformer架构的核心机制,包括分词、嵌入、位置编码和注意力机制。LLM通过将文本转换为整数序列,利用嵌入矩阵赋予这些整数含义,并通过注意力机制在token之间交换信息。模型的训练依赖于预测下一个token,架构的不同主要体现在训练权重和配置选择上。
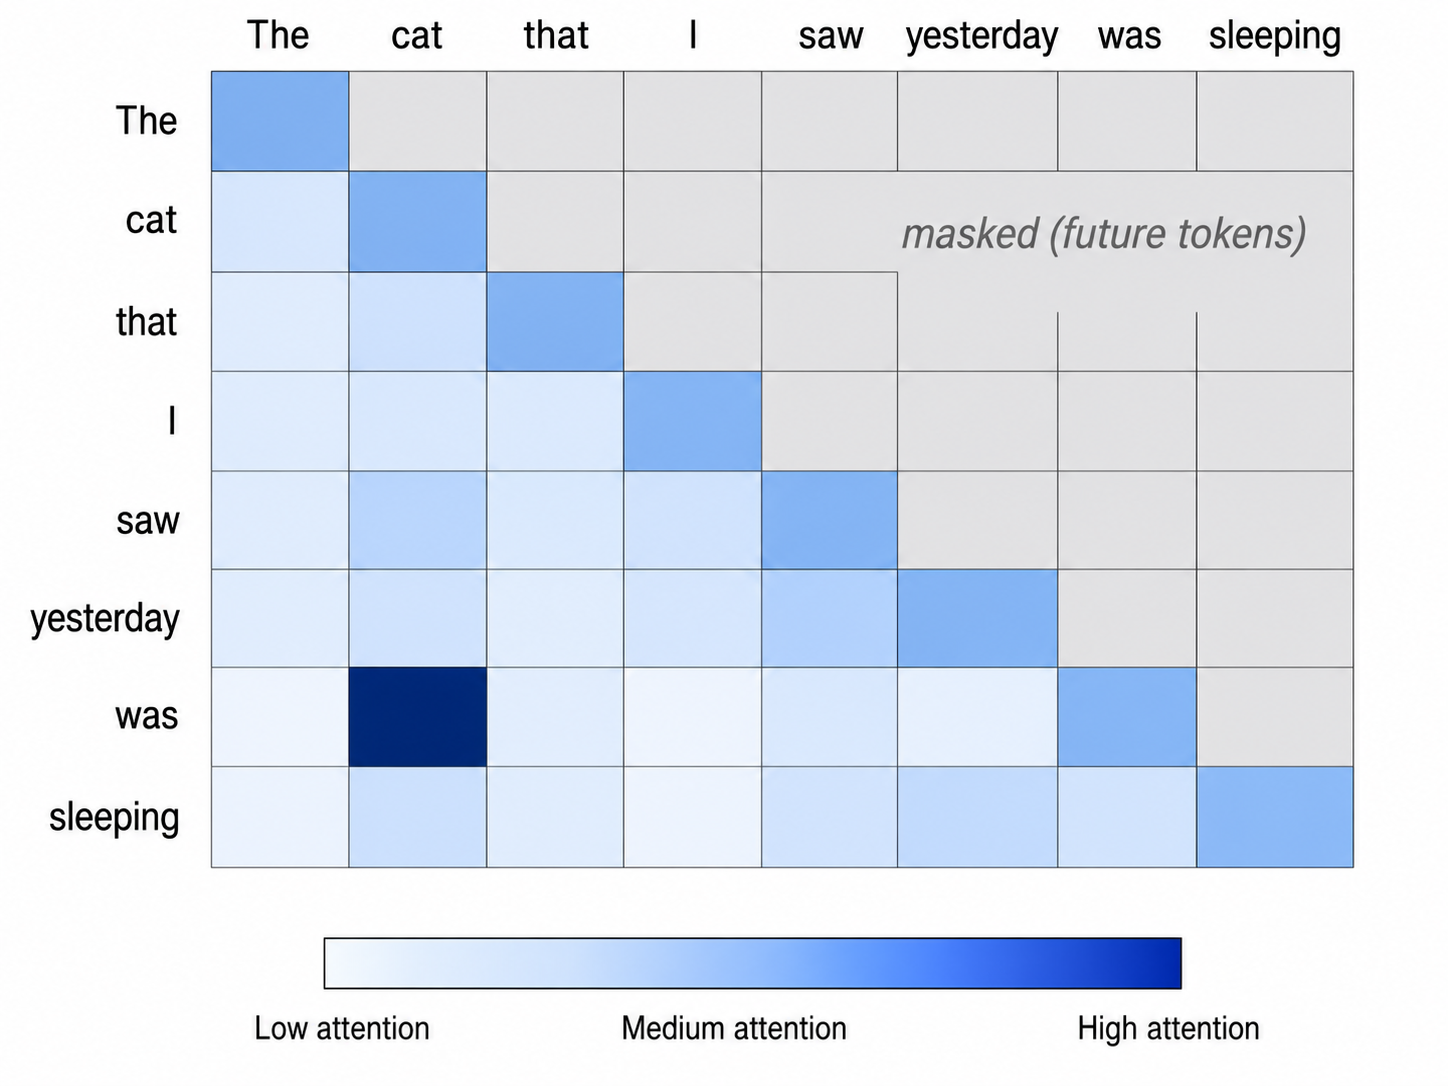
这篇文章介绍了Transformer模型的结构和关键概念。Transformer通过注意力机制替代RNN,解决了序列建模中的上下文依赖问题。引入位置编码使模型能够感知token的位置信息,注意力机制包括自注意力和交叉注意力。编码器和解码器结构相似,但解码器使用因果掩码以确保生成序列的自回归特性。整体上,Transformer实现了高效的并行计算和长距离依赖处理。
Transformer模型在语言描述的简洁性上表现优异,能够用更小的模型表达复杂语言,展现出指数级和双指数级的优势。其注意力机制提高了信息处理的效率,但验证其能力非常困难,达到EXPSPACE完全级别。
完成下面两步后,将自动完成登录并继续当前操作。