

基于Spark的1996-2022多赛季NBA球员数据分析
内容提要
本文介绍了基于Python和Spark的NBA球员数据分析项目,包括实验环境和数据准备步骤,使用Spark进行数据分析,以及使用Plotly库进行数据可视化和Flask搭建本地Web服务器展示可视化结果。
延伸解读
技术栈选择与工程实践
项目采用Spark进行分布式数据分析,结合HDFS存储数据,并使用Plotly生成交互式可视化,最后通过Flask搭建Web服务器展示结果。这种技术组合适合处理大规模数据集,并提供了从分析到展示的完整流程。读者可以借鉴其架构设计,尤其是在数据预处理、Spark SQL操作和可视化集成方面。
数据预处理的关键步骤
文章详细展示了数据预处理过程,包括创建选秀标识列、转换日期类型、标准化国家名称等。这些步骤确保了数据质量,为后续分析奠定基础。例如,将'Undrafted'替换为NaN并转换选秀年份为日期类型,便于时间序列分析;标准化国家名称有助于准确统计国际球员比例。
分析视角与业务洞察
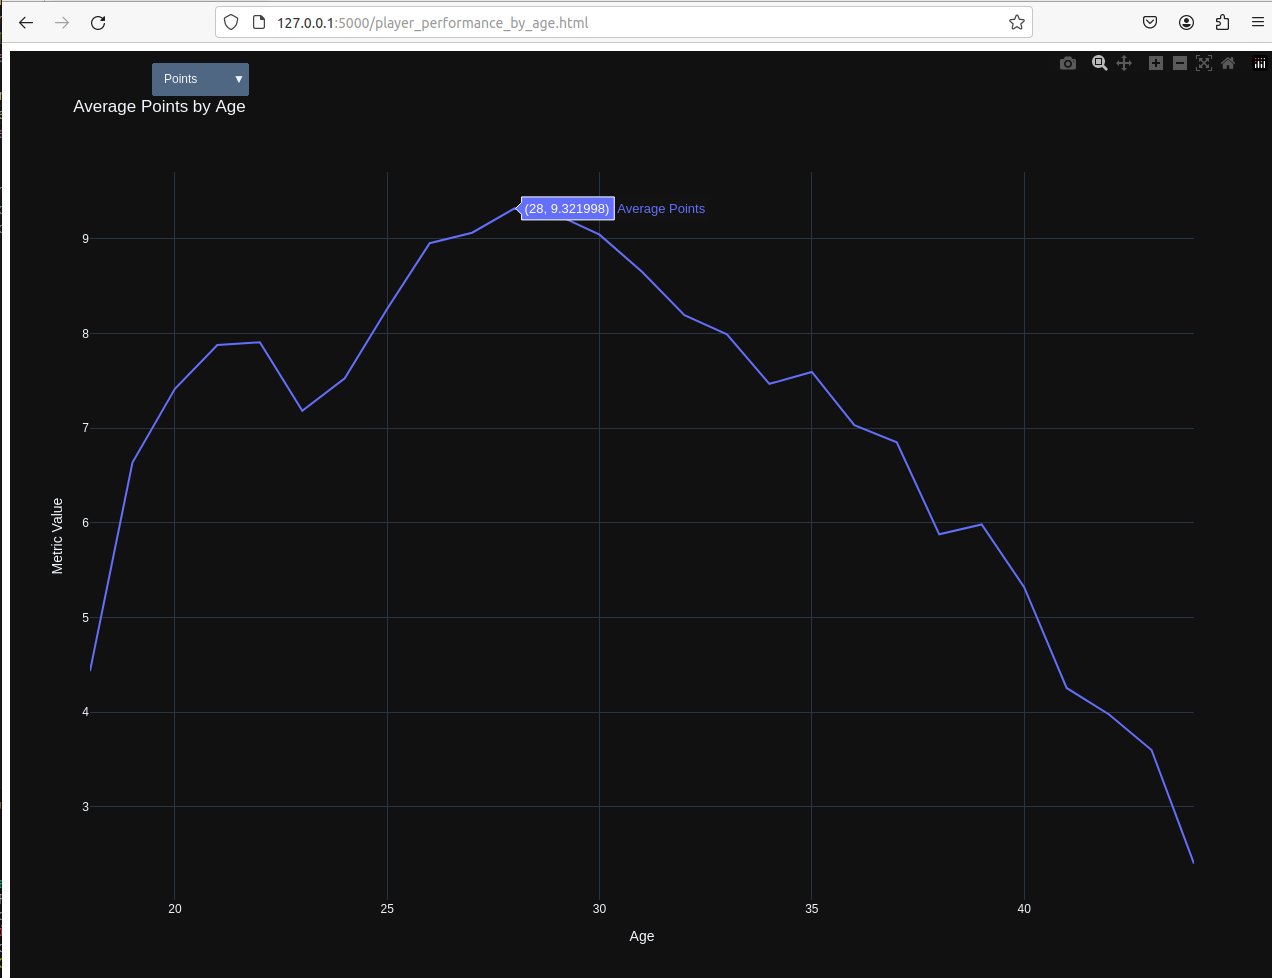
项目设计了多个分析问题,如年龄对表现的影响、身体指标与助攻篮板的相关性、国际球员比例变化等。这些分析不仅具有技术演示价值,还能揭示NBA的发展趋势,例如小球化、年轻化和国际化。读者可以学习如何从数据中提取有意义的业务洞察,并利用可视化有效传达。
可视化与交互设计
使用Plotly生成交互式图表,如带有下拉菜单的散点图和柱状图,增强了数据探索的灵活性。Flask服务器将多个HTML文件整合到一个页面中,方便用户浏览。这种设计模式适用于需要展示多个分析结果的项目,提升了用户体验。
Q&A
这篇文章使用了哪些技术进行NBA球员数据分析?
文章使用了Python和Spark进行NBA球员数据分析,结合Flask搭建Web服务器和Plotly进行数据可视化。
数据集包含哪些NBA球员的基本信息?
数据集包含球员姓名、球队缩写、年龄、身高、体重、大学、出生国家、选秀年份、比赛次数、场均得分等21个属性。
如何处理NBA球员数据中的缺失值?
文章中使用了布尔逻辑创建新列,替换缺失值,并将某些列转换为日期类型,以便进行后续分析。
文章中分析了哪些球员表现的影响因素?
分析了球员年龄对得分、助攻和篮板的影响,以及身高、体重与场均助攻和篮板之间的相关性。
如何使用Flask展示数据可视化结果?
使用Flask框架搭建本地Web服务器,通过渲染HTML模板展示可视化结果,用户可以通过链接访问不同的统计图。
国际球员在NBA中的占比变化如何?
文章指出,国际球员在NBA中的占比在过去几十年中稳步上升,显示出联盟的国际化成功。
