

FireAct:推进语言智能体的微调 [译]
内容提要
该文本仅包含参考文献列表和附录实验细节,未提供新的实质性文章内容,因此摘要保持不变。
延伸解读
微调为何能提升智能体表现
文章指出,现有语言智能体多依赖少样本提示和现成大模型,但大模型并非为智能体任务设计,提示学习支持有限。微调能让模型从更多样化的轨迹中学习,从而显著提升性能。例如,用GPT-4生成的500条轨迹微调Llama2-7B,在HotpotQA上精确匹配率提升77%;微调GPT-3.5也带来25%的提升。这表明微调是构建高效智能体的有效途径。
多样化数据与多方法微调的价值
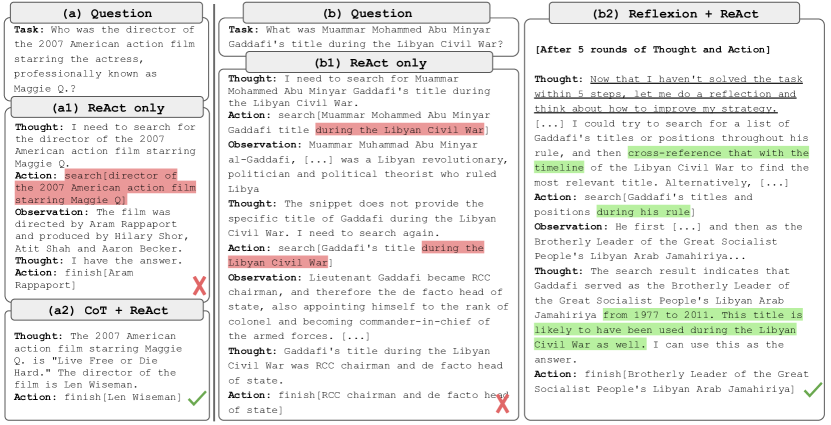
FireAct方法强调使用多种任务和提示方式生成的轨迹进行微调。实验显示,混合ReAct和CoT轨迹微调GPT-3.5,在HotpotQA上比仅用ReAct微调进一步提升。多方法微调还能让智能体灵活选择方法:简单问题用CoT,复杂问题用ReAct加反思。但方法组合的效果因基础模型而异,并非越多越好,需针对模型选择合适的数据混合比例。
微调带来的效率与鲁棒性优势
微调后模型不再依赖少样本示例,推理时间大幅减少。例如GPT-3.5微调后每次试验从9.0秒降至2.7秒,减少70%。面对嘈杂工具输出(如50%概率返回无结果或随机结果),FireAct模型性能下降幅度远小于提示方法,显示更强鲁棒性。这些优势使微调更适合对成本和稳定性要求高的实际应用。
实践中的权衡与局限
文章指出,提示更适合探索性任务,微调更适合明确的下游应用。选择模型时,GPT-3.5表现优于Llama系列,但开源模型在足够数据下可接近GPT-3.5,需在便利性与可控性间权衡。研究局限在于仅涉及问答任务和谷歌搜索工具,未来需扩展到更多任务和工具,并探索更复杂的智能体微调。
Q&A
FireAct 是什么?它主要解决什么问题?
FireAct 是一种针对语言智能体的微调方法,它通过结合多种任务和提示方法(如 ReAct、CoT、Reflexion)生成的智能体行为轨迹来微调大语言模型,以提升语言智能体的性能、效率和鲁棒性。它主要解决现有语言智能体过度依赖少样本提示和现成大语言模型(如 GPT-4)导致的性能不足、成本高、鲁棒性差等问题。
FireAct 微调相比提示方法有哪些具体优势?
FireAct 微调相比提示方法有多个优势:显著提升性能(如 Llama2-7B 在 HotpotQA 上提升 77%),减少推理时间(GPT-3.5 减少 70%),增强对嘈杂工具的鲁棒性(性能下降更小),并提高泛化能力(在 Bamboogle 上表现更好)。此外,微调后的模型能灵活选择提示方法,减少对少样本示例的依赖。
FireAct 是如何生成微调数据的?
FireAct 使用强大的大语言模型(如 GPT-4)通过少样本提示生成多样化的智能体行为轨迹。这些轨迹来自多种任务(如 HotpotQA、StrategyQA、MMLU)和多种提示方法(ReAct、CoT、Reflexion),并被统一转换为 ReAct 格式,用于微调较小的语言模型。
在 FireAct 实验中,不同基础模型(如 GPT-3.5、Llama2、CodeLlama)的微调效果有何差异?
实验表明,GPT-3.5 在提示和微调下均优于 Llama 系列模型,但微调后 Llama2-13B 可超越 GPT-3.5 的提示方法。CodeLlama 表现不一:CodeLlama-7B 优于 Llama2-7B,但 CodeLlama-13B 不如 Llama2-13B。模型规模越大通常效果越好,但 CodeLlama-34B 在仅 ReAct 微调时不如 13B,混合方法后反超。
FireAct 在多任务微调方面有什么发现?
多任务微调(混合 HotpotQA、StrategyQA、MMLU 数据)在 HotpotQA 和 Bamboogle 上保持性能,同时在 StrategyQA 和 MMLU 上显著提升。多方法多任务微调进一步提高了所有任务的表现,表明单一多任务智能体有潜力替代多个单任务智能体,且不会产生负面交互。
FireAct 的研究有哪些局限性?未来方向是什么?
局限性包括:仅针对问答任务和谷歌搜索工具,仅探索了三种提示方法(ReAct、CoT、Reflexion),多任务设置限于三个 QA 任务,最佳微调模型为 GPT-3.5。未来方向包括:扩展到更多任务和工具(如更多 API、网页、物理接口),研究更复杂的智能体微调(多角色、多上下文),探索大规模多任务微调,以及开发更合适的基准来评估智能体。
