本文介绍用Unsloth和QLoRA微调Llama 3 8B以实现自定义工具调用。仅靠提示工程难以稳定输出JSON,微调可从权重层面改变模型行为。教程涵盖在免费Colab T4上搭建环境、加载4位量化模型、配置LoRA适配器、构建含系统提示、用户查询和JSON输出的数据集,并用SFTTrainer训练。约10分钟完成,模型能对未见查询返回干净JSON,最后保存适配器。
Cloudflare 在 Workers AI 上发布开源决策模型 Clef 与 Clef-flash,可快速输出带概率的结构化分类结果,用于智能体决策,速度约为通用大模型两倍,支持图像与 64k 上下文。模型以 Qwen 为基座,采用非自回归直接评分,在多项基准测试中领先。Cloudflare 同时推出强化学习微调服务,支持客户定制模型。
研究测试语言模型通过自然语言传递树状表达式时的信息损耗:一模型生成应用题,另一模型提取表达式,以符号等价判定。结果显示通道有损且不对称,角色互换后准确率差达60.4个百分点;至少73.6%的失败源于生成端,难度取决于树结构;约3600条微调样本即可提升所有开源模型。
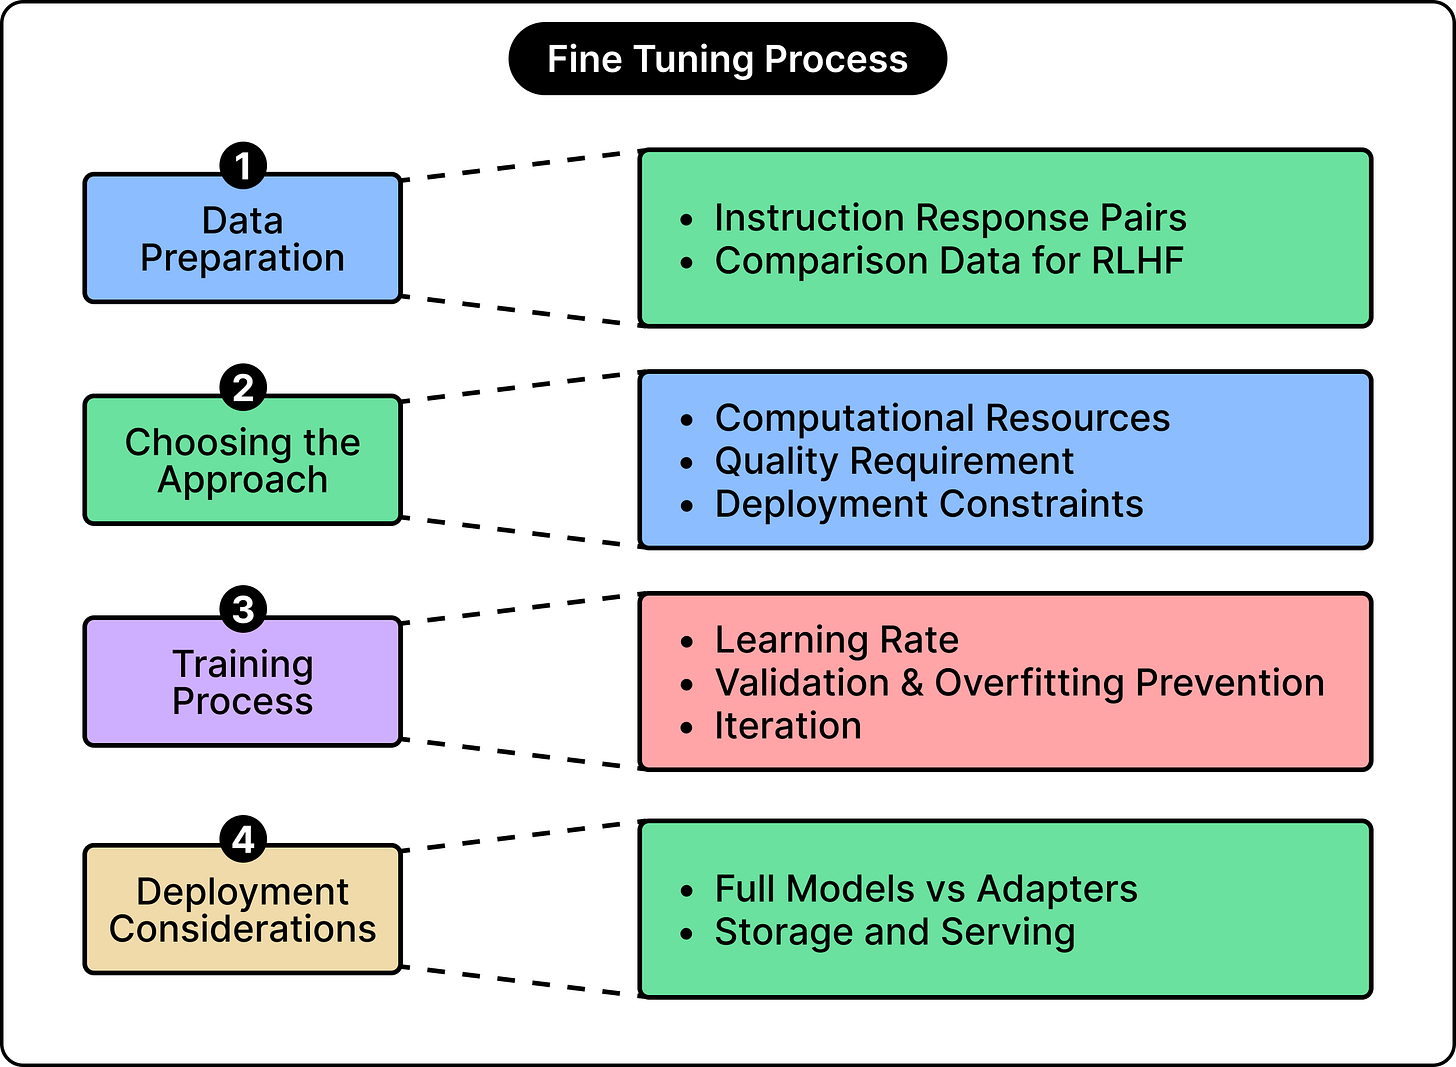
本文介绍模型定制与微调方法。提示和RAG只能引导模型,无法改变参数;微调可将期望行为固化为默认能力。LoRA冻结原权重,仅训练小型适配器,降低更新成本;QLoRA进一步以4位量化存储冻结权重,节省显存。训练需准备高质量示例,划分训练、验证、测试集,并调整秩、学习率、批次等参数,防止过拟合,最终以实际任务效果评估。
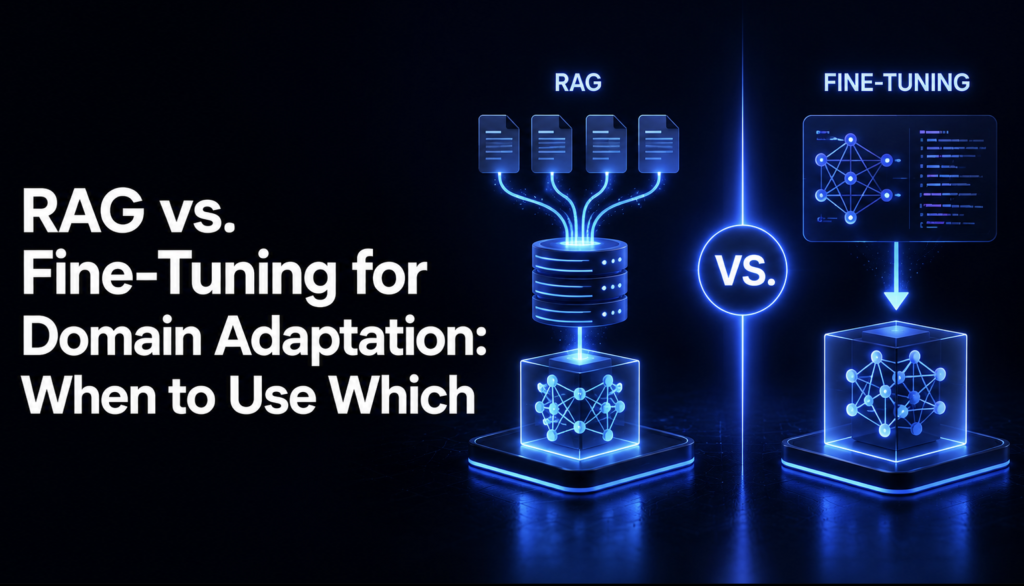
RAG通过检索外部知识增强模型输入,不改变权重,适合信息量大或频繁变化的场景,且答案可溯源。微调则训练模型权重,用LoRA等低成本方法让模型稳定掌握特定风格、格式或术语,但不擅长注入事实知识。约六成生产系统两者并用:RAG管“知道什么”,微调管“如何表现”。建议先上RAG,再针对持续行为问题微调。
Jev与Laya代表两类决策模型:Jev为闭源API,支持类型化输出与64K上下文,端到端延迟236毫秒起,无需微调;Laya为开源底座,单卡前向仅32.8毫秒,但零样本准确率仅0.362,需微调且窗口仅512 token。二者定位不同,选择取决于标注成本与API成本。核心启示是决策层与生成层应分离。
研究比较11种票据抽取系统,发现微调开源视觉语言模型在合成支票上F1超0.98,无需都用最大模型。选型应依据版式稳定性与错误代价:固定模板可用OCR加规则,版式多变再用VLM,样本多且字段稳定才值得微调。建议用真实文档分层测试,按字段设阈值,低置信度转人工,并保留规则基线和回归集。
AWS公开了π0机器人的微调流程,称动作误差降低约89%。但早期评测因训练回合混入评测导致误差虚高至96%,修正数据切分后才可信。文章强调,关键在于训练与评测回合严格隔离,且89%仅为离线误差,不等于闭环任务成功率。
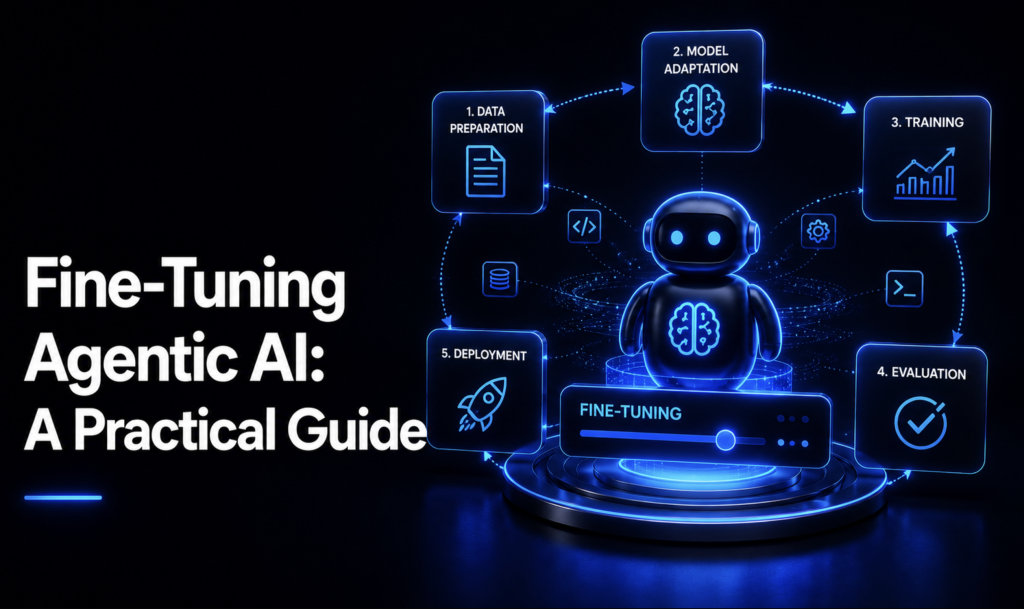
智能体AI微调需同时优化四个关键环节:训练数据、参数高效微调、运行时超参数和偏好对齐。以客服工单分流智能体为例,工具调用数据集须严格校验格式,采用QLoRA高效训练,调整温度与重试策略,并用DPO提升判断力。最后通过评估框架检测灾难性遗忘,决定是否上线。
该文推荐五门免费课程,构成从基础到实践的LLM学习路径:Karpathy的《Neural Networks: Zero to Hero》教构建神经网络和GPT;FSDL LLM Bootcamp讲生产架构;斯坦福CS336深入理论和扩展;Hugging Face课程练微调;DeepLearning.AI短课学部署和智能体。总计约80-120小时,建议按顺序或选择性学习,以实践为主。
本文介绍了在PyCharm中微调YOLO12、YOLO26和RF-DETR等SOTA目标检测模型的方法。作者先在COCO数据集上验证基线性能,再测试零样本在电缆损伤、骨折X光片和汽水瓶等专业数据集上的表现,结果接近零。经过10轮微调后,模型在电缆和汽水瓶任务上表现良好,但骨折检测仍具挑战。文章强调预训练模型不等于可直接部署,需根据任务选择合适模型。
本文介绍微软首席应用科学家Mariko Wakabayashi和高级应用科学家Zixiao Chen,他们专注于开发网络安全运营的智能体AI工作流,研究LLM驱动系统、智能体工作流及前沿AI应用,并涉及秘密检测、智能体安全系统及LLM微调,旨在提升AI效率、可扩展性和实际部署能力。
KTransformers v0.7.0发布,聚焦微调优化。支持直接加载原生FP8权重进行LoRA训练,将专家权重内存减半;新增AVX512 CPU后端,使AMD/x86平台可参与超大规模MoE微调;提供LoRA与全量微调选择,支持检查点保存恢复及CPU激活复用。附完整Cookbook指南,安装命令为pip install "ktransformers[sft]==0.7.0"。
本文探讨了提示缓存与微调在降低AI代理系统成本与延迟方面的差异及选择框架。提示缓存通过存储重复提示结果减少计算开销,适合静态文档和重复查询;微调通过LoRA等技术训练模型提升特定任务效率,适合格式一致性和个性化需求。混合策略可兼顾两者优势,实现高效架构。
本文介绍SmolLM3,一个3B参数的小型语言模型,强调其在特定任务上能以更低成本媲美70B模型。文章通过构建多语言客服工单路由器的实例,展示了SmolLM3的加载、推理、工具调用和微调方法,并指出其架构优势(如分组查询注意力、双模式推理)使其在资源受限环境下高效实用。
本教程介绍如何使用QLoRA对大型语言模型进行监督微调,以定制AI代理行为。通过Unsloth和Hugging Face工具,加载Qwen 1.5B模型,在本地用少量示例训练LoRA适配器,仅更新约4%参数,内存占用低。微调后模型响应更简洁、符合客服场景,适合资源有限环境。
研究显示,AI在回答文化问题时存在显著地域偏见,尤其偏爱日本和美国。通过分析八个大语言模型的三万道文化题,发现偏见主要源于微调阶段而非预训练。训练数据多的语言(如英语)回答多样性高,小语种则集中于少数国家。这种“日吹”现象反映了人类标注过程中的文化惯性,导致AI服务存在信息鸿沟。
本文系统介绍纯文本LLM监督微调(SFT)训练数据预处理全流程,涵盖数据收集、格式统一、清洗过滤、去重、分布评估、混合策略及打包管理。强调数据质量优于数量,提供多任务采样、语种比例、难度分布等实操建议,并结合客户案例说明,旨在提升模型微调效果。
本文介绍了大语言模型(LLMs)的预训练和微调概念。预训练通过大量数据学习语言基础,而微调则是在此基础上针对特定任务进行适应。微调分为完全微调和参数高效微调(PEFT),后者更节省内存且风险较低。尽管微调有效,但并非唯一解决方案,改进提示或检索增强生成(RAG)有时更为合适。
DynaMiCS是一种动态混合优化器,旨在多领域微调大型语言模型,提升目标领域性能的同时保持约束领域的性能。该方法通过短期领域特定探测估计交叉领域效应,并优化混合权重,以降低计算成本,实现更好的目标领域改进和约束满足。
完成下面两步后,将自动完成登录并继续当前操作。