

Mixtral 8x7B -- 混合专家模型(Mixtral of Experts) [译]
内容提要
Mistral AI发布开源稀疏专家混合模型Mixtral 8x7B,采用Apache 2.0授权。总参数467亿,每Token仅激活129亿,兼顾性能与成本。支持32k上下文、多语言及代码生成,多数基准超越Llama 2 70B且推理快6倍,可与GPT-3.5媲美。指令版MT-Bench得8.3分,幻觉更少、偏见更低。
延伸解读
稀疏专家架构如何平衡性能与成本
Mixtral 8x7B 采用稀疏专家混合(SMoE)架构,每层有 8 组专家参数,但每个 Token 仅由路由网络选择其中两组进行处理。这使得模型总参数达到 467 亿,而每 Token 实际激活的参数量仅为 129 亿。因此,其推理速度和计算成本与一个 129 亿参数的稠密模型相当,却能在基准测试中超越 Llama 2 70B。这种设计在保持高性能的同时显著降低了部署开销,为开源模型的高效化提供了新思路。
基准表现:超越 Llama 2 70B,媲美 GPT-3.5
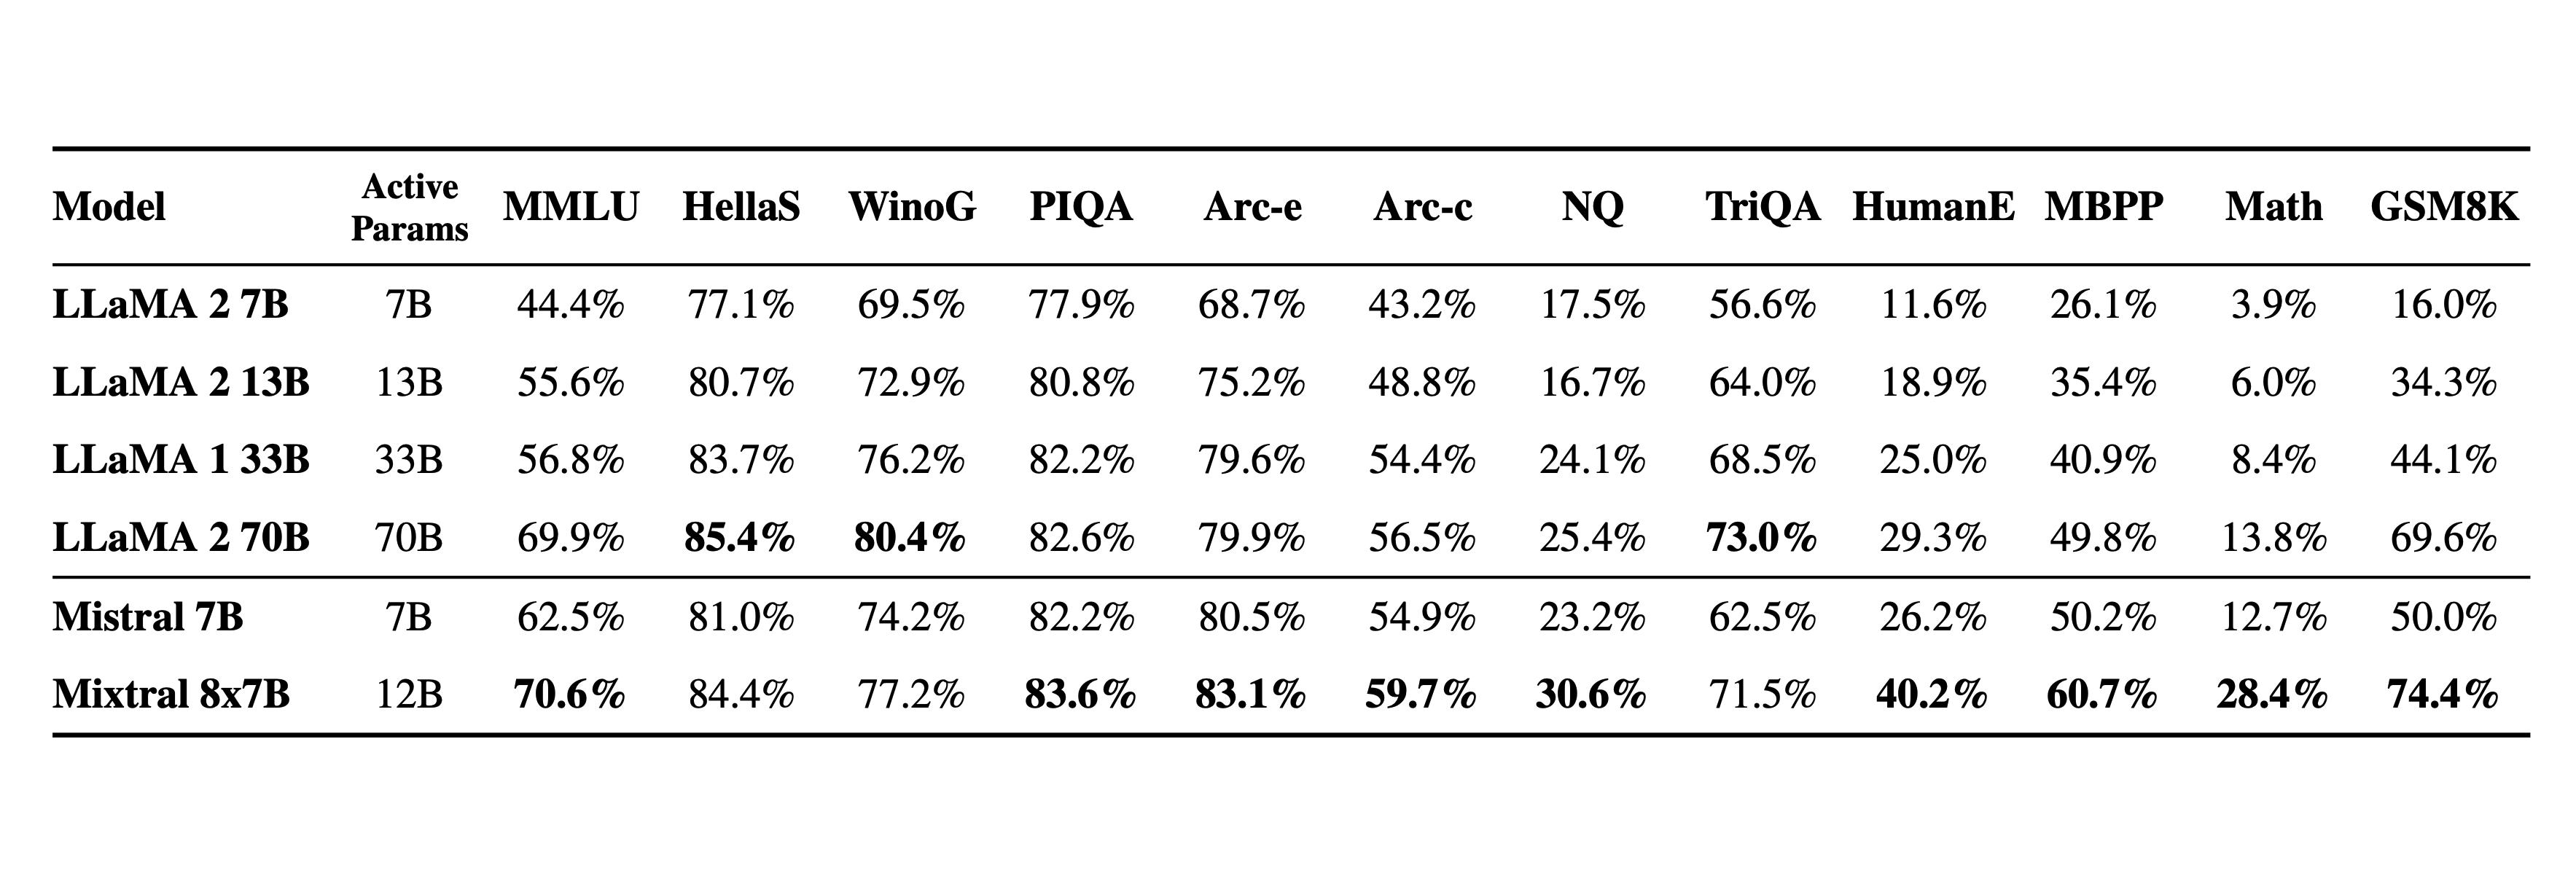
根据文章公布的对比结果,Mixtral 在大多数标准基准测试中不仅达到甚至超越了 Llama 2 70B 的水平,推理速度更是后者的 6 倍。同时,其表现可与 GPT-3.5 基础模型相媲美。在指令遵循方面,经过监督微调和直接偏好优化(DPO)的 Mixtral 8x7B Instruct 在 MT-Bench 上获得 8.30 分,成为当时最优秀的开源模型之一。这些数据表明,稀疏架构有望在开放权重模型中实现接近闭源商业模型的性能。
真实性、偏见与多语言能力
文章评估了模型在 TruthfulQA、BBQ 和 BOLD 上的表现。相较于 Llama 2,Mixtral 在 TruthfulQA 上的真实率更高(73.9% 对 50.2%),在 BBQ 测试中显示出更少的偏见,并在 BOLD 上展现出更多正面情绪。此外,Mixtral 精通英语、法语、德语、西班牙语和意大利语,并在代码生成任务中表现出色。这些特性使其适合需要多语言支持和内容安全性的应用场景。
使用注意:内容控制依赖提示与偏好调整
文章特别提醒,Mixtral 可以通过特定提示来排除某些输出,这对于需要严格内容控制的应用构建非常有用。恰当的偏好调整也能达到类似效果。但如果没有这样的提示或调整,模型将按照给定的指令行事,可能产生不受约束的内容。因此,开发者在部署时需根据实际需求设计提示或进行微调,以确保输出符合预期。同时,模型采用 Apache 2.0 许可,允许商业使用,但需遵守许可条款。
Q&A
Mixtral 8x7B 是什么模型?由谁发布?
Mixtral 8x7B 是 Mistral AI 团队于 2023 年 12 月 11 日发布的一款高品质稀疏专家混合模型(SMoE),采用 Apache 2.0 协议授权,开放权重。
Mixtral 8x7B 的稀疏专家混合架构是如何工作的?
Mixtral 是一个仅包含解码器的模型,其前馈块从 8 组不同的参数组(专家)中进行选择。对于每一层的每个 Token,一个路由网络会挑选两组“专家”处理 Token,并将它们的输出结果进行加法组合。这种技术让模型在增加参数数量的同时,有效控制了成本和延迟。
Mixtral 8x7B 的总参数和激活参数是多少?这对推理成本有什么影响?
Mixtral 总共有 467 亿参数,但每个 Token 只激活其中的 129 亿参数。因此,它在处理输入和生成输出时,速度和成本相当于一个 129 亿参数的模型,实现了高效推理。
Mixtral 8x7B 在性能基准上表现如何?与 Llama 2 70B 和 GPT-3.5 相比呢?
在多数基准测试中,Mixtral 8x7B 超越了 Llama 2 70B,且推理速度快 6 倍。其表现可与 GPT-3.5 相媲美,是目前最强大的具有宽松许可证的开放权重模型之一。
Mixtral 8x7B 支持哪些语言和功能?
Mixtral 8x7B 支持多种语言,包括英语、法语、意大利语、德语和西班牙语,并且在代码生成领域表现出色。它还能处理 32k 个 Token 的上下文。
Mixtral 8x7B Instruct 模型是什么?它的指令跟随能力如何?
Mixtral 8x7B Instruct 是专门优化的指令跟随模型,通过监督式微调和直接偏好优化(DPO)训练。在 MT-Bench 测试中得分高达 8.30,成为最优秀的开源模型之一,性能可与 GPT-3.5 媲美。
Mixtral 8x7B 在减少幻觉和偏见方面有什么表现?
相较于 Llama 2,Mixtral 在 TruthfulQA 测试中更加真实(73.9% 对比 50.2%),并且在 BBQ 测试中显示出更少的偏见。在 BOLD 测试中展现了更多的正面情绪,且各方面波动程度相似。
