

基于PyFlink的成人数据集分析
内容提要
本文介绍了使用Python和PyFlink进行数据清洗、分析和可视化的案例,包括数据集和实验环境、数据预处理过程、PyFlink的数据处理操作以及使用pandas和matplotlib进行数据可视化。
延伸解读
PyFlink 在数据分析中的角色
本案例使用 PyFlink 进行数据处理,包括创建执行环境、连接文件系统、读取 CSV 数据、按年龄段过滤、分组统计等操作。PyFlink 提供了流处理和表 API,适合处理分布式数据。但案例中设置并行度为 1,可能限制处理大规模数据时的性能。读者可关注 PyFlink 在数据清洗和分析中的实际应用方式。
数据预处理的关键步骤
预处理阶段使用 pandas 删除无用列(如 fnlwgt),将缺失值替换为 NaN,并去除字符串中的空格。这些步骤有助于提高数据质量,为后续分析奠定基础。需要注意的是,案例中未对缺失值进行进一步处理(如填充或删除),可能影响分析结果的准确性。读者在类似任务中应根据实际情况决定缺失值处理策略。
可视化方法与解读
案例使用 matplotlib 和 wordcloud 绘制了词云图、扇形图、柱状图和条形图,展示了国籍、职业、家庭关系、种族、性别、学历等属性的分布,以及不同年龄段性别比例和收入影响因素。可视化有助于直观理解数据,但需注意图表解读应结合业务背景,避免过度推断。例如,收入影响因素分析仅展示了 >50K 人群的属性分布,未进行统计检验。
技术栈与适用场景
案例结合了 Python 生态(pandas、matplotlib)与 PyFlink,适用于需要分布式处理的数据分析任务。实验环境为 Ubuntu22.04、Python3.10、PyFlink1.17.0。对于小规模数据,使用 pandas 可能更简便;而 PyFlink 更适合处理大规模数据或流式数据。读者可根据数据规模和实时性需求选择合适工具。
Q&A
如何使用PyFlink进行数据处理?
使用PyFlink进行数据处理需要创建执行环境、连接文件系统并读取数据,然后使用SQL接口进行数据分组和统计。
成人数据集包含哪些特征?
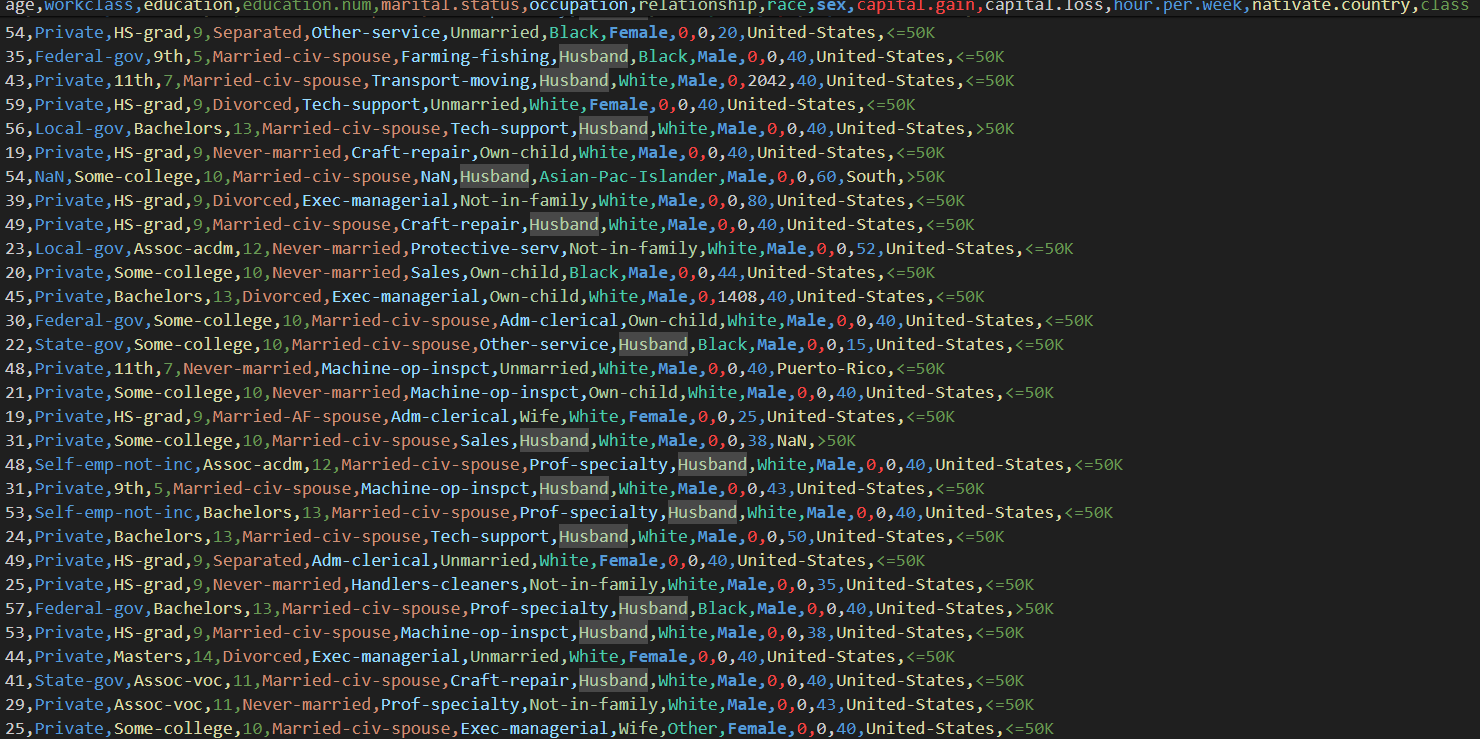
成人数据集包含14个特征,包括年龄、工作类型、教育水平、婚姻状况、职业、性别等。
数据预处理的主要步骤是什么?
数据预处理主要包括删除无用变量、填补缺失值和去除字符串中的空格。
如何使用Python进行数据可视化?
使用Python进行数据可视化可以利用pandas和matplotlib库,绘制词云图、扇形图和柱状图等。
实验环境的配置要求是什么?
实验环境要求使用Ubuntu22.04、Python3.10、PyFlink1.17.0、pandas和Matplotlib。
如何统计不同年龄段的性别比例?
可以根据年龄段对数据进行分组,并统计性别的比例,使用PyFlink的SQL接口进行操作。
